
 Better Mistakes



音乐
暂未播放
数学公式
- 1第一份文档:标记语法、编译与 watch
- 2代码模式:值、类型与控制流
- 3函数与 content:一切都是函数调用
- 4set 与 show:样式是规则,不是命令
- 5字体与中文排版
- 6页面与布局:盒子、网格与浮动
- 7context、计数器与状态:Typst 如何“多遍”编译
- 8数学公式本文
- 9图、表、代码与交叉引用
- 10参考文献:BibTeX、Hayagriva 与 GB/T 7714
- 11数据驱动:用一份 YAML 生成中英文简历
- 12作业模板:模块、多文件与条件编译
- 13幻灯片与绘图
- 14生态:Typst Universe 与第三方包
- 15用 Rust 写一个 WebAssembly 插件:按拼音排序术语表
- 16导出、工具链与 CI
我从自己的线性代数笔记里挑了三个公式:最小二乘的正规方程解、SVD 的外积展开,还有一个 的矩阵乘法,用 Typst 重新排了一遍。三个公式十来行源码,编译出来是下面这样,而且它们已经带着 (0.1)、(0.2)、(0.3) 的编号(为什么是 0,后面讲)。这一篇我把 Typst 的数学模式从头跑一遍:怎么写,怎么对齐,哪里和直觉不一样,最后写出 xuan 里负责“按章编号、引用不串章”的 math.typ。
这一篇结束时你会有一个新文件 src/math.typ,是最终版(41 行,文中完整展示)。lib.typ 和 src/base.typ 仍是中间版本:lib.typ 加一行 import,base.typ 加一行 import 和一行 show: math-rules,都在文中给出。lab/ch08/ 下 9 个文件全部通过 make ch08。
仓库 HEAD 的 base.typ 还多 import 了 figure.typ 和 code.typ(第 9 篇才讲),所以和前面几篇一样,先把仓库里的 src/ 整个拷过来,把那两个文件当黑盒。
前置:第 7 篇(context、计数器、show ref 和 el.location())。这一篇的编号机制是第 7 篇定理环境的方程版,我不会重讲计数器本身。
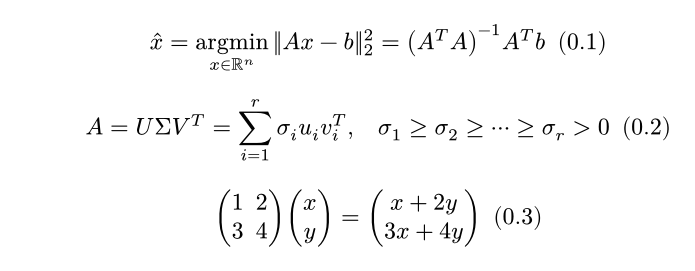
先看这三行是怎么写的
lab/ch08/fig-math.typ(源文件)就是上面那张图:
// A small gallery rendered as one PNG for the post.#import "@local/xuan:0.1.0": *#set page(width: auto, height: auto, margin: 12pt)#show: xuan-base#set text(size: 12pt)
$ hat(x) = argmin_(x in RR^n) norm(A x - b)_2^2 = (A^T A)^(-1) A^T b$
$ A = U Sigma V^T = sum_(i=1)^r sigma_i u_i v_i^T, quad sigma_1 >= sigma_2 >= dots.h.c >= sigma_r > 0$
$ mat(1, 2; 3, 4) vec(x, y) = vec(x + 2 y, 3 x + 4 y) $读一遍就能看出 Typst 数学语法的几个基本约定,后面每一节都是在展开其中一条:
- 单个字母是变量,
x y之间的空格只是分隔,不是乘号。sigma、Sigma、RR这类多字母名字是符号或函数。 _和^是下标和上标。紧跟着的括号是分组,括号本身不显示:_(x in RR^n)的括号不见了。- 但括号如果是被附着的对象,就照常显示:
(A^T A)^(-1)里(A^T A)的括号在图里还在。 argmin、norm、mat、vec是函数,参数用逗号隔开,mat里分号分行。>=自动变成 ,dots.h.c是居中的省略号 。
我用 Typst 0.15.1 编译 ch08 全部 9 个文件:
$ nix develop --command make ch08./scripts/chapter.sh ch08ok lab/ch08/alignment.typok lab/ch08/fig-math.typok lab/ch08/identifiers.typok lab/ch08/inline-vs-block.typok lab/ch08/latex-map.typok lab/ch08/math-functions.typok lab/ch08/matrices.typok lab/ch08/numbering.typok lab/ch08/operators.typ整章 0.79 秒(time make ch08,在 nix develop 里,含 9 个文件的编译)。32 行对照表那一页单独编译只要 0.129 秒。
数学模式:$ 的两种形状
第 1 篇我说过 Typst 有标记、代码、数学三种模式,$ 是进入数学模式的门。门有两种开法,由空格决定:
// Math mode: `$x$` is inline, `$ x $` (spaces inside) is a block equation.#import "@local/xuan:0.1.0": *#set page(width: 12cm, height: auto, margin: 1cm)#show: xuan-base
Inline: 级数 $sum_(k=1)^n k = n(n+1)/2$ 压在行内,上下限变成角标;块公式则展开:
$ sum_(k=1)^n k = n(n+1)/2 $ <gauss>
Typst 的 `$ ... $` 两侧有空格即为块公式。公式 @gauss 带编号,行内公式不带。用 `math.display` 与 `math.inline` 可以强制样式:$display(sum_(k=1)^n k)$。
// Text in math needs quotes; multi-letter names are otherwise symbols.$ "rank"(A) = dim "col"(A) $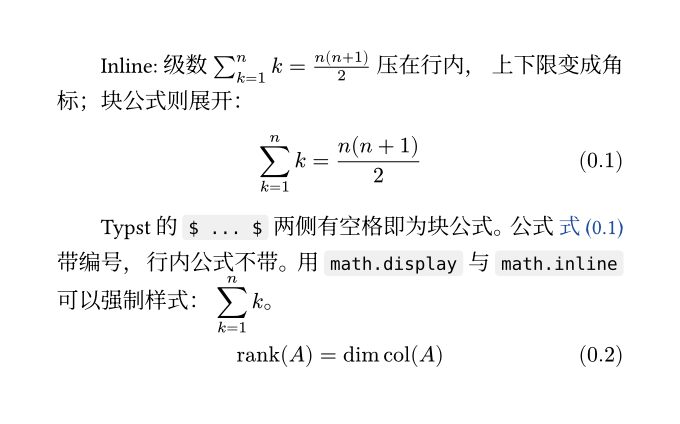
$...$ 内侧两边都是空格才是块公式。只有一边有空格会怎样?我没有凭文档猜,直接让 eval 把四种写法编译出来,读 equation 元素的 block 字段:
$ nix develop --command typst eval '("$x$", "$ x$", "$x $", "$ x $").map(s => eval(s).block)' --format yaml- false- false- false- true只有两边都有空格的那个是块公式;一边有空格的还是行内。顺带一提,typstyle 会把一边有空格的 $ x$ 规整成 $x$,类型不变,仍是行内。
同一个 sum_(k=1)^n k,行内排成 的角标形式(压住行高),块里才把上下限放在求和号上下。这是排版里“display style”和“text style”的区别,Typst 把它绑定在 block 上,需要时用 display(...)、inline(...) 对一小段强制切换。
公式本身也是一个元素。 $ ... $ 只是 math.equation 的语法糖,也可以直接调用函数,传 block: true 和 numbering。这在对齐那一节会用到。字体方面,xuan-cjk 里有一行 show math.equation: set text(font: fonts.math),公式统一用 New Computer Modern Math(第 5 篇讲过),所以图里的数学字体是 Typst 内嵌的,不依赖系统。
标识符、文本和符号
lab/ch08/identifiers.typ(源文件):
// In math, single letters are variables; longer names look up symbols.#import "@local/xuan:0.1.0": *#set page(width: 12cm, height: auto, margin: 1cm)#show: xuan-base
- 单字母:$x y$ 是两个变量,$x y z$ 里空格只是分隔。- 多字母:$alpha beta$ 是希腊字母,`$ab$` 查找名为 `ab` 的变量。- 符号与修饰:$arrow.r$、$arrow.r.double$、$lt.eq$、$times$、$dots.h$。- 引号里是文本:$"if" x > 0$;`#` 进入代码:$#(1 + 2) x$。- 转义与 Unicode:$\{ x \}$、$\u{2211}$。
#let v = $bold(v)$$ norm(v) = sqrt(v^T v) $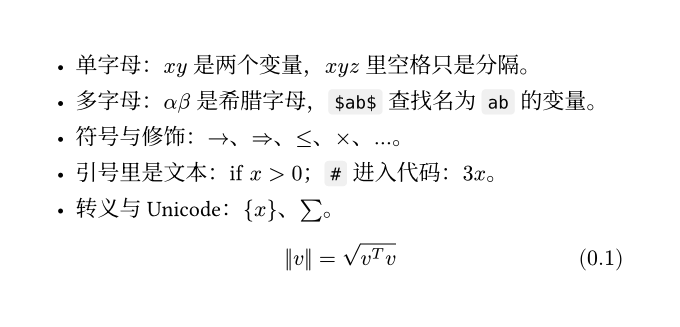
这一页最值得停下来的是多字母名字的查找规则。在数学模式里,一个多字母的标识符不会被拆成一串变量,而是被当作名字去查:先查数学作用域(alpha、sum、mat 都在这里),再查你的代码作用域(所以 #import "@local/xuan:0.1.0": * 之后,rank、tr 就能在公式里用了)。都查不到就报错。我把 $ab + 1$ 单独编译了一下(/tmp/p8/unknown-ab.typ):
error: unknown variable: ab ┌─ unknown-ab.typ:1:1 │1 │ $ab + 1$ │ ^^ │ = hint: if you meant to display multiple letters as is, try adding spaces between each letter: `a b` = hint: or if you meant to display this as text, try placing it in quotes: `"ab"`编译器两条提示正好对应两种需求:想要两个变量,写 a b;想要一个词,写 "ab"。"if"、"rank" 这类文本放在引号里,就是正体字,不会被当成变量斜排。顺便说,xuan 把 rank 做成了运算符(后面讲),所以 rank(A) 不用引号,而 "col"(A) 这种临时用一次的词仍然用引号。
符号的“点语法”。 arrow.r.double 是 arrow 符号加上 r、double 两个修饰。我找符号不翻文档,直接问编译器:
$ nix develop --command bash -c "typst eval 'repr(sym.chevron)' | jq -r . | head -8"symbol( ("l", "⟨"), ("l.curly", "⧼"), ("l.dot", "⦑"), ("l.closed", "⦉"), ("l.double", "⟪"), ("r", "⟩"), ("r.curly", "⧽"),typst eval 默认输出 JSON,所以用 jq -r . 把字符串还原。sym.arrow.r 同样能这样列出它的 51 个变体(double、long、bar、squiggly 等,我用 grep -c 数过)。注意 0.15.1 里没有 angle.l:
error: unknown symbol modifier ┌─ no-angle.typ:1:8 │1 │ $ angle.l u, v angle.r $ │ ^在 0.15.1 里尖括号叫 chevron.l / chevron.r,上面 repr 的输出里就有。这条命令适合“想批量看一个符号有哪些变体”的时候,比翻文档快。
最后两个入口:# 进入代码,$#(1 + 2) x$ 得到 ,# 后面的括号表达式整体作为一个值被插入;反斜杠转义 \{,\u{2211} 直接给 Unicode。
上下标、分式、根号和定界符
附着(attachment)规则在上一节的图里已经出现:_ ^ 后面跟一个字母、一个数字或一个符号,要多个就加括号分组。我把没放进 lab 的写法收在 /tmp/p8/tricks.typ 里,下面分段读,整个文件一次性编译:
#import "@local/xuan:0.1.0": *#set page(width: 12cm, height: auto, margin: 1cm)#show: xuan-base#set math.equation(numbering: none)// attachments$ attach(A, tl: 1, tr: 2, bl: 3, br: 4, t: 5, b: 6) quad x_(i+1)^(2n) quad A^T quad A^top quad A^(upright(T)) quad A^sans(T)$// augmented matrix$ mat(1, 2, 3; 4, 5, 6; augment: #2) $$ mat(1, 2; 3, 4; augment: #(vline: 1)) $// rows from arrays#let rows = ((1, 2), (3, 4))$ mat(..#rows) $$ mat(sigma_1, , ; , dots.down, ; , , sigma_r) $$ mat(delim: "|", a, b; c, d) = a d - b c $$ vec(1, 2, 3, delim: "[") quad vec(a, b, gap: #1em) $// cases spacing$ cases(1 & x > 0, 0) quad cases(1 & quad x > 0, 0) $$ cases(sigma_i^2 & i = j, 0 & i != j) $// bold$ bold(x) quad bold(upright(x)) quad upright(bold(x)) quad bold(A) quad bold(upright(A))$// frac$ (a + b) / c quad frac(a + b, c) quad (a+b)^2 / (c+d) quad a slash b $$ x' quad f'(x) quad f''(x) quad x^prime quad x^((n)) $$ lr(| x / 2 |) quad lr(chevron.l u, v chevron.r) quad {x in RR mid(|) x > 0} $$ P = A (A^T A)^(-1) A^T $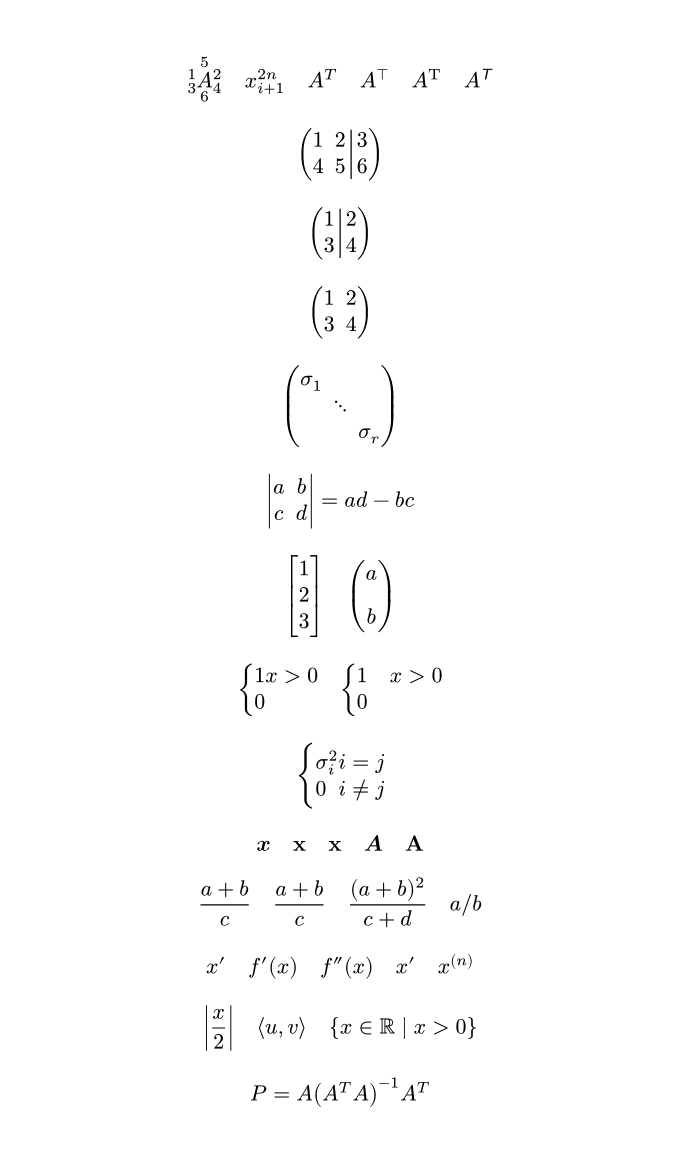
先看第一组。attach(A, tl: 1, tr: 2, bl: 3, br: 4, t: 5, b: 6) 一次给六个位置挂东西:左上、右上、左下、右下、正上、正下。x_(i+1)^(2n) 是日常写法,括号分组且不显示。转置有四种写法,我把它们放大看过(/tmp/p8/transpose.typ,24pt):A^T 是斜体 (字母 T 当变量),A^upright(T) 是衬线正体,A^top 是 符号,A^sans(T) 是无衬线斜体,不是正体。我最后在 la.typ 里选了 top,因为它不会和一个叫 T 的变量混淆。
分式用除号,括号自动消掉。 (a + b) / c 和 frac(a + b, c) 渲染完全一样(图里第一排前两个):除号两侧的括号组被当作分子分母,括号不显示。a / b 是竖排分式,a slash b 才是斜线 。如果你真想要显示的括号,括号里再套一层:x^((n)) 的结果是 ,外层括号被吃掉,内层留下,这和上一节 _(...) 是一回事。撇号 x' 与 x^prime 相同,连写 f''(x) 得到二阶导。
根号有两个函数:sqrt(x),以及带根指数的 root(3, x),对照表里会再出现。
定界符默认自动伸缩。 (...)、[...]、{...} 里包着高内容时,括号随之变大,lr(...) 是把这件事显式化:lr(| x / 2 |) 的竖线随分式拉高。mid(|) 让中间的竖线也跟着伸缩,用在集合记号 {x in RR mid(|) x > 0} 里。abs、norm、floor、ceil 是带对应定界符的简写,在 matrices.typ 里一起出现:
// vec, mat, cases and delimiters.#import "@local/xuan:0.1.0": *#set page(width: 12cm, height: auto, margin: 1cm)#show: xuan-base
$ A = mat(1, 2; 3, 4), quad x = vec(x_1, x_2, x_3), quad B = mat(delim: "[", 1, 0; 0, 1)$
$ mat(1, dots.h, 0; dots.v, dots.down, dots.v; 0, dots.h, 1) $
$ "sgn"(x) = cases( 1 & "if" x > 0, 0 & "if" x = 0, -1 & "otherwise", )$
// lr scales delimiters; abs, norm, floor, ceil are shorthands.$ lr((sum_i a_i / b_i)) quad abs(x) quad norm(v) quad floor(x/2) quad ceil(x/2)$$ {x in RR | x > 0} = lr({x in RR mid(|) x > 0}) $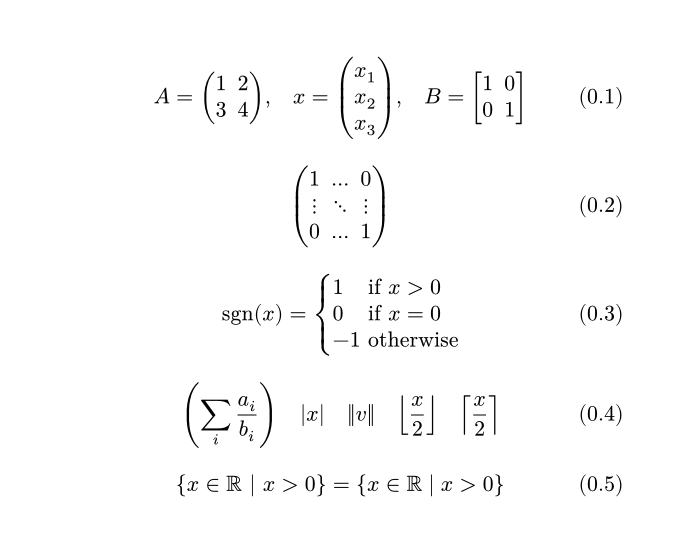
最后一行的两种集合写法在图里一模一样:内容不高的时候,自动伸缩和显式 lr、mid 没有差别,要看出区别得换成很高的内容(上一节 tricks.typ 里的 lr(| x / 2 |) 就是高的)。
矩阵、向量和 cases
mat 的约定是逗号分列、分号分行;vec 是只有一列。上面的 tricks.typ 里我试了几个不在 lab 文件里的用法,这里把每一个的结论读出来:
delim决定外框:mat(delim: "[", ...)是方括号,mat(delim: "|", ...)直接得到行列式的竖线,图里 就是这样排的。vec同样接受delim,还有gap调行距。augment画增广竖线:augment: #2在第 2 列后切一刀(线性方程组的增广矩阵),augment: #(vline: 1)用字典控制竖线位置。- 数组展开成矩阵:
mat(..#rows),其中rows是数组的数组,#让rows从代码进入数学,..展开成参数,每个内层数组是一行。这是“用代码生成矩阵”的入口。 - 留空:逗号之间什么都不写就是空格子,
mat(sigma_1, , ; , dots.down, ; , , sigma_r)是只写了对角线和 的对角阵,后面 SVD 那一节会用。
cases 有一个我花了一点时间才弄明白的细节:& 在 cases 里只是对齐点,不插空隙。tricks.typ 里 cases(1 & x > 0, 0) 渲染成 1x>0,两个东西挤在一起,而 cases(1 & quad x > 0, 0) 才分得开。matrices.typ 里的 "if" 前面看起来有间距,我没有细查是不是文本元素自带的,总之别指望它,写 quad。对照表第 23 行我一开始也犯了这个错,现在它写成不用 &、直接在值和条件之间放 quad 的形式。
对齐:& 和 \
lab/ch08/alignment.typ:
// `&` marks the alignment point, `\` ends the line.#import "@local/xuan:0.1.0": *#set page(width: 12cm, height: auto, margin: 1cm)#show: xuan-base
$ (a + b)^2 & = a^2 + 2 a b + b^2 \ & = a^2 + b^2 + 2 a b$
// Several columns: `&` alternates right- and left-aligned.$ x & = 1 & quad y & = 2 \ z & = 3 & quad w & = 4$
// An equation with a custom number, and without one.#set math.equation(numbering: none)$ f(x) = x^2 $#math.equation(block: true, numbering: "(A)")[$ g(x) = x^3 $]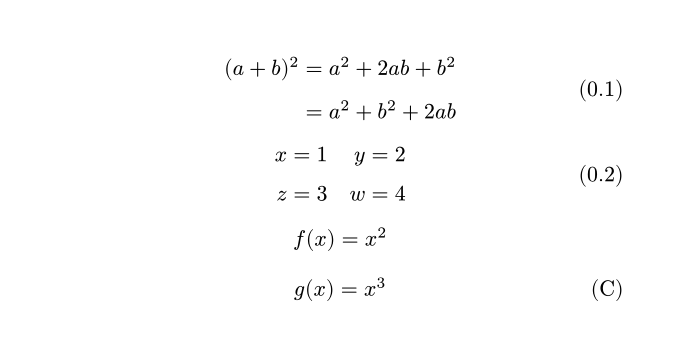
\ 换行,& 标记对齐点:第一个 & 左侧右对齐,右侧左对齐,所以 & = 把两行的等号对到一条竖线上。多个 & 交替地右对齐、左对齐,第二个公式就是两列“变量等于值”。
图里有两件事值得读出来。第一,一个块公式只有一个编号,不管它有几行,编号垂直居中。想给每一行单独编号,就得把每一行写成独立的公式。第二,最后一行:我给 g(x) 指定了编号格式 "(A)",渲染出来是 (C),不是 (A)。原因是计数器只数“有编号的”公式:前两个是 1、2,中间 numbering: none 的 f(x) 不计,g(x) 是第 3 个,字母编号 "A" 的第 3 个就是 C。这个细节下面讲编号时会用到。
运算符:op、limits 和 scripts
lab/ch08/operators.typ:
// Built-in operators, `op`, and limits vs scripts placement.#import "@local/xuan:0.1.0": *#set page(width: 12cm, height: auto, margin: 1cm)#show: xuan-base
$ sin x + log n + lim_(n -> oo) a_n + max_i x_i $
// xuan adds rank, tr, diag, sgn; argmin/argmax put the subscript below.$ rank(A) = tr(P), quad diag(1, 2, 3), quad sgn(x) $$ hat(x) = argmin_(x in RR^n) norm(A x - b)^2 $
// op makes new operators; limits controls where scripts go.#let Var = math.op("Var")#let esssup = math.op("ess sup", limits: true)$ Var(X) = EE[X^2] - EE[X]^2, quad esssup_(x in X) f(x) $
// scripts/limits force a placement for one expression.$ scripts(sum)_(i=1)^n a_i quad limits(integral)_0^1 f $$ integral_0^1 f(x) dif x quad sum_(i=1)^n quad product_(i=1)^n $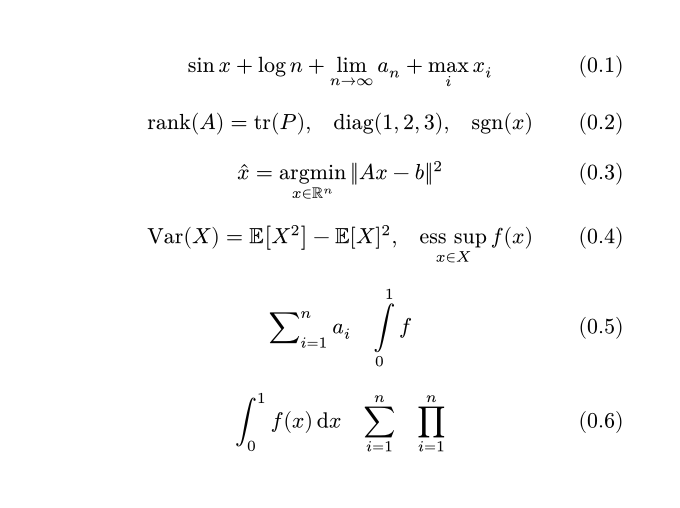
内置运算符(sin、log、lim、max、dim、det 等)是正体,和后面的变量之间有细空隙,lim、max 的下标默认放在正下方(limits)。sum、product、integral 这类“大算符”在块公式里:求和、乘积默认 limits,积分默认角标(scripts);inline-vs-block.typ 的图里可以看到,在行内公式里求和的上下限退成了角标。想破例,就用 scripts(...) 或 limits(...) 包一下,上面倒数第二行就是把 sum 强行改成角标、把 integral 强行改成上下限。
内置没有的运算符自己造:math.op("Var") 得到一个正体的 Var,math.op("ess sup", limits: true) 得到一个下标放在下面的运算符,名字里的空格会保留。xuan 的 math.typ 开头六行就是这样做的:
#let rank = math.op("rank")#let tr = math.op("tr")#let diag = math.op("diag")#let sgn = math.op("sgn")#let argmin = math.op("argmin", limits: true)#let argmax = math.op("argmax", limits: true)argmin 和 argmax 需要 limits: true,因为 的下标放在旁边就太丑了,图里第三行是下标放在 argmin 正下方的样子。这些名字被 lib.typ 导出,#import ...: * 之后既能在公式里用,也进了你的代码作用域:你的代码里如果有一个变量也叫 tr 或 rank,要么改名,要么换成 import ... as xuan 的写法(第 12 篇讲)。
微分号 dif 在上面最后一行出现:integral_0^1 f(x) dif x 得到正体的 ,不用像手写那样记住 \,\mathrm{d}。
变体、装饰、class 和代码
lab/ch08/math-functions.typ:
// Variants, decorations and code inside math.#import "@local/xuan:0.1.0": *#set page(width: 12cm, height: auto, margin: 1cm)#show: xuan-base
$ bold(A) quad upright(d) quad cal(L) quad bb(R) quad frak(g) quad sans(T) quad mono(x) quad italic(x)$$ cancel(x) / cancel(x) y, quad underbrace(1 + 2 + 3, "六") quad overbrace(a + b, "和")$$ x' quad x'' quad f'(x) quad x^((n)) quad x_i^2 quad sum_(i=1)^n x_i^2 $$ root(3, x) quad sqrt(x^2 + y^2) quad frac(a, b) quad a slash b $$ class("relation", ~) quad a class("binary", star) b $
// Code in math: `#` embeds, and loops produce math.#let terms = range(1, 5).map(k => $x_#k$)$ #terms.join($+$) = s $$ #for k in range(1, 4) [$#k^2$ ] $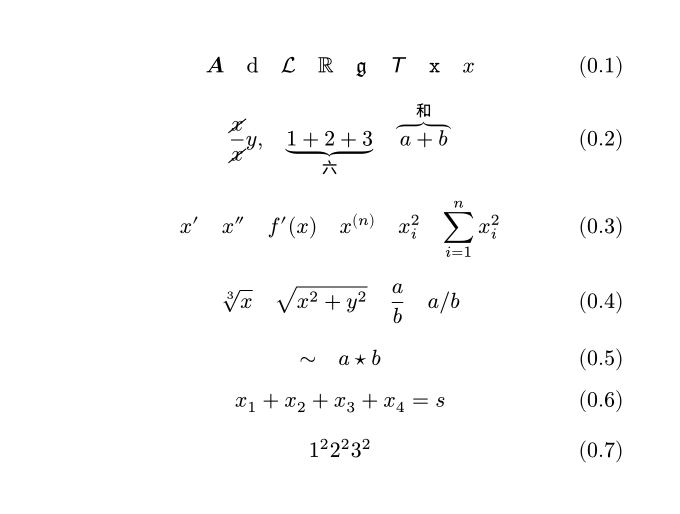
变体函数。 bold、upright、cal、bb、frak、sans、mono、italic 就是对应的字体变体。有一件事会咬到从别处来的人:bold(x) 得到的是粗斜体,因为数学里的字母默认斜体,bold 只加粗不改斜。想要“粗正体”的向量(很多教材用这个),要写成 bold(upright(x)),两层的顺序可以互换(tricks.typ 里的第三个和第二个渲染相同)。我在最后的 la.typ 里为此写了一行 #let vb(x) = $bold(upright(#x))$,后面会看到。
装饰。 我另写了一个 /tmp/p8/decorations.typ 看参数:
#import "@local/xuan:0.1.0": *#set page(width: 12cm, height: auto, margin: 1cm)#show: xuan-base#set math.equation(numbering: none)// class changes spacing, not the glyph.$ a x b quad a class("relation", x) b quad a class("binary", x) b quad a class("punctuation", x) b$$ cancel(x + y) quad cancel(x, angle: #30deg) quad cancel(x, cross: #true) quad cancel(x, inverted: #true)$$ overline(x + y) quad underline(x + y) quad overbracket(x + y) quad underbracket(x + y, "n") quad tilde(x) quad hat(x y)$$ underbrace(a + b + c, 3 "项") quad overbrace(a + b + c, "和" = s) $$ x^2 quad x_2 quad scripts(sum)_(i=1)^n quad limits(integral)_0^1 quad lim_(n->oo) quad limits(lim)_(n->oo) quad scripts(lim)_(n->oo)$$ "d"/("d"x) f(x) = lim_(h -> 0) (f(x + h) - f(x)) / h $$ vec(1, 2) times vec(3, 4) quad bold(u) dot bold(v) quad chevron.l u, v chevron.r$$ text(#red, x^2) quad #text(red)[$x^2$] $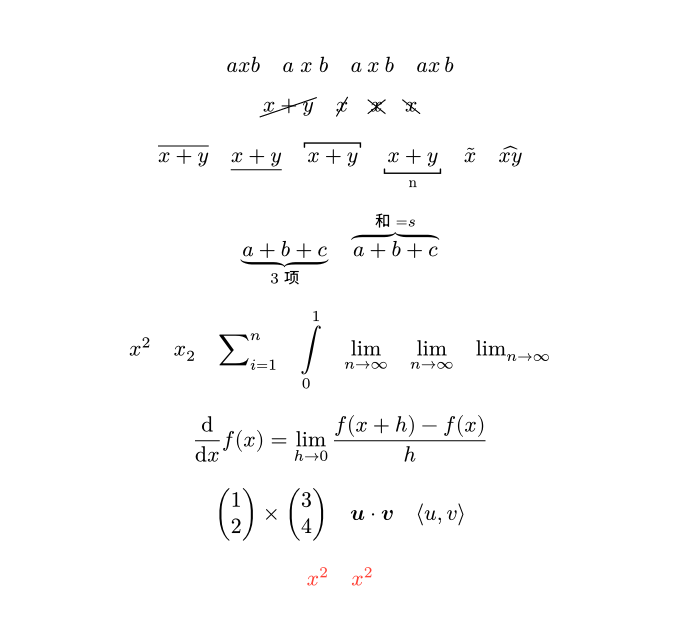
cancel(x, angle: #30deg)、cross: #true、inverted: #true是约分划线的三个开关,图里第二排依次是它们。underbrace(a, b)和overbrace(a, b)的第二个参数是标注,可以是文本,也可以是表达式("和" = s)。overline、underline、overbracket、underbracket、tilde、hat各自加一种装饰。text(#red, ...)和#text(red)[$...$]两种写法都能给公式上色,前者把#red当作参数写在数学里。
class:间距属于类别,不属于字形。 数学排版里每个原子有一个类别(普通、二元运算、关系、标点等),间距由类别决定。第一排我用同一个 x 做了四次实验:不写 class 的 a x b 紧挨着(普通),class("relation", x) 和 class("binary", x) 两侧都空开,class("punctuation", x) 在这个位置看起来和普通的没有区别。这是你自己造一个“看起来像运算符”的符号时需要的开关。
代码在数学里。 我另写了 /tmp/p8/code-in-math.typ:
#import "@local/xuan:0.1.0": *#set page(width: 12cm, height: auto, margin: 1cm)#show: xuan-base#set math.equation(numbering: none)// `#` embeds a code expression, and values can be math.#let terms = range(1, 5).map(k => $x_#k$)$ #terms.join($+$) = s $$ #range(1, 4).map(k => $#k^2$).join($,$) $$ #for k in range(1, 4) [$#k^2$ ] $$ #{ let n = 3 $x^#n$ } quad x^#(2 + 3) quad #(2 + 3)^x$// display and inline force a style for one expression.$ sum_(k=1)^n k = (n(n + 1)) / 2 quad display(sum_(k=1)^n k) quad inline(sum_(k=1)^n k)$// Text and colour inside math.$ f(x) := cases(x^2 & "if" x >= 0, -x & "otherwise") $$ text(#red, x^2) quad #text(red)[$x^2$] $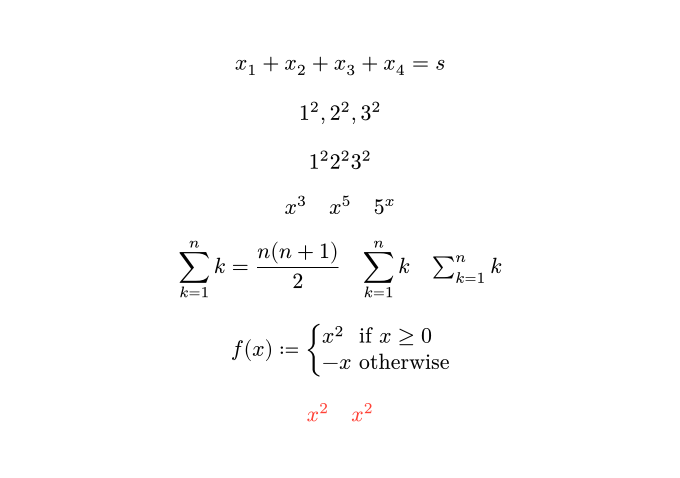
#terms.join($+$) 是我最喜欢的一类写法:数组里放的是数学内容,join 的分隔符也是数学内容,拼出 。第三行是个陷阱,也是 math-functions.typ 最后一行的写法:#for ... [$#k^2$ ] 循环体里那个空格在公式里没有保留,三个平方连成 1²2²3²;第二行用 map 加 join($,$) 就能拿到正确的分隔。我没有深挖空格被吃掉的原因,实验给出的结论是:要分隔符,用 join,不要指望循环体里的空白。
另一个提醒:x^#(2 + 3) 得到 ,#(2 + 3)^x 得到 ,# 后面的括号表达式整体作为一个值被插入,值本身不会再被拆开。
公式编号:为什么我自己写了一个 math.typ
前面所有渲染图里的公式都带着编号,(0.1)、(0.2),说明 xuan-base 已经替我们开了公式编号。Typst 自带的 math.equation 编号是全文连续的 (1)、(2)……笔记和教材要的是按章编号:第 2 章的第 1 个公式是 (2.1),引用时也显示 (2.1)。xuan/src/math.typ 就是做这件事的,全文 41 行,一次性贴出来:
// Math operators and chapter-wise equation numbering.
#let rank = math.op("rank")#let tr = math.op("tr")#let diag = math.op("diag")#let sgn = math.op("sgn")#let argmin = math.op("argmin", limits: true)#let argmax = math.op("argmax", limits: true)
/// "(<chapter>.<n>)" for the equation `el`, evaluated at its own location.#let equation-number(el) = { let loc = el.location() numbering( "(1.1)", counter(heading).at(loc).first(), counter(math.equation).at(loc).first(), )}
/// Show rules: number equations per chapter and make `@label` agree.#let math-rules(body) = { set math.equation(numbering: n => context numbering( "(1.1)", counter(heading).get().first(), n, )) show heading.where(level: 1): it => { counter(math.equation).update(0) it } show ref: it => { let el = it.element if el != none and el.func() == math.equation { let supp = if it.supplement == auto { el.supplement } else { it.supplement } link(el.location(), [#supp~#equation-number(el)]) } else { it } } body}它在 xuan 里的接线只有两处。lib.typ 新增一行:
#import "src/math.typ": argmax, argmin, diag, rank, sgn, trsrc/base.typ(中间版本)新增两行,一行 import,一行放在 show: theorem-rules 后面:
#import "math.typ": math-rules// ... show: theorem-rules show: math-rules这段代码分三块读。后面 /tmp/p8/ 里的实验文件都用 typst compile --ignore-system-fonts x.typ x.pdf 编译,再用 pdftotext 读文字;@local/xuan:0.1.0 靠 nix develop 设好的 TYPST_PACKAGE_PATH 找到。
1. set math.equation(numbering: ...):编号是个函数。 numbering 既可以是 "(1.1)" 这样的格式串,也可以是函数。内置的公式计数器 counter(math.equation) 只数公式,不知道章。所以我传一个函数:收到公式序号 n,再自己去读 counter(heading).get().first() 当章号,拼成 numbering("(1.1)", 章, n)。
2. show heading.where(level: 1):每章把公式计数器归零。 这条规则和第 7 篇定理环境里那条一模一样。没有它会怎样?我写了一个只保留“按章拼号”、去掉归零的 /tmp/p8/no-reset.typ:
#set heading(numbering: "1.1")#set math.equation(numbering: n => numbering( "(1.1)", counter(heading).get().first(), n,))= 一$ x = 1 $= 二$ y = 1 $$ pdftotext no-reset.pdf - | grep "("(1.1)(2.2)第二章的第一个公式叫 (2.2),因为公式计数器没归零,它是全文第 2 个。
3. show ref:这才是我折腾最久的地方。 现在公式编号对了,@label 引用呢?我做了两个只差一个词的对照实验。ref-context.typ 的编号函数带 context(和 xuan 现在的写法一样),ref-plain.typ 不带,其余完全相同,而且都没有 show ref:
#set math.equation(numbering: n => context numbering( "(1.1)", counter(heading).get().first(), n,))#set heading(numbering: "1.1")#show heading.where(level: 1): it => { counter(math.equation).update(0) it}= 一$ x = 1 $ <a>$ x = 2 $ <a2>= 二$ y = 1 $ <b>引用: @a @a2 @bref-plain.typ 就是把第一行的 context 去掉。编译后各取正文里的编号和引用行:
$ pdftotext ref-context.pdf - | grep -E "引用|\("(1.1)(1.2)(2.1)引用: Equation (2.1) Equation (2.2) Equation (2.1)
$ pdftotext ref-plain.pdf - | grep -E "引用|\("(1.1)(1.2)(2.1)引用: Equation (1.1) Equation (1.2) Equation (2.1)公式本身的编号两边一样,都对。差别在引用:带 context 的版本,@a(第 1 章第 1 个公式)在第 2 章里引用时显示 (2.1),章号成了引用者所在的章;不带 context 的版本则一切正常。
我对这个现象的解释是(这一句是推断,我没有读编译器源码):引用要把“公式的编号”重新显示一遍,函数形式的 numbering 会在被引用公式的位置上被调用,所以读到的章号是公式所在章。但函数里的 context 把求值推迟成了“一块带上下文的内容”,这块内容最后摆在引用的位置,counter(heading).get() 就在引用处求值了。
这就是编号发票的问题:发票号在开票那一刻就定了,之后谁来查,都应该看到同一个号,而不是按查询人所在的柜台重新编一遍。xuan 的做法是 show ref 里不再依赖“显示时求值”,而是直接取被引用元素的位置:
let el = it.element// ...link(el.location(), [#supp~#equation-number(el)])equation-number(el) 里 let loc = el.location(),然后用 counter(heading).at(loc) 和 counter(math.equation).at(loc) 算编号,答案只由公式自己的位置决定,不管谁调用。
上面的对照实验也说明,xuan 的编号函数里那个 context 对默认的 @label 是多余的:去掉它,默认引用就能给出正确的章号。show ref 仍然有用:
- 默认引用不是蓝色链接。我在
ref-plain.typ前面加了一行#show link: set text(fill: red)再编译成 PNG(/tmp/p8/v4.typ),三个引用仍是黑字,规则show ref里显式调用的link(...)才把xuan-base里的链接颜色带进来。 xuan在 supplement 和编号之间放了~(不换行空格),保证“式”和(2.1)不会在行尾断开。这是代码里写的行为,我没有单独去量默认引用用的是哪种空格。- 它能和第 7 篇的定理引用共存:两条
show ref规则互不匹配时各自else { it }放行。我编译了/tmp/p8/both-refs.typ(一个定理、一个引理、各夹一个公式,章号 1 和 2):
#import "@local/xuan:0.1.0": *#show: xuan-base= 一#theorem[$a = b$.] <t1>$ x = 1 $ <e1>= 二#lemma[$c$.] <l1>$ y = 2 $ <e2>见 @t1、@e1、@l1、@e2。$ pdftotext both-refs.pdf - | grep 见见 定理 1.1、式 (1.1)、引理 2.1、式 (2.1)。四个引用的章号和序号都对。
supplement:“式”从哪里来。 lab/ch08/numbering.typ 把上面这些放在一起:
// Equation numbers per chapter, labels, and supplements (set by xuan-base).#import "@local/xuan:0.1.0": *#set page(width: 12cm, height: auto, margin: 1cm)#show: xuan-base
= 第一章$ A x = b $ <eq-ls>$ A^T A x = A^T b $ <eq-normal>
= 第二章$ x^+ = (A^T A)^(-1) A^T b $ <eq-pinv>
由 @eq-ls 得 @eq-normal,再得 @eq-pinv。第二章的编号从 1 重新开始,且引用显示的是公式所在的章,而不是引用所在的章。
#ref(<eq-normal>, supplement: [式])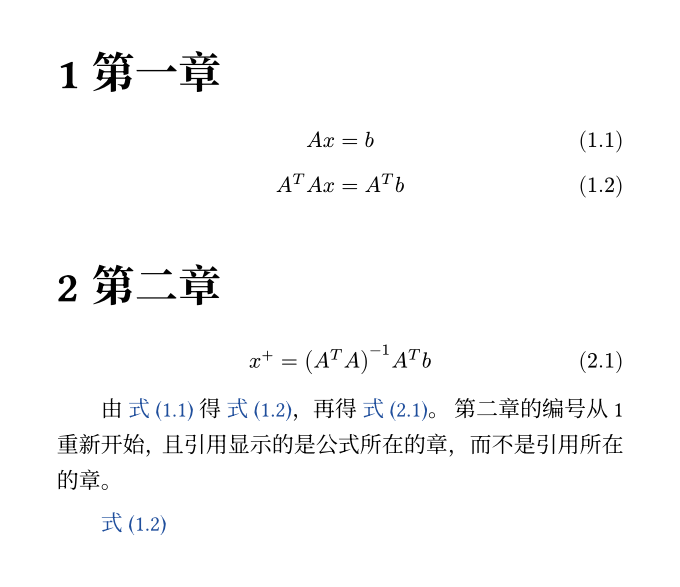
@eq-ls 得到 式 (1.1):补语“式”是 Typst 按文档语言给 math.equation 配的默认 supplement(xuan-base 把 text.lang 设成 "zh";英文是 Equation,我在下面实验里看到了)。我又做了两个实验,supplement-zh.typ 和 supplement-en.typ,读 pdftotext 输出:
supplement-zh.typ:
#import "@local/xuan:0.1.0": *#show: xuan-base= 一$ x = 1 $ <a>见 @a,#ref(<a>, supplement: [公式]),#ref(<a>, supplement: none)。#set math.equation(supplement: [公式])$ y = 2 $ <b>再见 @b 与 @a。supplement-en.typ:
#import "@local/xuan:0.1.0": *#show: xuan-base.with(lang: "en")= One$ x = 1 $ <a>See @a, #ref(<a>, supplement: [式]), #ref(<a>, supplement: none),#ref(<a>, form: "page").#set math.equation(supplement: [Eq.])$ y = 2 $ <b>Then @b and @a.$ pdftotext supplement-zh.pdf - | grep -E "见|再见"见 式 (1.1),公式 (1.1), (1.1)。再见 公式 (1.2) 与 式 (1.1)。$ pdftotext supplement-en.pdf - | grep -E "See|Then"See Equation (1.1), 式 (1.1), (1.1), Equation (1.1).Then Eq. (1.2) and Equation (1.1).三种改法的行为:#ref(<a>, supplement: [公式]) 只改这一次引用;supplement: none 去掉补语;#set math.equation(supplement: [公式]) 改的是之后每个公式元素自己的 supplement,所以 @b 变成“公式 (1.2)”,而此前定义的 @a 依然是“式 (1.1)”。supplement 是公式的属性,不是文档的全局设置。
两个我在实验里碰到的毛病,也一并记下:
supplement: none之后输出前面多了一个空格(" (1.1)"),是[#supp~#equation-number(el)]里那个~还在。- 英文那一行的第四个引用
#ref(<a>, form: "page")本来应该给出页码,输出却还是Equation (1.1):xuan的show ref没有处理form,把它吞掉了。要页码引用就别对公式用这个参数,这是第一版的限制。
还有最后一个,也是前面所有图里一直在出现的:第一个标题之前的公式编号是 (0.1),因为 counter(heading).get().first() 在没有标题时读到 0。笔记总是有标题的,所以我没有给它特殊处理,但你在 fig-math.typ 这种没有标题的小文件里就会看到 (0.1),这是它的来源。关闭编号的办法在对齐那一节已经出现:#set math.equation(numbering: none)。
32 行对照表
我把常用的写法收在 lab/ch08/latex-map.typ,用 xuan 的三线表渲染(表本身的机制是第 9 篇的内容)。这个文件的数据是一个 32 项的数组,每项是 LaTeX 写法、Typst 写法、渲染结果三元组,最后一个 #table(...) 把它铺开。这里只贴数组头三项和铺表的那几行,完整文件在仓库:
#let map = ( ("\\frac{a}{b}", "a/b", $a/b$), ("\\sqrt{x}", "sqrt(x)", $sqrt(x)$), ("\\sqrt[3]{x}", "root(3, x)", $root(3, x)$), // ... 29 more rows ...)#table( columns: (1fr, 1fr, auto), table.header[LaTeX][Typst][渲染], ..map.map(r => (raw(r.at(0)), raw(r.at(1)), r.at(2))).flatten(),)渲染出来是一页:
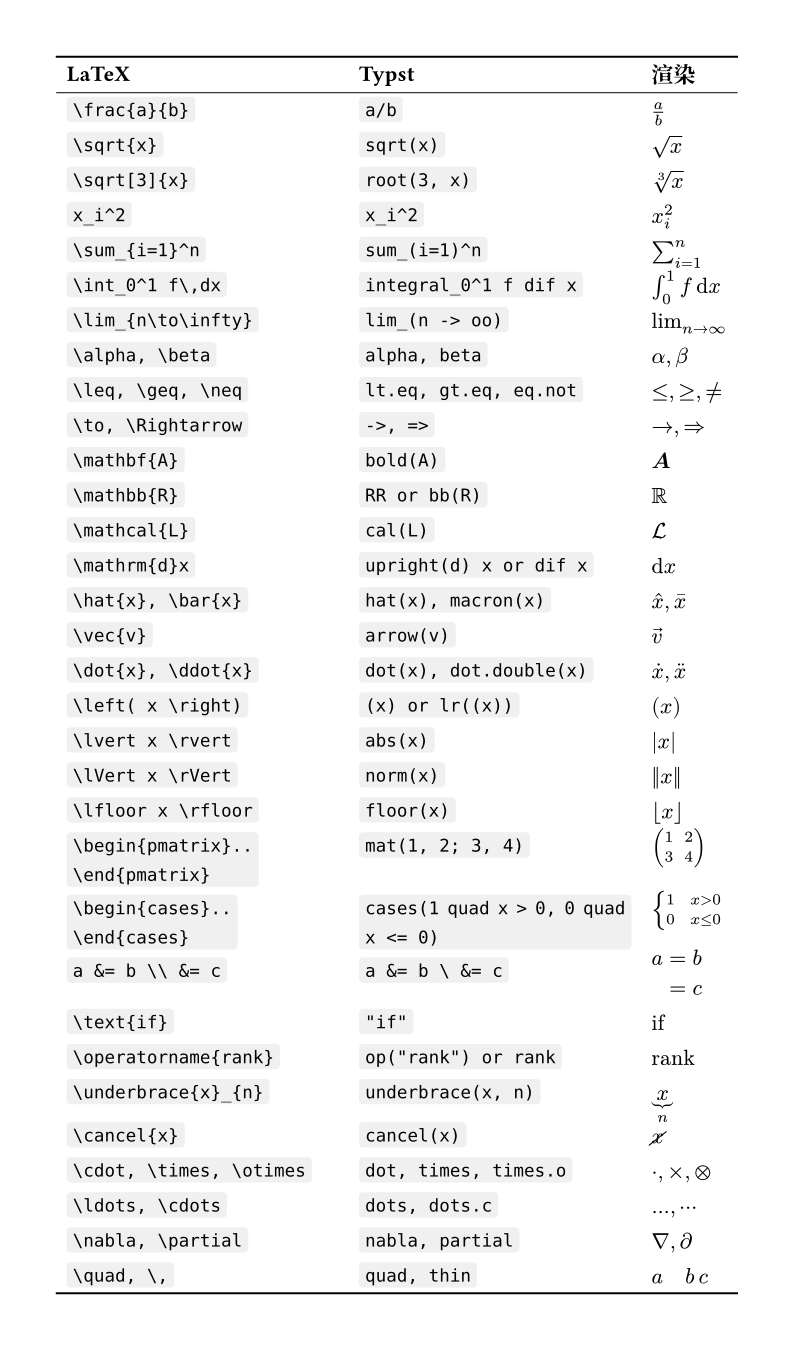
下面是同一张表的文字版,方便复制。我先说怎么验证,再给表。
Typst 列:每个单元格的字符串是我手写的,和右边渲染出的公式是两份数据,容易写岔。我用 eval(..., mode: "math") 把字符串重新求值,和渲染列比较:
#let sc = (rank: rank, tr: tr)#for r in map [ #let alts = r.at(1).split(" or ") #let res = alts.map(a => eval(a, mode: "math", scope: sc) == r.at(2)) #r.at(1) : #res.map(repr).join(" ")
]这段循环接在 map 的定义后面(完整文件是 /tmp/p8/mapcheck.typ)。eval(..., mode: "math") 返回的是一整个 equation 元素,所以要和渲染列的 r.at(2) 直接比;和它的 .body 比会全部是 false。正确的比较给出四行带 false:
RR or bb(R) : true falseupright(d) x or dif x : false true(x) or lr((x)) : false truequad, thin : false前三行是“或”写法:两个备选里只有一个和渲染列结构相同,另一个是同一个公式的另一种写法。渲染列画的是 RR、dif x、lr((x)),另一边的 bb(R)、upright(d) x、(x) 渲染出的字形我在 /tmp/p8/t2.typ 里并排看过,是一样的。最后一行 quad, thin 的渲染列本来就不是这个字符串对应的东西,而是 a quad b thin c 的演示,所以 false 是预期的。其余 28 行的 Typst 写法,第一个备选就与渲染列完全相同。也就是说除最后一行外,31 行的 Typst 写法都被机器验证过,没有一行是靠我读文档。
LaTeX 列:我用系统的 XeTeX 3.141592653-2.6-0.999997(TeX Live 2025)、amsmath、amssymb、cancel、mathtools 把这一列的写法编译了一遍(/tmp/p8/map.tex,输出 1 页,无报错)。表里有两行写成 .. 的简写:pmatrix 和 cases,我编译时写成了完整的环境。
| LaTeX | Typst |
|---|---|
\frac{a}{b} | a/b |
\sqrt{x} | sqrt(x) |
\sqrt[3]{x} | root(3, x) |
x_i^2 | x_i^2 |
\sum_{i=1}^n | sum_(i=1)^n |
\int_0^1 f\,dx | integral_0^1 f dif x |
\lim_{n\to\infty} | lim_(n -> oo) |
\alpha, \beta | alpha, beta |
\leq, \geq, \neq | lt.eq, gt.eq, eq.not |
\to, \Rightarrow | ->, => |
\mathbf{A} | bold(A) |
\mathbb{R} | RR 或 bb(R) |
\mathcal{L} | cal(L) |
\mathrm{d}x | upright(d) x 或 dif x |
\hat{x}, \bar{x} | hat(x), macron(x) |
\vec{v} | arrow(v) |
\dot{x}, \ddot{x} | dot(x), dot.double(x) |
\left( x \right) | (x) 或 lr((x)) |
\lvert x \rvert | abs(x) |
\lVert x \rVert | norm(x) |
\lfloor x \rfloor | floor(x) |
\begin{pmatrix}..\end{pmatrix} | mat(1, 2; 3, 4) |
\begin{cases}..\end{cases} | cases(1 quad x > 0, 0 quad x <= 0) |
a &= b \\ &= c | a &= b \ &= c |
\text{if} | "if" |
\operatorname{rank} | op("rank"),或 xuan 里的 rank |
\underbrace{x}_{n} | underbrace(x, n) |
\cancel{x} | cancel(x) |
\cdot, \times, \otimes | dot, times, times.o |
\ldots, \cdots | dots, dots.c |
\nabla, \partial | nabla, partial |
\quad, \, | quad, thin |
表里有三处需要补一句:
- 第 12 行
RR:RR是 Typst 预定义的黑板粗体 R,和bb(R)同形。NN、ZZ、QQ、CC同理,我把它们和RR一起放大编译过(/tmp/p8/transpose.typ末尾那一排)。 - 第 23 行
cases:值和条件之间没有&对齐,而是显式写quad隔开,原因见上一节。 - 第 26 行
rank:rank不是 Typst 内置的,是xuan导出的运算符;没有xuan时请用op("rank")。
回到线性代数
最后,我用这一整篇的写法,把最小二乘和奇异值分解两篇笔记里的几个公式重排一遍,写成 /tmp/p8/la.typ,每个公式都带编号和标签,正文用 @eq-... 互相引用:
#import "@local/xuan:0.1.0": *#set page(width: 14cm, height: auto, margin: 1cm)#show: xuan-base
// Bold upright vectors, the way the linear algebra posts write \mathbf.#let vb(x) = $bold(upright(#x))$
= 最小二乘
三个点 $(1, 1)$、$(2, 2)$、$(3, 2)$ 拟合直线,无解的方程组$A vb(x) = vb(b)$ 换成正规方程:
$ A^top A hat(vb(x)) = A^top vb(b) $ <eq-normal>
解出来 $hat(vb(x)) = (2/3, 1/2)$,误差向量 $vb(e) = vb(b) - A hat(vb(x))= (-1/6, 1/3, -1/6)$,它垂直于 $A$ 的列空间。投影矩阵是
$ P = A (A^top A)^(-1) A^top, quad vb(p) = P vb(b), quad vb(e) = (I - P) vb(b)$ <eq-proj>
= 奇异值分解
任何矩阵都能写成 $A = U Sigma V^top$。逐列看就是$A vb(v)_i = sigma_i vb(u)_i$,其中 $sigma_i > 0$ 是拉伸的倍数。
$ A^top A = V Sigma^top Sigma V^top = V mat(sigma_1^2, , ; , dots.down, ; , , sigma_n^2) V^top$ <eq-ata>
$ (A vb(v)_i)^top (A vb(v)_j) = cases( sigma_i^2 & quad i = j, 0 & quad i != j, )$ <eq-orth>
和 @eq-normal 一样,@eq-ata 里出现了 $A^top A$。@eq-orth 说明$vb(u)_i = A vb(v)_i slash sigma_i$ 天然标准正交。Strang 黑板上的矩阵 $A = mat(4, 4; -3, 3)$ 给出$sigma_1 = sqrt(32) approx 5.6569$ 和 $sigma_2 = sqrt(18) approx 4.2426$。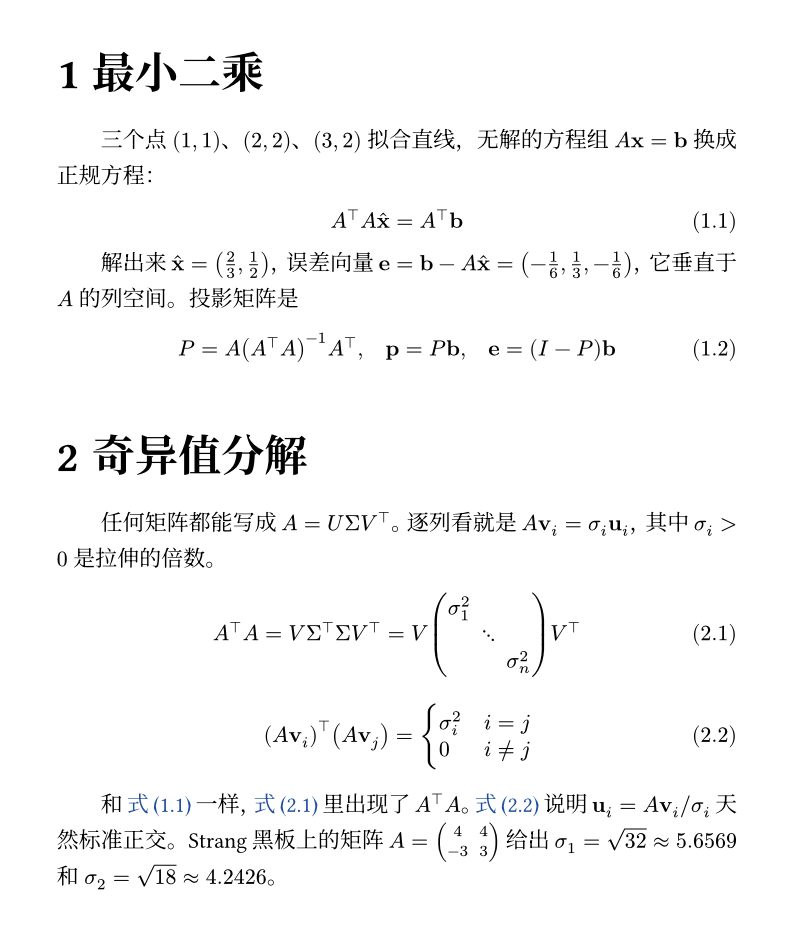
图里最后一段的 @eq-normal 是在第 2 章里引用第 1 章的公式,显示 式 (1.1),没有串章。这个文件里还有两个我在上面铺垫过的小点:对角阵用空格子写成 mat(sigma_1^2, , ; , dots.down, ; , , sigma_n^2),cases 里每个 & 后面都加了 quad。
源码长度。 这两篇笔记里的公式原来是 LaTeX 写的。我拿 SVD 那篇的 展开、最小二乘那篇的正规方程和投影矩阵这三个,数了源码的字符数。Typst 版本我按这一篇的写法,正规方程用了上面 vb 宏(宏的定义本身 1 行,没计入):
$ /tmp/p8/count.shlatex-svd 145typst-svd 115latex-ne 54typst-ne 32latex-p 37typst-p 22(count.sh 就是对每条公式 printf '%s' ... | wc -m,脚本在 /tmp/p8/count.sh,LaTeX 公式取自两篇笔记里的原文,SVD 那条原文分成两行,我用一个空格接成一行。)三个公式合计 236 个字符降到 169 个,少 28%。我没想拿这个数字证明什么,LaTeX 的每个反斜杠和花括号都有它的用处。单看差别最大的一条,SVD 的对角阵,145 个字符对 115 个,光是环境名 \begin{bmatrix} 加 \end{bmatrix} 就是 28 个字符,在 Typst 里是 mat( 加 ),共 5 个。
接下来
数学公式是 Typst 里第一个我觉得“写起来不比手写慢”的部分,唯一需要适应的是多字母名字要么加空格要么加引号。下一篇进入图、表、代码块和交叉引用:图和表的编号是同一个思路,也要按章编号、引用不串章,figure.typ 里有一条和 math.typ 结构相同的 show ref,读 el.location() 的方式也一样。顺带还有三线表、raw 的行号,以及 units.typ 里的 num 和 qty。
两件留给读者的事:把 math.typ 里的 context 去掉,对照上面的实验,看 numbering.typ 的输出有没有变;给 equation-number 补上 form: "page" 的分支,让 #ref(<a>, form: "page") 给出页码。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!