
 Better Mistakes



音乐
暂未播放
18.06 第 16 讲:投影矩阵与最小二乘
- 118.06 第 1 讲:方程组的行图与列图
- 218.06 第 2 讲:用矩阵做消元
- 318.06 第 3 讲:矩阵乘法的四种看法与逆矩阵
- 418.06 第 4 讲:分解成 A = LU
- 518.06 第 5 讲:转置、置换与向量空间
- 618.06 第 6 讲:列空间与零空间
- 718.06 第 7 讲:解 Ax = 0,主变量与特解
- 818.06 第 8 讲:解 Ax = b,行最简形 R
- 918.06 第 9 讲:线性无关、基与维数
- 1018.06 第 10 讲:四个基本子空间
- 1118.06 第 11 讲:矩阵空间、秩 1 矩阵与小世界图
- 1218.06 第 12 讲:图、网络与关联矩阵
- 1318.06 第 13 讲:第一次测验复习
- 1418.06 第 14 讲:正交向量与正交子空间
- 1518.06 第 15 讲:投影到子空间
- 1618.06 第 16 讲:投影矩阵与最小二乘本文
- 1718.06 第 17 讲:正交矩阵与 Gram-Schmidt
- 1818.06 第 18 讲:行列式的性质
- 1918.06 第 19 讲:行列式公式与代数余子式
- 2018.06 第 20 讲:Cramer 法则、逆矩阵与体积
- 2118.06 第 21 讲:特征值与特征向量
- 2218.06 第 22 讲:对角化与矩阵的幂
- 2318.06 第 23 讲:微分方程与 exp(At)
- 2418.06 第 24 讲:Markov 矩阵与 Fourier 级数
- 2518.06 第 24b 讲:第二次测验复习
- 2618.06 第 25 讲:对称矩阵与正定性
- 2718.06 第 26 讲:复矩阵与快速 Fourier 变换
- 2818.06 第 27 讲:正定矩阵与极小值
- 2918.06 第 28 讲:相似矩阵与 Jordan 标准形
- 3018.06 第 29 讲:奇异值分解
- 3118.06 第 30 讲:线性变换及其矩阵
- 3218.06 第 31 讲:基变换与图像压缩
- 3318.06 第 32 讲:第三次测验复习
- 3418.06 第 33 讲:左逆、右逆与伪逆
- 3518.06 第 34 讲:期末复习
最小二乘就是把“拟合直线”这件事翻译成上一讲的投影:三个点不在同一条直线上,方程组 无解,那就把 投影到 的列空间里,解最近的那个方程。Strang 的三个点是 、、,我用 NumPy 算出来最佳直线是 ,误差向量是 ,平方长度 0.1667。再往里加一个 处高度为 6 的离群点,斜率直接从 翻成 。
视频:Lecture 16: Projection matrices and least squares(OCW 页面与字幕) 教材:《Introduction to Linear Algebra》第 6 版 §4.3 Least Squares Approximations 前置:第 15 讲:投影到子空间 一句话:无解的 的最佳近似解满足正规方程 ,此时误差 垂直于 的整个列空间。
- 开头一段回顾上一讲的投影公式: 在列空间里时 , 在 的零空间里时 。第一节已经用代码验证过,可以倍速,但“垂直于列空间就是在 里”这句话值得听一遍。
- 三个点的直线拟合是这一讲的主体,他把正规方程一步步写出来,又用微积分重推一遍,还手算了 和 。这一段要认真看,尤其是他画的“两幅图”:一幅是平面上的点和直线,一幅是三维空间里的向量和列空间。
- 中间关于离群点的一小段(统计学家会担心平方放大异常值)本篇用一个例子算了数,看完他的说法再看我的数字就行。
- 接近结尾的证明( 的列无关,则 可逆)值得完整看一遍,是这一章里少有的一个完整证明。最后他预告下一讲的标准正交向量,本篇最后一节顺手给了一个数值预览。
上一讲的收尾:P 到底做了什么
上一讲结尾他给了投影矩阵的公式 。这一讲开头他换了个方式确认它没写错:看两个极端情形。
在列空间里会怎样? 列空间里的向量都写成 ,于是 ,中间的 与它的逆抵消,剩下 ,也就是 自己。他提醒“列空间里的向量就是 乘某个 ”这件事要记牢,说它一定会出现在期末考试里。
垂直于列空间会怎样? 垂直于所有的列,就是在 的零空间里,即 。公式最右边正好是 ,所以 ,直接得到零。
一般的 是这两种的和:一个分量在列空间里,被 原样保留;一个分量垂直于列空间,被 消灭。留下的就是 ,被消灭的那部分是 。他顺便说明了 也是投影矩阵,投到垂直空间上:若 对称, 对称;若 ,则 。
下面的脚本用第 16 讲的矩阵 (下一节要用的那个)把这几句话全验证一遍:
import numpy as np
def main() -> None: np.set_printoptions(precision=4, suppress=True) A = np.array([[1.0, 1.0], [1.0, 2.0], [1.0, 3.0]]) P = A @ np.linalg.inv(A.T @ A) @ A.T identity = np.eye(3)
# 两个极端:b 在列空间里(b = A x),b 垂直于列空间(A^T b = 0) b_in = A @ np.array([2.0, -1.0]) b_perp = np.array([1.0, -2.0, 1.0]) print("A^T b_perp =", A.T @ b_perp) print("P @ b_in =", P @ b_in, ",b_in =", b_in) print("P @ b_perp =", P @ b_perp)
# 一般的 b:P b 与 (I - P) b 加起来还是 b b = np.array([1.0, 2.0, 2.0]) p = P @ b e = (identity - P) @ b print("P b =", p) print("(I - P) b =", e) print("p + e = b:", np.allclose(p + e, b))
# P 是投影,I - P 也是 Q = identity - P print("P^2 = P:", np.allclose(P @ P, P)) print("(I - P)^2 = I - P:", np.allclose(Q @ Q, Q)) print("I - P 对称:", np.allclose(Q, Q.T))
if __name__ == "__main__": main()A^T b_perp = [0. 0.]P @ b_in = [ 1. 0. -1.] ,b_in = [ 1. 0. -1.]P @ b_perp = [0. 0. 0.]P b = [1.1667 1.6667 2.1667](I - P) b = [-0.1667 0.3333 -0.1667]p + e = b: TrueP^2 = P: True(I - P)^2 = I - P: TrueI - P 对称: True这里的 b_perp 是我先解 得到的 ,它既垂直于 ,也垂直于 ,所以 把它压成了零向量。最后三行都是 True。再看中间两行: 和 是下一节的主角,先在这里露个脸。
三个点的直线:无解方程组的最佳解
他选了最不起眼的三个点: 处高度分别是 。(他自己说“不是特别精彩”,我同意,但手算时数字不会难看。)想找一条直线 。如果直线穿过三个点,就要同时满足
这是 3 × 2 的矩阵,两列无关,是列空间的一组基,但列空间是三维空间里的一个平面, 不在这个平面里,所以 无解,没有直线能同时穿过三个点。
“最好”是什么意思? 他的回答是:每个点在竖直方向上离直线有多远,记作 ,把平方加起来:
选使 最小的 和 。这就是最小二乘,统计里的名字是线性回归。他特别说明了为什么要平方:长度恰好为零当且仅当 ,而平方让问题变成线性的,后面马上会看到。
怎么解? 这就是上一讲的投影:列空间里离 最近的点 对应的 满足
他把它称为正规方程(normal equations),并说这是他敢称之为“统计和估计里最重要的方程”的一个:凡是有噪声、有误差,用几个参数去拟合数据的场合,第一个要用的就是它。
他手算了 和 ,消元后 ,,回代得 。我让 NumPy 把同一条路走一遍,同时用 np.linalg.lstsq 对照,再检查 和 :
from fractions import Fraction
import numpy as np
def main() -> None: np.set_printoptions(precision=4, suppress=True) t = np.array([1.0, 2.0, 3.0]) b = np.array([1.0, 2.0, 2.0]) A = np.column_stack([np.ones(3), t]) # 第一列全 1,第二列是 t
# 正规方程 A^T A x = A^T b AtA = A.T @ A Atb = A.T @ b print("A^T A =\n", AtA) print("A^T b =", Atb) x = np.linalg.solve(AtA, Atb) print( "C, D =", x, "=", [str(Fraction(v).limit_denominator(100)) for v in x] )
# 和 np.linalg.lstsq 对比 x_lstsq, *_ = np.linalg.lstsq(A, b, rcond=None) print("lstsq 给出同样的解:", np.allclose(x, x_lstsq))
# 投影 p = A x 和误差 e = b - p p = A @ x e = b - p sixths = [str(Fraction(v).limit_denominator(100)) for v in p] print("p =", p, "=", sixths) print("e =", e, "=", [str(Fraction(v).limit_denominator(100)) for v in e]) print(f"平方误差 |e|^2 = {e @ e:.4f}")
# e 垂直于 p,也垂直于列空间里的任何向量 print(f"p . e = {p @ e:.1e}") print("A^T e =", np.round(A.T @ e, 12) + 0.0) print(f"e . (1, 1, 1) = {e @ np.ones(3):.1e}") print(f"e . (1, 2, 3) = {e @ t:.1e}")
if __name__ == "__main__": main()A^T A = [[ 3. 6.] [ 6. 14.]]A^T b = [ 5. 11.]C, D = [0.6667 0.5 ] = ['2/3', '1/2']lstsq 给出同样的解: Truep = [1.1667 1.6667 2.1667] = ['7/6', '5/3', '13/6']e = [-0.1667 0.3333 -0.1667] = ['-1/6', '1/3', '-1/6']平方误差 |e|^2 = 0.1667p . e = 7.8e-16A^T e = [0. 0.]e . (1, 1, 1) = 4.4e-16e . (1, 2, 3) = 8.9e-16数字和他黑板上的一模一样:、,,。他在黑板上还犯了个小错:一开始把 的符号写反了,后来为了让 成立才改过来,我这里用 b - p 直接保证了符号。(他手算 的时候吊着一口气,算出零才说了一句“Thank God”,因为 必须是零;NumPy 不用谢天谢地,只留下 量级的舍入误差。)
输出里最后四行是整讲的核心:
- ,也就是零:误差垂直于投影。
- 与 也都是 量级:不止垂直于 ,而是垂直于列空间里每一个向量,因为这两个向量恰好是 的两列。
A^T e就是 。把这一行展开看:,移项就是正规方程。
所以正规方程不过是一句话的代数形式:误差向量要垂直于列空间。他强调的“两幅图”也是这句话的两个侧面:平面上那幅图里, 和 决定直线, 是每个点到直线的竖直距离;三维空间那幅图里, 和 是两列的组合系数, 是组合出来的点, 是垂线。两幅图画的是同一件事。
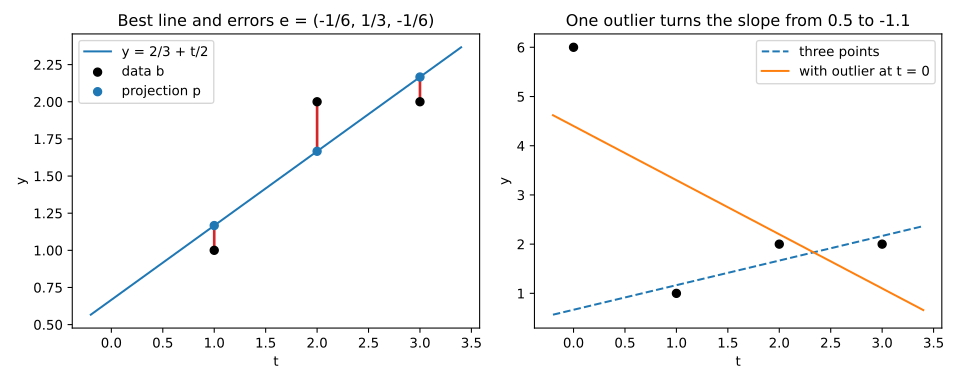
上面这张图由下面这个脚本生成(需要 matplotlib,在当前目录写出 SVG;图中的数据与前面的代码块相同):
import matplotlibimport matplotlib.pyplot as pltimport numpy as np
def main() -> None: matplotlib.use("Agg") plt.rcParams["svg.hashsalt"] = "la1806"
t = np.array([1.0, 2.0, 3.0]) b = np.array([1.0, 2.0, 2.0]) A = np.column_stack([np.ones(3), t]) x = np.linalg.solve(A.T @ A, A.T @ b) p = A @ x
t4 = np.array([0.0, 1.0, 2.0, 3.0]) b4 = np.array([6.0, 1.0, 2.0, 2.0]) A4 = np.column_stack([np.ones(4), t4]) x4, *_ = np.linalg.lstsq(A4, b4, rcond=None)
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10, 4)) ts = np.linspace(-0.2, 3.4, 50)
ax1.plot(ts, x[0] + x[1] * ts, color="C0", label="y = 2/3 + t/2") for ti, bi, pi in zip(t, b, p): ax1.plot([ti, ti], [bi, pi], color="C3", lw=2) ax1.scatter(t, b, color="k", zorder=3, label="data b") ax1.scatter(t, p, color="C0", zorder=3, label="projection p") ax1.set_title("Best line and errors e = (-1/6, 1/3, -1/6)") ax1.set_xlabel("t") ax1.set_ylabel("y") ax1.legend(loc="upper left")
ax2.plot(ts, x[0] + x[1] * ts, color="C0", ls="--", label="three points") ax2.plot(ts, x4[0] + x4[1] * ts, color="C1", label="with outlier at t = 0") ax2.scatter(t4, b4, color="k", zorder=3) ax2.set_title("One outlier turns the slope from 0.5 to -1.1") ax2.set_xlabel("t") ax2.set_ylabel("y") ax2.legend(loc="upper right")
fig.tight_layout() fig.savefig( "l16-fit-line.svg", metadata={"Date": None}, )
if __name__ == "__main__": main()左图里红色的短线就是 的三个分量,、、 说明数据点在直线的下方、上方、下方。右图留到下一节看。
从微积分走一遍,再看离群点
他随后说想用微积分把正规方程再推一遍: 是关于两个变量的函数,对 和 分别求偏导并令其为零,得到的是同样的两个线性方程。我顺手把它数值化: 的梯度是 ,在 处该是零。再用固定种子在 周围随机扰动 1000 次,看有没有比它更好的点。
最后,他还提到了统计学家对平方的警惕:假如在 处多一个特别离谱的测量,平方会把它的误差放大到别的点“看不见”的程度,这样的点叫离群点(outlier)。他没算数,我算了:
import numpy as np
def squared_error(A: np.ndarray, b: np.ndarray, x: np.ndarray) -> float: e = A @ x - b return float(e @ e)
def main() -> None: np.set_printoptions(precision=4, suppress=True) rng = np.random.default_rng(1806) t = np.array([1.0, 2.0, 3.0]) b = np.array([1.0, 2.0, 2.0]) A = np.column_stack([np.ones(3), t]) x = np.linalg.solve(A.T @ A, A.T @ b)
# 微积分:E(C, D) 的两个偏导数在 (C, D) = x 处都是 0 # E = |A x - b|^2 的梯度是 2 A^T (A x - b) print("梯度 =", np.round(2 * A.T @ (A @ x - b), 12) + 0.0)
# 在 x 周围随机扰动 1000 次,没有一次比 x 更好 E_best = squared_error(A, b, x) worse = 0 for _ in range(1000): trial = x + 0.1 * rng.standard_normal(2) if squared_error(A, b, trial) >= E_best: worse += 1 print(f"E(x) = {E_best:.4f},扰动后更差的次数:{worse} / 1000")
# 离群点:在 t = 0 处加一个高度 6 的点 t4 = np.array([0.0, 1.0, 2.0, 3.0]) b4 = np.array([6.0, 1.0, 2.0, 2.0]) A4 = np.column_stack([np.ones(4), t4]) x4, *_ = np.linalg.lstsq(A4, b4, rcond=None) print("三个点的直线:C, D =", x) print("加离群点之后:C, D =", x4) print("斜率 D 从", round(x[1], 4), "变成", round(x4[1], 4))
if __name__ == "__main__": main()梯度 = [0. 0.]E(x) = 0.1667,扰动后更差的次数:1000 / 1000三个点的直线:C, D = [0.6667 0.5 ]加离群点之后:C, D = [ 4.4 -1.1]斜率 D 从 0.5 变成 -1.1梯度是 ,随机扰动 1000 次,没有一次比 的平方误差 0.1667 更小:微积分和线性代数给出的是同一个极小点,这也不奇怪,因为 是二次函数,只有一个谷底。
离群点那一行才是惊人的。原本三个点的斜率是 ,只多一个高度为 6 的点,最小二乘就把斜率扳成了 ,截距从 0.6667 跳到 4.4:直线整个翻了个方向,穿过了原先三个点之外的地方。右图里实线(加了离群点)和虚线(原来三个点)对比最直观。我猜这就是他说“最小二乘最常用,但不是唯一用”的原因:平方对远处的点太宽容了,所以统计学家看见离群点会先去查是不是测量出了错。
为什么可逆
接近结尾的时候他补上了前面一直在用的一个事实:如果 的列无关, 就是可逆的。他说自己不爱在这门课里堆证明,但这个是“核心事实”,用到了前面学过的所有东西。
证明的思路是什么? 要证明 可逆,只要证明它的零空间里只有零向量。于是假设 ,两边左乘 (他把这叫作“brilliant idea”):
长度的平方是零,所以 。现在才用上假设: 的列无关,意味着 只有 一个解。于是 的零空间里只有零向量,它可逆。
他还点了 的性质:对称,(在列无关时)可逆,课程后面还会说它是正定的。我用代码把对称性、关键等式 数了一遍,并对照一个列相关的反例:给 添上第三列,等于第一列加第二列。结尾顺带做他预告的一件事:标准正交的列,。
import numpy as np
def main() -> None: np.set_printoptions(precision=4, suppress=True) rng = np.random.default_rng(1806)
# 列无关:A^T A 可逆 A = np.array([[1.0, 1.0], [1.0, 2.0], [1.0, 3.0]]) G = A.T @ A print( "A 的秩 =", np.linalg.matrix_rank(A), ",det(A^T A) =", np.linalg.det(G), ) print("A^T A 对称:", np.allclose(G, G.T))
# 证明里的关键一步:x^T A^T A x = |A x|^2 x = rng.standard_normal(2) print(f"x^T A^T A x = {x @ G @ x:.6f},|A x|^2 = {(A @ x) @ (A @ x):.6f}")
# 列相关:第三列 = 第一列 + 第二列,A^T A 奇异 B = np.column_stack([A, A[:, 0] + A[:, 1]]) H = B.T @ B print( "B 的秩 =", np.linalg.matrix_rank(B), ",H 的秩 =", np.linalg.matrix_rank(H), ) v = np.array([1.0, 1.0, -1.0]) # B v = 0 print("B v =", B @ v, ",H v =", H @ v)
# 预告:标准正交的列,Q^T Q = I theta = 0.6 Q = np.array( [[np.cos(theta), -np.sin(theta)], [np.sin(theta), np.cos(theta)]] ) print("Q^T Q =\n", Q.T @ Q)
if __name__ == "__main__": main()A 的秩 = 2 ,det(A^T A) = 6.0A^T A 对称: Truex^T A^T A x = 0.231946,|A x|^2 = 0.231946B 的秩 = 2 ,H 的秩 = 2B v = [0. 0. 0.] ,H v = [0. 0. 0.]Q^T Q = [[1. 0.] [0. 1.]]- 的秩是 2(列无关),,不是零,所以可逆:这正好是 Strang 前面手算时那个 ()。
- 等式 在随机的 上两边都是 0.231946。
- 反例里 的第三列是前两列的和,所以 的秩是 2 而不是 3,()。 是 3 × 3,秩是 2,: 的零空间向量也是 的零空间向量, 不可逆,正规方程没法直接解(需要伪逆,第 33 讲)。
- 最后他预告的 :旋转矩阵 的两列是互相垂直的单位向量, 是单位矩阵。于是正规方程里的 消失,,什么都不用解。
在控制里
最小二乘在控制里最常见的出场是辨识。比如我想知道一个一阶系统 的两个参数:把实验里采到的 、、 逐行排成 ,其中 的每一行是 ,, 是 那一列。数据比未知数多得多,方程无解,于是解 。这和今天拟合三个点是同一个模板,只不过 的列从 换成了 。
传感器标定是更朴素的版本:对一个传感器喂几组已知的输入,记录读数,拟合 。 是零偏, 是增益,和 完全对应。离群点那一节在这里也不是纯理论:偶尔有一个读数因为干扰跳出去,平方会让它主导整条拟合线,所以标定前最好先看一眼残差,把明显不对的点挑出来。
还有一个得留意的点是 的可逆性:它要求 的列无关,在辨识里就是说激励信号得“足够丰富”,如果 永远是常数且和 成比例,两列相关, 奇异,参数根本辨识不出来。最后一节里那个列相关的反例就是这种情形的缩影。
下一讲他要回答今天结尾留下的问题:怎么挑出最好的基,让 变成单位矩阵。答案是标准正交向量,以及把任意一组基变成标准正交基的 Gram-Schmidt,见 18.06 第 17 讲:正交矩阵与 Gram-Schmidt。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!