
 Better Mistakes



音乐
暂未播放
18.06 第 27 讲:正定矩阵与极小值
- 118.06 第 1 讲:方程组的行图与列图
- 218.06 第 2 讲:用矩阵做消元
- 318.06 第 3 讲:矩阵乘法的四种看法与逆矩阵
- 418.06 第 4 讲:分解成 A = LU
- 518.06 第 5 讲:转置、置换与向量空间
- 618.06 第 6 讲:列空间与零空间
- 718.06 第 7 讲:解 Ax = 0,主变量与特解
- 818.06 第 8 讲:解 Ax = b,行最简形 R
- 918.06 第 9 讲:线性无关、基与维数
- 1018.06 第 10 讲:四个基本子空间
- 1118.06 第 11 讲:矩阵空间、秩 1 矩阵与小世界图
- 1218.06 第 12 讲:图、网络与关联矩阵
- 1318.06 第 13 讲:第一次测验复习
- 1418.06 第 14 讲:正交向量与正交子空间
- 1518.06 第 15 讲:投影到子空间
- 1618.06 第 16 讲:投影矩阵与最小二乘
- 1718.06 第 17 讲:正交矩阵与 Gram-Schmidt
- 1818.06 第 18 讲:行列式的性质
- 1918.06 第 19 讲:行列式公式与代数余子式
- 2018.06 第 20 讲:Cramer 法则、逆矩阵与体积
- 2118.06 第 21 讲:特征值与特征向量
- 2218.06 第 22 讲:对角化与矩阵的幂
- 2318.06 第 23 讲:微分方程与 exp(At)
- 2418.06 第 24 讲:Markov 矩阵与 Fourier 级数
- 2518.06 第 24b 讲:第二次测验复习
- 2618.06 第 25 讲:对称矩阵与正定性
- 2718.06 第 26 讲:复矩阵与快速 Fourier 变换
- 2818.06 第 27 讲:正定矩阵与极小值本文
- 2918.06 第 28 讲:相似矩阵与 Jordan 标准形
- 3018.06 第 29 讲:奇异值分解
- 3118.06 第 30 讲:线性变换及其矩阵
- 3218.06 第 31 讲:基变换与图像压缩
- 3318.06 第 32 讲:第三次测验复习
- 3418.06 第 33 讲:左逆、右逆与伪逆
- 3518.06 第 34 讲:期末复习
Strang 说这一讲会把整门课串在一起:主元、行列式、特征值,再加一个新东西 ,“这才是这一讲要盯着的那个人”。我拿他黑板上的 做实验: 的时候,在 10 万个随机单位向量上 的最小值是 0.1833,恰好等于最小特征值;把 改成 7,最小值变成 ,也恰好是最小特征值(负的)。四种判据说的是同一件事,而这件事就是“向任何方向走,函数都往上翘”。
视频:Lecture 27: Positive definite matrices and minima(OCW 页面与字幕) 教材:《Introduction to Linear Algebra》第 6 版 §6.3 Symmetric Positive Definite Matrices;§9.1 Minimizing a Multivariable Function 前置:第 26 讲:复矩阵与快速 Fourier 变换 一句话:对称矩阵 正定,等价于特征值全正、顺序主子式全正、主元全正、 对所有 成立;二阶导数矩阵正定,就是多元函数的极小值条件。
- 开头他先列目标:怎么判断、为什么在乎、最后有几何。这一小段听一遍就够了,后面每一步我都在代码里对应上了。
- 他口算 ,一路问“ 要多大”,从 18 的临界情形讲到 7 的鞍点。这一段是整讲的核心,要认真看,本篇第一节只是重算了一遍。
- 他用“配方”解释为什么主元是括号外面的系数,这是最漂亮的一步,值得停下来自己配一次方。
- 讲 、、 的那段和最后的椭球、橄榄球可以倍速,我在第三、四节用代码算过了。他在最后一句留的主轴定理,就是第 25 讲的谱分解 。
四种判据,同一个 2 × 2
Strang 先只考虑对称矩阵。他给出的前三个判据都是“不用看 就能判”的:
- 特征值:全部大于 0。
- 行列式:左上角 、、……的顺序主子式(他叫它们“西北角”的子矩阵)全部大于 0。
- 主元:消元之后的主元全部大于 0。
第四个才是他最想强调的:对任意非零 ,。他说多数教材拿它当定义,前面三条当检验。
那个 到底要多大? 他取 ,问 至少要多大才正定。第一个主元是 2,没问题;行列式是 ,所以 必须大于 18。他还专门拿 18 本身做了一次示范:此时矩阵奇异,只有一个主元,特征值是 0 和 20(迹是 20),这叫半正定。他再换成 ,说这个矩阵“肯定不正定”:行列式是 ,主元是 2 和 。
下面的脚本对 各算一遍特征值、顺序主子式、主元,并且在 10 万个随机单位向量上看 的最小值。最后一行是他的反例: 时取 。
import numpy as np
def pivots_no_exchange(A: np.ndarray) -> np.ndarray: """不换行的消元,返回主元。""" U = A.astype(float).copy() n = U.shape[0] for j in range(n): for i in range(j + 1, n): U[i] -= U[i, j] / U[j, j] * U[j] return np.diag(U)
def main() -> None: np.set_printoptions(precision=4, suppress=True) rng = np.random.default_rng(1806) X = rng.standard_normal((2, 100000)) X /= np.linalg.norm(X, axis=0) # 单位向量,只看方向
for c in (7.0, 18.0, 20.0): A = np.array([[2.0, 6.0], [6.0, c]]) eigs = np.linalg.eigvalsh(A) dets = [A[0, 0], np.linalg.det(A)] pivots = pivots_no_exchange(A) # 对 10 万个随机单位向量,看 x^T A x 的最小值 f = np.einsum("ik,ij,jk->k", X, A, X) print(f"c = {c:.0f}") print(" 特征值:", eigs) print(" 顺序主子式:", np.array(dets)) print(" 主元:", pivots) print(" 单位向量上 x^T A x 的最小值:", f"{f.min():.4f}")
# Strang 的反例:c = 7 时取 x = (1, -1) A = np.array([[2.0, 6.0], [6.0, 7.0]]) x = np.array([1.0, -1.0]) print("c = 7,x = (1, -1):x^T A x =", x @ A @ x)
if __name__ == "__main__": main()c = 7 特征值: [-2. 11.] 顺序主子式: [ 2. -22.] 主元: [ 2. -11.] 单位向量上 x^T A x 的最小值: -2.0000c = 18 特征值: [ 0. 20.] 顺序主子式: [2. 0.] 主元: [2. 0.] 单位向量上 x^T A x 的最小值: 0.0000c = 20 特征值: [ 0.1833 21.8167] 顺序主子式: [2. 4.] 主元: [2. 2.] 单位向量上 x^T A x 的最小值: 0.1833c = 7,x = (1, -1):x^T A x = -3.0三种 的输出排在一起看,规律很整齐。
- :特征值 0.1833 和 21.8167 都是正的,顺序主子式是 2 和 4,主元是 2 和 2,随机单位向量上的最小值是 0.1833。
- :特征值是 0 和 20,行列式是 0,第二个主元是 0,最小值是 0.0000:向某个方向走,函数一路平着没有上翘,这就是半正定。
- :特征值 和 11,行列式 ,主元 2 和 (和他在黑板上说的完全一致),最小值 。他取的 给出 ,输出里是 。
最小值那一行是我顺手加的,不是他讲的。我先用的是不归一化的随机向量,结果 也给出一个贴着 0 的最小值,因为向量本身可以任意短。归一化之后,最小值就是最小特征值,这是 Rayleigh 商的结论(我是在代码里看到它的,视频里没有提)。
他还有一个口算特征值符号的技巧: 的时候,行列式是 ,迹是 22。两个特征值乘起来是 4,加起来是 22,所以不可能一正一负,也不可能都负(都负的话迹就是负的),只能都正。输出里的 0.1833 和 21.8167,乘积是 4,和是 22,对得上。(我一直觉得这类“不用算特征值就知道符号”的技巧很像考试专用,但它确实比解二次方程快。)
配方就是消元
第四个判据怎么检验? 光靠试向量是不行的,试多少个都不算数。Strang 的办法是写成平方和。 对 展开是
所有麻烦都来自交叉项 。他让大家配方:先写 ,展开后 项和 项都对了,但 项是 18,比 20 少 2,补上 :
两个平方加起来,不可能是负的。如果 ,剩下的就是 ,是 ,取 让第一个平方为 0,函数就是负的。 时补不上任何东西,正是临界。
然后他指出这些数字不是巧合:括号外面的 2 和 2 是主元,括号里的 3 是消元的乘数。对 做消元,从第二行减去 3 倍第一行,得到 ,。所以配方就是消元,主元为正就是平方和,平方和就是函数为正。
我用一个脚本把这件事验了一遍,顺便做了他最后一个例子的 3 × 3 版本。他说“用我最喜欢的那个矩阵”,也就是对角线为 2、两侧为 的三对角矩阵。他口算的结果是:行列式 2、3、4,主元 ,特征值猜是 (他用迹 6 和行列式 4 来核对)。脚本里还加了 np.linalg.cholesky:
import numpy as np
def ldu(A: np.ndarray) -> tuple[np.ndarray, np.ndarray]: """不换行的消元,返回单位下三角 L 和主元向量 d。""" U = A.astype(float).copy() n = U.shape[0] L = np.eye(n) for j in range(n): for i in range(j + 1, n): L[i, j] = U[i, j] / U[j, j] U[i] -= L[i, j] * U[j] return L, np.diag(U)
def main() -> None: np.set_printoptions(precision=4, suppress=True) rng = np.random.default_rng(1806)
# 2 x 2:配方就是消元,括号外是主元,括号里是乘数 A = np.array([[2.0, 6.0], [6.0, 20.0]]) L, d = ldu(A) print("乘数 l21 =", L[1, 0], ",主元 =", d) x, y = rng.standard_normal(2) f = np.array([x, y]) @ A @ np.array([x, y]) square = d[0] * (x + L[1, 0] * y) ** 2 + d[1] * y**2 print("2(x + 3y)^2 + 2y^2 与 x^T A x 相等:", np.isclose(f, square))
# 3 x 3:Strang 的“好矩阵” B = np.array([[2.0, -1.0, 0.0], [-1.0, 2.0, -1.0], [0.0, -1.0, 2.0]]) L, d = ldu(B) print("主元:", d, ",即 2, 3/2, 4/3:", np.allclose(d, [2, 1.5, 4 / 3])) print("特征值:", np.linalg.eigvalsh(B)) print( "2 - sqrt(2), 2, 2 + sqrt(2):", np.array([2 - 2**0.5, 2.0, 2 + 2**0.5]), ) print("迹 =", np.trace(B), ",det =", round(np.linalg.det(B), 4))
# Cholesky:B = C C^T,C = L sqrt(D) C = np.linalg.cholesky(B) print("cholesky(B) =") print(C) print( "L sqrt(D) 与 cholesky 相同:", np.allclose(C, L @ np.diag(np.sqrt(d))) ) print("C @ C.T 等于 B:", np.allclose(C @ C.T, B))
# 不正定的矩阵,cholesky 直接报错 for c in (18.0, 7.0): try: C2 = np.linalg.cholesky(np.array([[2.0, 6.0], [6.0, c]])) print(f"c = {c:.0f}:分解成功,C[1, 1] = {C2[1, 1]:.3e}") except np.linalg.LinAlgError as err: print(f"c = {c:.0f}:{err}")
if __name__ == "__main__": main()乘数 l21 = 3.0 ,主元 = [2. 2.]2(x + 3y)^2 + 2y^2 与 x^T A x 相等: True主元: [2. 1.5 1.3333] ,即 2, 3/2, 4/3: True特征值: [0.5858 2. 3.4142]2 - sqrt(2), 2, 2 + sqrt(2): [0.5858 2. 3.4142]迹 = 6.0 ,det = 4.0cholesky(B) =[[ 1.4142 0. 0. ] [-0.7071 1.2247 0. ] [ 0. -0.8165 1.1547]]L sqrt(D) 与 cholesky 相同: TrueC @ C.T 等于 B: Truec = 18:分解成功,C[1, 1] = 5.960e-08c = 7:Matrix is not positive definite前几行就是他口算的所有数字:乘数 3、主元 2 和 2、主元 、特征值 0.5858、2、3.4142,迹 6、行列式 4,都对上了。
Cholesky 分解 是视频里没有出现的东西,我加它是因为它正好是上面这件事的矩阵形式:主元开平方,。输出里“L sqrt(D) 与 cholesky 相同:True”就是这个意思。分解没有主元为负的余地(负数没法开方),所以 np.linalg.cholesky 也成了我手边最顺手的“是不是正定”的检验,比求特征值便宜。
但临界情形有个坑。 的时候,cholesky 抛出 Matrix is not positive definite,符合预期。 的时候,真实的第二个主元是 0,分解本该失败,它却“成功”了,算出 。我猜是舍入: 的平方和 18 差了一个浮点误差,让本该是 0 的主元变成了 ,开方后就是这个 量级的数。结论是:浮点数上判断半正定和正定之间的边界,本来就靠不住,要么留容差,要么看主元的大小,不要看“成不成功”。
碗、鞍与椭圆
画出来是什么样? Strang 先把乘法做开:。它不是线性的( 才是),而是纯二次的:没有一次项,没有常数项,是“二次型”。
函数 的图像在原点过零点,所以原点是它的“可疑点”。 的时候,沿每个方向都往上,图像是一个碗,原点是最低点。 的时候沿 往下,沿 轴和 轴往上,原点是鞍点。他承认自己画不好鞍,只好把“马鞍”这个词念出来。(图上他画的那条抛物线,他自己都说是抛物线,我就信了。)
把碗在高度 1 处切开,,得到一个椭圆;把鞍在 1 处切开,得到双曲线。这就是他说的“椭圆和正定有关,双曲线没有”。
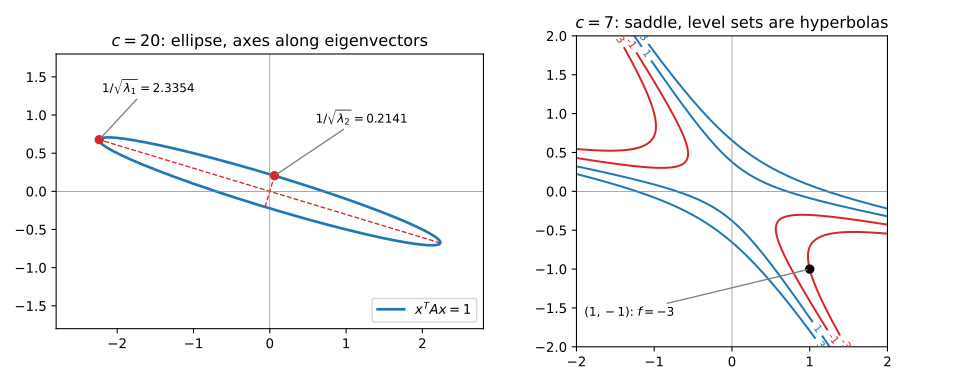
上面这张图由下面这个脚本生成(需要 matplotlib,在当前目录写出 SVG;图中的数据与前面的代码块相同):
import matplotlibimport matplotlib.pyplot as pltimport numpy as np
def main() -> None: matplotlib.use("Agg") plt.rcParams["svg.hashsalt"] = "la1806" OUT = "l27-ellipse-saddle.svg"
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10, 4))
A = np.array([[2.0, 6.0], [6.0, 20.0]]) lam, Q = np.linalg.eigh(A) half = 1 / np.sqrt(lam) t = np.linspace(0, 2 * np.pi, 400) circle = np.vstack([np.cos(t), np.sin(t)]) # x = Q diag(1/sqrt(lam)) u,u 在单位圆上 pts = Q @ np.diag(half) @ circle ax1.plot(pts[0], pts[1], color="C0", lw=2, label=r"$x^TAx=1$") for k in range(2): tip = half[k] * Q[:, k] ax1.plot([-tip[0], tip[0]], [-tip[1], tip[1]], "--", color="C3", lw=1) ax1.plot(*tip, "o", color="C3") ax1.annotate( r"$1/\sqrt{\lambda_1}=2.3354$", (-2.2352, 0.6768), (-2.2, 1.3), fontsize=9, arrowprops={"arrowstyle": "-", "color": "gray"}, ) ax1.annotate( r"$1/\sqrt{\lambda_2}=0.2141$", (0.062, 0.2049), (0.6, 0.9), fontsize=9, arrowprops={"arrowstyle": "-", "color": "gray"}, ) ax1.set_aspect("equal") ax1.set_xlim(-2.8, 2.8) ax1.set_ylim(-1.8, 1.8) ax1.axhline(0, color="gray", lw=0.5) ax1.axvline(0, color="gray", lw=0.5) ax1.set_title(r"$c=20$: ellipse, axes along eigenvectors") ax1.legend(loc="lower right")
S = np.array([[2.0, 6.0], [6.0, 7.0]]) g = np.linspace(-2, 2, 400) X, Y = np.meshgrid(g, g) F = S[0, 0] * X**2 + 2 * S[0, 1] * X * Y + S[1, 1] * Y**2 cs = ax2.contour( X, Y, F, levels=[-3, -1, 1, 3], colors=["C3", "C3", "C0", "C0"] ) ax2.clabel(cs, fmt="%d", fontsize=8) ax2.plot([1], [-1], "ko") ax2.annotate( r"$(1,-1)$: $f=-3$", (1, -1), (-1.9, -1.6), fontsize=9, arrowprops={"arrowstyle": "-", "color": "gray"}, ) ax2.set_aspect("equal") ax2.axhline(0, color="gray", lw=0.5) ax2.axvline(0, color="gray", lw=0.5) ax2.set_title(r"$c=7$: saddle, level sets are hyperbolas")
fig.tight_layout() fig.savefig(OUT, metadata={"Date": None})
if __name__ == "__main__": main()椭圆的形状由特征分解决定。他在最后说,把 写成 (主轴定理),特征向量是主轴方向,特征值决定轴的长度。他当时对“长度和特征值的关系”含糊其辞(“长度,或者半长度,或者特征值的倒数”)。我自己推一下:沿特征向量 走 ,,等于 1 的时候 ,所以半轴长是 ,特征值越大轴越短。
import numpy as np
def main() -> None: np.set_printoptions(precision=4, suppress=True) rng = np.random.default_rng(1806)
# 椭圆 x^T A x = 1:A = Q Lambda Q^T,特征向量是主轴方向 A = np.array([[2.0, 6.0], [6.0, 20.0]]) lam, Q = np.linalg.eigh(A) print("特征值:", lam) print("特征向量(列):") print(Q) print("A 等于 Q Lambda Q^T:", np.allclose(A, Q @ np.diag(lam) @ Q.T))
half = 1 / np.sqrt(lam) print("半轴长 1/sqrt(lambda):", half) for k in range(2): tip = half[k] * Q[:, k] print(f" 主轴 {k + 1} 的端点 {tip},x^T A x = {tip @ A @ tip:.4f}")
# 任取一个方向,缩放到椭圆上 d = rng.standard_normal(2) p = d / np.sqrt(d @ A @ d) print(f"随机方向缩放后:x^T A x = {p @ A @ p:.4f}") print(f"长半轴 / 短半轴 = {half[0] / half[1]:.4f}") print(f"sqrt(特征值之比) = {np.sqrt(lam[1] / lam[0]):.4f}")
# 鞍点:c = 7 时沿两个特征向量走同样的距离 S = np.array([[2.0, 6.0], [6.0, 7.0]]) lam_s, Q_s = np.linalg.eigh(S) for k in range(2): f = (Q_s[:, k] @ S @ Q_s[:, k]) * 0.5**2 print(f"鞍点矩阵:沿特征向量 {k + 1} 走 0.5,f = {f:.4f}")
# 3 x 3 的“橄榄球”:三个半轴,各自对应一个特征值 B = np.array([[2.0, -1.0, 0.0], [-1.0, 2.0, -1.0], [0.0, -1.0, 2.0]]) lam_b, Q_b = np.linalg.eigh(B) print("3 x 3 半轴长:", 1 / np.sqrt(lam_b)) print("主轴两两正交:", np.allclose(Q_b.T @ Q_b, np.eye(3)))
if __name__ == "__main__": main()特征值: [ 0.1833 21.8167]特征向量(列):[[-0.9571 0.2898] [ 0.2898 0.9571]]A 等于 Q Lambda Q^T: True半轴长 1/sqrt(lambda): [2.3354 0.2141] 主轴 1 的端点 [-2.2352 0.6768],x^T A x = 1.0000 主轴 2 的端点 [0.062 0.2049],x^T A x = 1.0000随机方向缩放后:x^T A x = 1.0000长半轴 / 短半轴 = 10.9083sqrt(特征值之比) = 10.9083鞍点矩阵:沿特征向量 1 走 0.5,f = -0.5000鞍点矩阵:沿特征向量 2 走 0.5,f = 2.75003 x 3 半轴长: [1.3066 0.7071 0.5412]主轴两两正交: True对 ,,半轴长 2.3354 和 0.2141,两个端点 和 代进 都得 1.0000。长半轴与短半轴之比是 10.9083,恰好是 ,特征值之比是 119 倍,开方之后是 10.9 倍。这就是为什么图里那个椭圆这么细长:两个特征值差了两个数量级。
对 ,沿两个特征向量各走 0.5:一个方向 ,另一个 。同样的步长,一边下坡一边上坡,鞍的定义就是这个。他说“完美的方向就是特征向量方向”,我验证的就是这句。把一颗弹珠放在原点,碗里它会停住,鞍上轻轻一推,它会顺着 那个特征向量的方向滑走。(这是我这篇唯一的类比,用完就收。)
最后是他的 3 × 3 例子。四维空间里没法画图,但 是一个椭球,他叫它“橄榄球”,有三个主轴,长度由特征值决定。输出里 3 × 3 的半轴长是 1.3066、0.7071、0.5412,主轴两两正交。如果特征值全相等,就是球(单位矩阵);有两个相等,就是他说的“更接近橄榄球”的旋转椭球。
极小值:二阶导数矩阵
这些和极小值有什么关系? Strang 回到微积分:一元函数 在一个点取极小,要一阶导数为 0,再要二阶导数为正,也就是斜率在增加、曲线向上弯。多元函数完全平行:一阶导数(梯度)为 0,二阶导数矩阵
正定。它为什么对称?因为混合偏导与求导次序无关,。他提到微积分课本里写的条件是 ,那只是 的行列式条件;现在我们有了 的答案,不管维数多高,都是同一句话:“数为正”变成“矩阵正定”。
我用中心差分算了前面两个函数在原点处的二阶导数矩阵,再用梯度下降看原点是不是真的吸引:
import numpy as np
def hessian(f, p: np.ndarray, h: float = 1e-3) -> np.ndarray: """中心差分求二阶导数矩阵。""" n = p.size H = np.zeros((n, n)) E = np.eye(n) * h for i in range(n): for j in range(n): H[i, j] = ( f(p + E[i] + E[j]) - f(p + E[i] - E[j]) - f(p - E[i] + E[j]) + f(p - E[i] - E[j]) ) / (4 * h * h) return H
def descend(A: np.ndarray, p: np.ndarray, steps: int, lr: float) -> float: """对 f = x^T A x 做梯度下降,返回最后的 |x|。""" for _ in range(steps): p = p - lr * 2 * A @ p return float(np.linalg.norm(p))
def main() -> None: np.set_printoptions(precision=4, suppress=True) rng = np.random.default_rng(1806) origin = np.zeros(2)
for c in (20.0, 7.0): A = np.array([[2.0, 6.0], [6.0, c]])
def f(p: np.ndarray, A: np.ndarray = A) -> float: return float(p @ A @ p)
H = hessian(f, origin) grad = np.array( [(f(e * 1e-3) - f(-e * 1e-3)) / 2e-3 for e in np.eye(2)] ) print(f"c = {c:.0f}") print(" 原点处的梯度:", grad) print(" 二阶导数矩阵:") print(H) print(" 等于 2A:", np.allclose(H, 2 * A, atol=1e-4)) print(" 二阶导数矩阵的特征值:", np.linalg.eigvalsh(H))
p0 = rng.standard_normal(2) print( " 从随机点出发,梯度下降 5000 步后 |x| =", f"{descend(A, p0, 5000, 0.01):.3e}", ",起点 |x| =", f"{np.linalg.norm(p0):.3f}", )
if __name__ == "__main__": main()c = 20 原点处的梯度: [0. 0.] 二阶导数矩阵:[[ 4. 12.] [12. 40.]] 等于 2A: True 二阶导数矩阵的特征值: [ 0.3667 43.6333] 从随机点出发,梯度下降 5000 步后 |x| = 7.446e-09 ,起点 |x| = 0.707c = 7 原点处的梯度: [0. 0.] 二阶导数矩阵:[[ 4. 12.] [12. 14.]] 等于 2A: True 二阶导数矩阵的特征值: [-4. 22.] 从随机点出发,梯度下降 5000 步后 |x| = 6.057e+83 ,起点 |x| = 0.575- 的二阶导数矩阵是 (二次函数的二阶导数里,平方项会多出一个 2),所以输出里是 。Strang 在黑板上写的是 本身,差一个因子 2 不影响正定与否。
- 原点处梯度是 0,这对碗和鞍都成立。一阶条件只给“候选点”,是二阶导数矩阵的特征值( 时 0.3667 与 43.6333, 时 与 22)说了算。
- 梯度下降 5000 步:碗里 从 0.707 降到 ,鞍上从 0.575 涨到 。第二个数字大得有点滑稽,但它说的只是:沿着 对应的方向,每一步都把偏离放大。
注意碗里收敛得并不快:5000 步才降到 。二阶导数矩阵两个特征值差了 119 倍,步长要听最大的特征值的,而最平的方向就只能慢慢走。
在控制里
LQR 的代价每一步是 ,正是两个二次型相加。把 拼成一个向量,它就是 。这一讲的结论拿来用就是: 和 的正(半)定性决定了“代价函数是不是一个碗”。我在 平衡步兵的 LQR 里用 Bryson 法则取的 ,,下面检查它们:
import numpy as np
def is_pd(M: np.ndarray) -> bool: """用 Cholesky 判断是否正定。""" try: np.linalg.cholesky(M) except np.linalg.LinAlgError: return False return True
def main() -> None: np.set_printoptions(precision=4, suppress=True)
# Bryson 权重:允许的最大值的平方的倒数 x_max = np.array([0.5, 1.0, 0.1, 1.0]) u_max = np.array([10.0]) Q = np.diag(1 / x_max**2) R = np.diag(1 / u_max**2) print("Q 的对角线:", np.diag(Q), ",R =", R[0, 0]) print("Q 正定:", is_pd(Q), ",R 正定:", is_pd(R))
# 每一步的代价 x^T Q x + u^T R u 是 (x, u) 上的一个二次型 M = np.block([[Q, np.zeros((4, 1))], [np.zeros((1, 4)), R]]) z = np.array([0.5, 1.0, 0.1, 1.0, 10.0]) # 每个量都取到允许的最大值 print("全部取最大允许值时的代价:", z @ M @ z)
# 把 Q 的第二个权重设成 0:半正定,有一个方向不花钱 Q0 = Q.copy() Q0[1, 1] = 0.0 x_free = np.array([0.0, 1.0, 0.0, 0.0]) print("Q0 正定:", is_pd(Q0), ",Q0 的特征值:", np.linalg.eigvalsh(Q0)) print("速度 1 m/s、其余为 0 的代价:", x_free @ Q0 @ x_free)
# 非对角的 Q:同时惩罚位置和倾角的“耦合”,要看是否仍然正定 for coupling in (1.0, 25.0): Qc = Q.copy() Qc[0, 2] = Qc[2, 0] = coupling eigs = np.linalg.eigvalsh(Qc) print( f"耦合项 {coupling:>4}:最小特征值 {eigs[0]:.4f},正定:", is_pd(Qc), )
if __name__ == "__main__": main()Q 的对角线: [ 4. 1. 100. 1.] ,R = 0.01Q 正定: True ,R 正定: True全部取最大允许值时的代价: 5.0Q0 正定: False ,Q0 的特征值: [ 0. 1. 4. 100.]速度 1 m/s、其余为 0 的代价: 0.0耦合项 1.0:最小特征值 1.0000,正定: True耦合项 25.0:最小特征值 -2.1202,正定: False据我所知,标准的 LQR 要求 半正定、 正定。原因是这样的(我没有在代码里验证 半正定的情形):如果 只是半正定,就会有某个方向的输入不花代价,优化器没有理由不在那个方向上无限加大; 正定就保证每一个非零输入都有正的代价,也保证求增益时要求逆的 可逆。 可以是半正定的,只是意味着某些状态“不花钱”,输出里把速度权重设成 0,速度 1 m/s 的代价是 0.0(这时 LQR 是不是还有解,要看系统可检测不可检测,我没有在这里验证,是控制课的内容)。
最后一个检查是容易踩的坑:一旦写非对角的 去表达“位置和倾角的耦合”,就不能随手填数。耦合项 1.0 时最小特征值是 1.0000,仍然正定;耦合项 25.0 时最小特征值是 , 不正定,代价函数在某个方向上可以是负的,LQR 就没有意义了。写非对角权重前先用 cholesky 跑一遍,几乎不费事。
下一讲
今天一直在用“特征值全正”,但特征值有它不好用的地方:两个不同的矩阵可以有同样的特征值,而且有的矩阵根本对角化不了。下一讲 Strang 要讲相似矩阵与 Jordan 标准形,我把没法对角化的那种矩阵拿出来,对它加一个 的扰动,看看特征值会跑多远,见 18.06 第 28 讲:相似矩阵与 Jordan 标准形。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!