
 Better Mistakes



音乐
暂未播放
状态反馈:LQR、LQI 与平衡步兵
平衡步兵常见的控制结构(据我所知,开源的代码里大多是这样)是:最里面一个“直立环”,输入是车身倾角和倾角速度,输出轮子的力矩;中间一个“速度环”,输出的是倾角的设定值;最外面再套一个位置环。三个 PID,各自整定,叠在一起能站住。这一篇我想回答一个一直没有人(包括我)认真回答过的问题:这一串 PID,和直接对四个状态做反馈 有多大区别? 我的做法是把对象的拉格朗日模型写出来,线性化,用 LQR 算出 ,再把一串 PID 展开成它的等价 ,放到同一份仿真里比。结果有两处和我预想的不一样:整定好的串级 PID 几乎就是 LQR(代价 6.162 对 6.163),而 LQI 的增益落在串级能表达的范围之外,但它在阶跃上的表现比两个对手都差得多。
这一篇结束时你会有:make ch09 通过,out/ch09/ 下 56 个 CSV(14 个文件,每个 Python、C、C++、Rust 各一份:12 个控制算例、1 个能量自检、1 个增益表),figures/ch09/ 下 5 张图;以及平衡步兵的拉格朗日推导、线性化、LQR 和 LQI 的推导与实验。
新增模块:Python pidlab.mat 和 pidlab.lqr,C pl/mat.h、pl/lqr.h 和对应的 src/mat.c、src/lqr.c,C++ pidlab/mat.h、pidlab/lqr.h,Rust mat.rs、lqr.rs(小矩阵运算、矩阵指数、ZOH 离散化、Riccati 迭代、LQR 增益、LQI 增广)。新增对象 Wip(四种语言的 plants 里)。位置环、速度环、直立环仍是第 5 篇的 Pid,没有新的 PID 变体。
前置:第 5 篇的 Pid、第 7 篇的串级接线和 hold_integral、第 8 篇的矩阵增益 PID。需要的数学:线性化、状态空间、矩阵指数、特征值。
对象:平衡步兵的拉格朗日模型
先说我是怎么避免写错符号的,因为这一节是整篇里最容易默默写错的地方:我从拉格朗日量把两条运动方程完整推了一遍,再用三个数值检查核对(能量守恒、功率平衡、对中心差分的线性化),检查的结果放在“结果”那一节。
对象是平面里的两轮倒立摆:两个轮子合起来当一个轮子(质量 kg,转动惯量 kg·m²,半径 m),车身质量 kg,质心在轮轴上方 m,绕质心的转动惯量 kg·m²,电机力矩上限 10 N·m(这些都是我取的量级,不是实测)。广义坐标取两个:轮子滚过的距离 ,和车身从竖直方向向前倾的角度 ( 表示质心跑到 一侧)。
车身质心的位置是 ,速度分量 和 。动能是轮子的平动加转动、车身质心的平动、车身绕质心的转动:
记 (数值 15 kg)和 (0.88 kg·m²)。 对 不显含,所以 方程的左边只有 :
方程里 这一项在 和 里各出现一次,抵消了:
广义力是符号最容易出错的地方,我用虚功算。电机的力矩 作用在轮子上,同时有一个反作用力矩 作用在车身上,所以虚功是 ,于是 ,。 的意思是轮子向前滚,车身被向后推,和“加速时身体后仰”的日常经验一致。再加一个外力:水平方向的力 作用在车身质心上(后面的 push 算例要用),虚功是 ,所以 多一个 , 多一个 。完整的模型是:
每次求导数的时候解一个 2×2: 乘 等于右边,行列式 在 是 7.44,永远不会是 0(),直接用克莱姆法则。plants.py 里的 Wip.deriv 就是这几行:
def deriv(self, x, u): a, c = self._coefs() ml = self.m * self.l s, co = math.sin(x[2]), math.cos(x[2]) r1 = u[0] / self.r + u[1] + ml * s * x[3] * x[3] r2 = -u[0] + u[1] * self.l * co + ml * self.g * s b = ml * co det = a * c - b * b return [ x[1], (c * r1 - b * r2) / det, x[3], (a * r2 - b * r1) / det, ]r1 和 r2 是两个方程的右边(把 项和重力项移了过去),u 是 ,所以外力是对象的第二个输入,和前几篇“扰动就是多出来的输入”的约定一致。同一个文件里还有 energy,是后面自检要用的动能加势能。
线性化:A 和 B 是怎么出来的
在 附近取 ,,丢掉 ,令 :
记 ,把 2×2 求逆:
代入 ,,,状态取 :
代码把这四个分式原样写出来(只给 这一列,外力 只出现在非线性模型里):
def linearize(self) -> tuple[list[list[float]], list[list[float]]]: """A, B of x' = A x + B tau at phi = 0 (hand derivation, ch09).""" a, c = self._coefs() ml = self.m * self.l mgl = ml * self.g det = a * c - ml * ml amat = [ [0.0, 1.0, 0.0, 0.0], [0.0, 0.0, -ml * mgl / det, 0.0], [0.0, 0.0, 0.0, 1.0], [0.0, 0.0, a * mgl / det, 0.0], ] bmat = [ [0.0], [(c / self.r + ml) / det], [0.0], [-(a + ml / self.r) / det], ] return amat, bmat两个观察。第一, 的特征值是 rad/s:一个不稳定极点,倾倒的时间常数 s,所以控制器必须比这快得多(1 kHz 对这个来说足够)。第二, 的第二项和第四项符号相反: 让轮子向前加速,同时把车身向后推。要让车向前走,一开始得先向后“退”,让车身前倾,再追上去。这是一个非最小相位的系统,阶跃响应里会有一个先反向的小凹坑,后面的图里能看见,凹坑有多深我后面给数。
我不信手推的结果,所以 report 把 和 和 Wip.deriv 的中心差分(步长 )比了一次:最大误差 ,是差分本身的截断误差量级。
离散化:矩阵指数和 ZOH
控制器每 1 ms 跑一次,输入保持不变(第 4 篇的 ZOH),对象 的精确离散化是
两个量可以用一个矩阵指数同时得到:
验证很短:右边那个矩阵的幂级数里,第二列块是 。
矩阵指数我自己写,不调库:缩放平方。先把矩阵除以 ,直到无穷范数不超过 0.5,对缩小后的矩阵做 12 阶泰勒(截断误差大约是 ),再平方 次。Python 版和 scipy.linalg.expm 在 4 个量级( 到 倍的随机 5×5 矩阵)上的最大相对误差是 ,在我设的 容差之内。
pidlab/mat.py 是 LQR 要用的那几个矩阵运算(zeros、identity、mul、add、sub、scale、transpose、max_abs)。矩阵是行列表组成的列表(list[list[float]]),没有用 numpy,因为这是原生版本要逐位对上的参考实现,numpy 和 scipy 只出现在 report 里做核对。里面最重要的是矩阵乘,一个朴素的三重循环,累加顺序后面三种语言都照抄:
def mul(a: Matrix, b: Matrix) -> Matrix: """a (n x k) times b (k x m).""" n, k, m = len(a), len(b), len(b[0]) out = zeros(n, m) for i in range(n): for j in range(m): s = 0.0 for p in range(k): s += a[i][p] * b[p][j] out[i][j] = s return outpidlab/lqr.py 里的 expm 是上面那段话的直译:
def expm(a: Matrix) -> Matrix: """exp(a): scale until ||a||_inf <= 0.5, Taylor to order 12, square.""" n = len(a) nrm = 0.0 for row in a: s = 0.0 for x in row: s += abs(x) nrm = max(nrm, s) squarings = 0 while nrm > 0.5: nrm *= 0.5 squarings += 1 h = scale(a, 0.5**squarings) term = identity(n) out = identity(n) for k in range(1, TAYLOR_ORDER + 1): term = scale(mul(term, h), 1.0 / k) out = add(out, term) for _ in range(squarings): out = mul(out, out) return out求范数用显式的循环累加,不用 sum():Python 3.12 起 sum() 对浮点数用补偿求和,和 C 的朴素累加在最后一位上会不同,虽然在这里只影响“要缩放几次”这个判断,我还是把它对齐了。有了 expm,ZOH 就是把 、 拼成 的块矩阵,乘 ,取指数,再把左上角和右上角切出来:
def c2d_zoh(a: Matrix, b: Matrix, ts: float) -> tuple[Matrix, Matrix]: """Zero-order-hold discretization via exp([[A, B], [0, 0]] ts).""" n, m = len(a), len(b[0]) big = zeros(n + m, n + m) for i in range(n): for j in range(n): big[i][j] = a[i][j] * ts for j in range(m): big[i][n + j] = b[i][j] * ts e = expm(big) ad = [row[:n] for row in e[:n]] bd = [row[n:] for row in e[:n]] return ad, bdLQR:代价函数、Riccati 方程和 Bryson 权重
LQR 要的是在无穷时域里最小化
的状态反馈 。Kalman 在 1960 年的 “Contributions to the theory of optimal control” 里讨论的就是这一类问题(摘要的原话是设计线性控制系统来最小化某个二次函数的积分);我这里用的是离散时间的形式,推导我没有去对原文,下面的递推式是标准结果,由 scipy.linalg.solve_discrete_are 核对。
最优的 由离散代数 Riccati 方程(DARE)的解 给出:
单输入的时候 是标量,求逆就是一次除法,所以增益函数很短:
def lqr_gain(ad: Matrix, bd: Matrix, p: Matrix, r: float) -> Matrix: """K = (R + B'PB)^-1 B'PA as a 1 x n matrix.""" pb = mul(p, bd) s = r + mul(transpose(bd), pb)[0][0] return scale(mul(transpose(pb), ad), 1.0 / s)权重怎么取。 我用的是 Bryson 法则:每个状态(和输入)的权重取“允许的最大值”的平方的倒数,见 UCSB 的一份讲义(我没有去翻 Bryson 和 Ho 的原书)。允许值我取:位置 0.5 m、速度 1 m/s、倾角 0.1 rad、倾角速度 1 rad/s、力矩 10 N·m,于是
怎么解 DARE:一个我踩了的坑。 最直接的做法是从 出发反复套上面那个式子,直到不再变化。我先这么写了,结果它不收敛:最大变化量 在第 4454 步降到最低的 ,然后开始变大,到第 20000 步是 (report 里把这个原始版本留着,单独跑一遍打印出来)。原因我猜是舍入: 和 是两个很大、很接近的量相减,而对象有一个不稳定模态,把相减后剩下的舍入误差一步步放大。
修法是把递推换成一个等价但全是“正半定的项相加”的形式:先用当前的 算出 ,再
等价性两行就能看出来:展开右边得 ,而 (把 的定义代进去),合并后正是 DARE 的右边。收敛判据是 ,上限 200000 步,超过返回错误:
def dare_iterate( ad: Matrix, bd: Matrix, q: Matrix, r: float) -> tuple[Matrix, int]: # ... p = q for it in range(1, MAX_ITER + 1): k = lqr_gain(ad, bd, p, r) acl = sub(ad, mul(bd, k)) kt = transpose(k) pn = add(q, scale(mul(kt, k), r)) pn = add(pn, mul(transpose(acl), mul(p, acl))) done = max_abs(sub(pn, p)) < 1e-12 * (1.0 + max_abs(pn)) p = pn if done: return p, it raise RuntimeError("DARE iteration did not converge")注意 K 在每一步都重新算,这就是上面数学里的稳定形式。1 kHz 下 LQR 要 13067 步,LQI 要 15178 步(慢的原因是最慢的闭环极点在 ,也就是 1.2 s 的时间常数,对 1 ms 的步长来说要迭代上万次)。
这个判据有一个代价:停下来的时候, 离真解还差大约 , 是收敛率,接近 1。实测 Python 的 和 solve_discrete_are 的相对差(除以 )是 LQR 、LQI , 是 和 。都在 的容差内,但只有一倍多的余量,这是停止判据决定的,不是 bug。
LQI:给位置误差加一个积分状态
LQR 的 没有积分:外力持续作用的时候,平衡点会偏。第 1 篇说过,积分项迫使任何稳态的误差为零,LQI 把同一件事放进状态里:增广一个状态 ,让它积分位置误差,
取出位置。对这个五阶系统用同一个 DARE 求解, 多一项 ,得到 的五个分量,最后一个是 。增广本身只有几行,c 是参数,换成别的输出行也能用:
def lqi_augment( ad: Matrix, bd: Matrix, c: Matrix, ts: float) -> tuple[Matrix, Matrix]: """Append z+ = z + ts (x_ref - c x) to the state. c is 1 x n.""" n = len(ad) aa = zeros(n + 1, n + 1) ba = zeros(n + 1, 1) for i in range(n): for j in range(n): aa[i][j] = ad[i][j] ba[i][0] = bd[i][0] aa[n][i] = -ts * c[0][i] aa[n][n] = 1.0 return aa, ba我把参考也放进了比例项:,等价于把状态平移到参考点(平衡步兵在任何位置都是平衡点,平移不改变动力学)。力矩饱和时冻结 (和第 5 篇的 CLAMP 同一个思路)。设计的入口在驱动 ch09_lqr.py 的 design() 里,把上面几个函数串起来:线性化,离散化,LQR 的 4 阶 DARE,LQI 的 5 阶 DARE:
def design() -> dict: """Discretize the linearization and solve LQR and LQI.""" a, b = Wip().linearize() ad, bd = c2d_zoh(a, b, TS) p4, it4 = dare_iterate(ad, bd, q_matrix(4), R) k4 = lqr_gain(ad, bd, p4, R) aa, ba = lqi_augment(ad, bd, [[1.0, 0.0, 0.0, 0.0]], TS) p5, it5 = dare_iterate(aa, ba, q_matrix(5), R) k5 = lqr_gain(aa, ba, p5, R) # ...串级 PID 是一个受限的状态反馈
现在回到开头的问题。串级的三个环,用第 5 篇的 Pid 搭:
直立环的符号要说一下。从上面线性化的结果看,倾角 (质心在前)的时候要让轮子向前滚()去追质心,也就是 ,。第 5 篇的 Pid 算的是 ,所以直立环的 kp、kd 取负数: 和 (Pid 允许负增益,第 8 篇 Wood–Berry 的回路 2 就用过)。D 项作用在测量上(c = 0),所以 项是 。速度环输出倾角设定值:想前进更快,就把车身往前倾,,,位置环 。接线和第 7 篇一样:外环的输出是内环的设定值,速度环的 hold_integral 是直立环上一拍的 saturated:
class Cascade: """Position P -> velocity PI -> pitch PD, all from the ch05 Pid."""
def __init__(self, g: dict) -> None: lim = Wip().tau_max self.pos = Pid(PidConfig(g["kx"], 0.0, 0.0, TS)) self.vel = Pid(PidConfig(g["kv"], g["ki"], 0.0, TS)) # u = P phi + D phid: the pitch loop has negative gains self.pit = Pid( PidConfig(-g["p"], 0.0, -g["d"], TS, u_min=-lim, u_max=lim) )
def update(self, x: list[float], xref: float) -> float: vref = self.pos.update(xref, x[0]) phiref = self.vel.update(vref, x[1], 0.0, self.pit.saturated) return self.pit.update(phiref, x[2])把三层展开,:
积分 ( 就是上一节 LQI 的 )。整理成 :
(差一个只取决于 的常值力矩,tilt 和 push 里它是 0,阶跃里它等价于积分器的初值不同。)这几个等式在代码里就是 cascade_equivalent,五个增益换成 的五个分量:
def cascade_equivalent(g: dict) -> list[float]: # ... p, d = g["p"], g["d"] return [ -p * (g["kv"] * g["kx"] + g["ki"]), -p * g["kv"], -p, -d, p * g["ki"] * g["kx"], ]一串 PID 就是一个状态反馈,五个增益对应 的五个分量。 这是“PID 是 LQI 的一个受限子集”这句话的准确含义。受限在哪?五个参数 对五个分量,看起来够,但中间有一个二次方程:已知一个目标 ,,, 直接得到;剩下 和 要求
没有实根的时候,这个 就是任何一组串级增益都够不着的。 判别式 是 LQI 的 能不能被串级复现的判据。LQI 的 是 ,算出来 ,,,判别式是 。没有实根。离它最近的串级取判别式的顶点,,,这样前四个分量和 LQI 完全一样, 只有 11.72(LQI 是 19.34)。nearest_cascade 就是在做这个判断:
def nearest_cascade(k: list[float]) -> dict: # ... p, d = -k[2], -k[3] kv = k[1] / k[2] alpha = k[0] / k[2] beta = -k[4] / k[2] disc = alpha * alpha - 4.0 * kv * beta kx = ( (alpha + math.sqrt(disc)) / (2.0 * kv) if disc >= 0.0 else (alpha / (2.0 * kv)) ) return {"kx": kx, "kv": kv, "ki": alpha - kv * kx, "p": p, "d": d}整定。 五个增益我交给 scipy.optimize.minimize(method="Nelder-Mead"),目标是 在 step 算例里的值(和 LQR 同一个代价,状态取相对参考的偏差),从上面这组“最接近 LQI”的增益出发,五个增益都限制非负,maxiter=4000。优化过程中仿真用每个采样一步 RK4(正式的仿真是每个采样 10 步)。关键就是这一段:
x0 = [start[n] for n in names] res = minimize( cost, x0, method="Nelder-Mead", bounds=[(0.0, None)] * 5, # no negative gains: no positive feedback options={"maxiter": 4000}, )把算出来的增益写进 data/ch09_cascade_gains.csv,三个原生程序从里面读,不自己重整定。
仿真:同一个循环,三个控制器
LQR 和 LQI 是同一个类,integral 标志区分:
class StateFeedback: """u = -K (x - x_ref e0) (- k_z z): LQR when k_z is 0, LQI otherwise."""
def __init__(self, k: list[float], integral: bool) -> None: self.k = k self.integral = integral self.z = 0.0 self.lim = Wip().tau_max
def update(self, x: list[float], xref: float) -> float: xt = [x[0] - xref, x[1], x[2], x[3]] s = 0.0 for i in range(4): s += self.k[i] * xt[i] if self.integral: s += self.k[4] * self.z v = -s u = min(max(v, -self.lim), self.lim) if self.integral and u == v: self.z -= TS * xt[0] return uu == v 就是“没有饱和”,只有没饱和的时候才积分,这是冻结 的全部实现。仿真函数本身:
def simulate( name: str, gains: dict, data: dict, substeps: int = SUBSTEPS,) -> dict[str, np.ndarray]: plant = Wip() plant.m *= float(data["mscale"][0]) ctl = make_controller(name, gains) x = [0.0, 0.0, float(data["phi0"][0]), 0.0] rows = [] for k in range(len(data["t"])): tau = ctl.update(x, data["xref"][k]) rows.append([data["t"][k], *x, tau]) x = advance(plant.deriv, x, [tau, data["force"][k]], TS, substeps) if abs(x[2]) > 3.0: # fallen over: freeze (the loop is not a model x[2] = math.copysign(3.0, x[2]) # of lying on the floor) x[3] = 0.0 return dict(zip(COLUMNS, np.array(rows, dtype=float).T))循环顺序和第 1 篇定的约定一样:先用当前状态算控制量,写一行记录(tau 是限幅后实际作用的力矩),再保持力矩和外力不变积分 10 个 RK4 步。mscale 只放大对象的质量,控制器仍然按 kg 设计,mass130 算例就靠它。倾角超过 3 rad 的时候把它冻在 3 rad 上,免得倒下去之后的数值没有意义,本章所有算例都没有走到这一步(report 断言了 )。
四个算例(tilt、step、push、mass130)和它们的参考、外力、初始倾角、质量比例都由 Python 的 scenario_table 写进 data/ch09_<case>.csv,三个原生程序只读。
C、C++、Rust 实现
两个新模块和新对象是 Python 版的逐行翻译,三种语言的 ch09 应用也是 Python 驱动的逐行翻译:同样的算例表、同样的接线,读同一份数据,自己算 LQR 和 LQI 的 ,写进 gains_<lang>.csv 和 Python 的对比。区别在这几处:
- 矩阵的存放。 C 是平铺的行优先数组加维数参数:
pl_mat_mul(a, b, n, k, m, out),调用者提供所有数组,上限PL_MAX_DIM(8),输出不能和输入重叠;超过上限的pl_expm、pl_c2d_zoh、pl_dare_iterate返回-EINVAL,不收敛返回-ERANGE。C++ 是Mat<T, R, C>(std::array<std::array<T, C>, R>)加模板,维数在类型里,写错了编译不过。Rust 是[[Real; C]; R]加 const 泛型。三种语言都没有堆分配(csv.c除外)。 - 增广一维。
c2d_zoh要在 阶系统上做 阶的指数,lqi_augment要把 阶变成 阶。C 的数组长度是运行时的,没有问题。C++ 可以直接写Mat<T, N + 1, N + 1>。Rust 稳定版不能在类型里写N + 1(generic_const_exprs还没稳定),所以这两个函数多一个 const 参数M,调用的时候写c2d_zoh::<4, 5>,函数内部检查M == N + 1,不对就返回None。我没有找到更干净的写法。 - 失败的处理。
dare_iterate:C 是-ERANGE,C++ 是std::optional<DareResult<T, N>>(结果里有 和迭代次数),Rust 是Option<(Mat<N, N>, usize)>,Python 抛RuntimeError。 - 能量自检。 三种语言的 ch09 应用在做任何别的事之前,先跑 、、没有阻尼的 2 s 自由落体(,RK4,),相对能量漂移超过 就退出码 1。每一步都检查,不只是写进文件的那 201 行。
- 标量类型。 这一篇仍是
double(pl_real、T、Real),但mat.c和lqr.c里的字面量我都写成了跟着pl_real走的形式(HALF、ONE、DARE_TOL三个宏),因为我想看它们在-DPL_USE_FLOAT -Wdouble-promotion下过不过。下面“编译和风格检查”里说结果。
C
矩阵乘是整个 LQR 的基础,一个朴素的三重循环,累加顺序和 Python 一致:
void pl_mat_mul(const pl_real *a, const pl_real *b, int n, int k, int m, pl_real *out){ int i, j, p;
for (i = 0; i < n; i++) { for (j = 0; j < m; j++) { pl_real s = 0.0;
for (p = 0; p < k; p++) s += a[i * k + p] * b[p * m + j]; out[i * m + j] = s; } }}pl_expm 里的缩放因子 f 是在循环里一次次乘 HALF 得到的,不调 pow,所以和 Python 的 0.5**squarings 逐位相同(2 的幂是精确的):
int pl_expm(const pl_real *a, int n, pl_real *out){ pl_real h[MAT_SIZE], term[MAT_SIZE], tmp[MAT_SIZE]; pl_real nrm = 0.0, f = ONE; int squarings = 0, i, j, k;
if (n < 1 || n > PL_MAX_DIM) return -EINVAL; for (i = 0; i < n; i++) { pl_real row = 0.0;
for (j = 0; j < n; j++) row += PL_FABS(a[i * n + j]); if (row > nrm) nrm = row; } while (nrm > HALF) { nrm *= HALF; f *= HALF; squarings++; } pl_mat_scale(a, f, n, n, h); pl_mat_identity(n, term); pl_mat_identity(n, out); for (k = 1; k <= TAYLOR_ORDER; k++) { pl_mat_mul(term, h, n, n, n, tmp); pl_mat_scale(tmp, 1.0 / k, n, n, term); pl_mat_add(out, term, n, n, tmp); for (i = 0; i < n * n; i++) out[i] = tmp[i]; } for (k = 0; k < squarings; k++) { pl_mat_mul(out, out, n, n, n, tmp); for (i = 0; i < n * n; i++) out[i] = tmp[i]; } return 0;}Riccati 迭代拆成两个函数:dare_step 做一步,返回 ;pl_dare_iterate 管循环和判据。dare_step 里的临时矩阵是栈上的 数组:
/* One step of the stabilized Riccati map; returns max|P+ - P|. */static pl_real dare_step(const pl_real *ad, const pl_real *bd, const pl_real *q, pl_real r, int n, const pl_real *cur, pl_real *nxt){ pl_real k[PL_MAX_DIM], acl[MAT_SIZE], t1[MAT_SIZE], t2[MAT_SIZE]; pl_real t3[MAT_SIZE];
pl_lqr_gain(ad, bd, cur, r, n, k); pl_mat_mul(bd, k, n, 1, n, t1); pl_mat_sub(ad, t1, n, n, acl); /* A - BK */ pl_mat_transpose(k, 1, n, t1); pl_mat_mul(t1, k, n, 1, n, t2); pl_mat_scale(t2, r, n, n, t3); pl_mat_add(q, t3, n, n, t1); /* Q + K'RK */ pl_mat_mul(cur, acl, n, n, n, t2); pl_mat_transpose(acl, n, n, t3); pl_mat_mul(t3, t2, n, n, n, acl); pl_mat_add(t1, acl, n, n, nxt); pl_mat_sub(nxt, cur, n, n, t1); return pl_mat_max_abs(t1, n, n);}int pl_dare_iterate(const pl_real *ad, const pl_real *bd, const pl_real *q, pl_real r, int n, pl_real *p, int *iters){ pl_real cur[MAT_SIZE], nxt[MAT_SIZE], diff; int it, i;
if (n < 1 || n > PL_MAX_DIM) return -EINVAL; for (i = 0; i < n * n; i++) cur[i] = q[i]; for (it = 1; it <= PL_DARE_MAX_ITER; it++) { diff = dare_step(ad, bd, q, r, n, cur, nxt); for (i = 0; i < n * n; i++) cur[i] = nxt[i]; if (diff < DARE_TOL * (ONE + pl_mat_max_abs(cur, n, n))) { for (i = 0; i < n * n; i++) p[i] = cur[i]; *iters = it; return 0; } } return -ERANGE;}对象在 plants.c,和 Python 的 Wip.deriv 同样的表达式顺序(这是 C 和 Python 逐位一致的前提):
void pl_wip_deriv(const void *ctx, const pl_real *x, const pl_real *u, pl_real *dx){ const struct pl_wip *p = ctx; pl_real a = p->mw + p->iw / (p->r * p->r) + p->m; pl_real c = p->ib + p->m * p->l * p->l; pl_real ml = p->m * p->l; pl_real s = PL_SIN(x[2]); pl_real co = PL_COS(x[2]); pl_real r1 = u[0] / p->r + u[1] + ml * s * x[3] * x[3]; pl_real r2 = -u[0] + u[1] * p->l * co + ml * p->g * s; pl_real b = ml * co; pl_real det = a * c - b * b;
dx[0] = x[1]; dx[1] = (c * r1 - b * r2) / det; dx[2] = x[3]; dx[3] = (a * r2 - b * r1) / det;}自检的函数在 apps/ch09.c,每一步都比较:
/* Energy must stay put with tau = 0, no damping and no force. */static int energy_check(void){ struct pl_wip p; pl_real x[PL_MAX_STATES] = { 0, 0, E_PHI0, 0 }; const pl_real u[PL_WIP_M] = { 0.0, 0.0 }; pl_real e0, worst = 0.0; double out[E_ROWS * 3]; int k, ret;
pl_wip_init(&p); e0 = pl_wip_energy(&p, x); for (k = 0; k <= E_STEPS; k++) { pl_real e_rel = (pl_wip_energy(&p, x) - e0) / e0;
if (PL_FABS(e_rel) > worst) worst = PL_FABS(e_rel); /* ... every E_EVERY steps: record t, phi, e_rel ... */ if (k < E_STEPS) pl_rk4_step(pl_wip_deriv, &p, x, u, PL_WIP_N, E_H); } printf("energy check: max |dE/E0| = %.3e over %g s (limit %.0e)\n", (double)worst, E_STEPS * E_H, E_TOL); if (worst >= E_TOL) return -EDOM; /* ... write out/ch09/energy_c.csv ... */}完整应用:c/apps/ch09.c。
C++
Mat 是别名模板,Mul 的三个维数参数 N, K, M 由两个实参推出来,维数对不上的乘法编译不过:
// R x C matrix, row-major.template <class T, std::size_t R, std::size_t C>using Mat = std::array<std::array<T, C>, R>;
template <class T, std::size_t N, std::size_t K, std::size_t M>Mat<T, N, M> Mul(const Mat<T, N, K>& a, const Mat<T, K, M>& b) { Mat<T, N, M> out; for (std::size_t i = 0; i < N; ++i) { for (std::size_t j = 0; j < M; ++j) { T s = T(0); for (std::size_t p = 0; p < K; ++p) s += a[i][p] * b[p][j]; out[i][j] = s; } } return out;}Expm 和 DareIterate 是 Python 版的逐行翻译,模板参数 T(默认 double)和 N(状态维数)由实参推出来:
// exp(a): scale until the infinity norm is at most 0.5, Taylor series to// order 12, square back.template <class T, std::size_t N>Mat<T, N, N> Expm(const Mat<T, N, N>& a) { T nrm = T(0); for (const auto& row : a) { T s = T(0); for (T v : row) s += std::fabs(v); nrm = s > nrm ? s : nrm; } int squarings = 0; T f = T(1); while (nrm > T(0.5)) { nrm *= T(0.5); f *= T(0.5); ++squarings; } const Mat<T, N, N> h = Scale(a, f); Mat<T, N, N> term = Identity<T, N>(); Mat<T, N, N> out = Identity<T, N>(); for (int k = 1; k <= 12; ++k) { term = Scale(Mul(term, h), T(1) / T(k)); out = Add(out, term); } for (int k = 0; k < squarings; ++k) out = Mul(out, out); return out;}// Iterates P <- Q + K'RK + (A - BK)'P(A - BK) with K from the current P,// starting at P = Q, until max|dP| < 1e-12 (1 + max|P|). Returns// std::nullopt after kDareMaxIter steps.template <class T, std::size_t N>std::optional<DareResult<T, N>> DareIterate(const Mat<T, N, N>& ad, const Mat<T, N, 1>& bd, const Mat<T, N, N>& q, T r) { Mat<T, N, N> p = q; for (int it = 1; it <= kDareMaxIter; ++it) { const Mat<T, 1, N> k = LqrGain(ad, bd, p, r); const Mat<T, N, N> acl = Sub(ad, Mul(bd, k)); Mat<T, N, N> pn = Add(q, Scale(Mul(Transpose(k), k), r)); pn = Add(pn, Mul(Transpose(acl), Mul(p, acl))); const bool done = MaxAbs(Sub(pn, p)) < T(1e-12) * (T(1) + MaxAbs(pn)); p = pn; if (done) return DareResult<T, N>{p, it}; } return std::nullopt;}对象是 Wip<T> 结构体,Deriv 返回 std::array<T, 4>,驱动里用 lambda 包装给 Advance:
std::array<T, kN> Deriv(const std::array<T, kN>& x, const std::array<T, kM>& u) const { const T a = mw + iw / (r * r) + m; const T c = ib + m * l * l; const T ml = m * l; const T s = std::sin(x[2]); const T co = std::cos(x[2]); const T r1 = u[0] / r + u[1] + ml * s * x[3] * x[3]; const T r2 = -u[0] + u[1] * l * co + ml * g * s; const T b = ml * co; const T det = a * c - b * b; return {x[1], (c * r1 - b * r2) / det, x[3], (a * r2 - b * r1) / det};}完整应用:cpp/apps/ch09.cc。
Rust
const 泛型让矩阵运算的签名和数学一致:mul 是 Mat<N, K> * Mat<K, M> -> Mat<N, M>。c2d_zoh 的 M = N + 1 问题前面说过,这是它的样子:
/// ZOH discretization of `x' = a x + b u` through `exp([[A, B], [0, 0]] ts)`./// `M` must be `N + 1`.pub fn c2d_zoh<const N: usize, const M: usize>( a: &Mat<N, N>, b: &Mat<N, 1>, ts: Real,) -> Option<(Mat<N, N>, Mat<N, 1>)> { if M != N + 1 { return None; } let mut big = [[0.0; M]; M]; for i in 0..N { for j in 0..N { big[i][j] = a[i][j] * ts; } big[i][N] = b[i][0] * ts; } let e = expm(&big); let mut ad = [[0.0; N]; N]; let mut bd = [[0.0; 1]; N]; for i in 0..N { for j in 0..N { ad[i][j] = e[i][j]; } bd[i][0] = e[i][N]; } Some((ad, bd))}/// Iterates `P <- Q + K'RK + (A - BK)'P(A - BK)` with `K` from the current/// `P`, starting at `P = Q`, until `max|dP| < 1e-12 (1 + max|P|)`. Returns/// `P` and the iteration count, or `None` after `DARE_MAX_ITER` steps.pub fn dare_iterate<const N: usize>( ad: &Mat<N, N>, bd: &Mat<N, 1>, q: &Mat<N, N>, r: Real,) -> Option<(Mat<N, N>, usize)> { let mut p = *q; for it in 1..=DARE_MAX_ITER { let k = lqr_gain(ad, bd, &p, r); let acl = sub(ad, &mul(bd, &k)); let mut pn = add(q, &scale(&mul(&transpose(&k), &k), r)); pn = add(&pn, &mul(&transpose(&acl), &mul(&p, &acl))); let done = max_abs(&sub(&pn, &p)) < 1e-12 * (1.0 + max_abs(&pn)); p = pn; if done { return Some((p, it)); } } None}对象 Wip 是一个普通的结构体,deriv 取 &[Real; 4] 和 &[Real; 2],返回 [Real; 4]:
pub fn deriv(&self, x: &[Real; 4], u: &[Real; 2]) -> [Real; 4] { let a = self.mw + self.iw / (self.r * self.r) + self.m; let c = self.ib + self.m * self.l * self.l; let ml = self.m * self.l; let s = sin(x[2]); let co = cos(x[2]); let r1 = u[0] / self.r + u[1] + ml * s * x[3] * x[3]; let r2 = -u[0] + u[1] * self.l * co + ml * self.g * s; let b = ml * co; let det = a * c - b * b; [x[1], (c * r1 - b * r2) / det, x[3], (a * r2 - b * r1) / det]}完整应用:rust/src/bin/ch09.rs。
编译和风格检查
编译参数和前几篇一样:C 是 gcc -std=c11 -O2 -Wall -Wextra -Wpedantic -Werror(15.3.0),C++ 是 g++ -std=c++20 加同样的警告,Rust 是 rustc 1.95.0、edition 2024,cargo clippy --release -- -D warnings。风格检查:C 用内核的 checkpatch.pl(--no-tree,忽略 SPDX 和 typedef 两项),0 errors、0 warnings;C++ 用 clang-format 的 Google 风格(-Werror);Python 用 ruff format --check 和 ruff check,行宽 79;Rust 用 cargo fmt --check。四项都在提交前过了。
两个额外检查。第一,mat.c 和 lqr.c 在 -DPL_USE_FLOAT -Wdouble-promotion -Werror 下能编译(要用 HALF 这几个宏,直接写 0.5 会被报 float 提升成 double);plants.c 过不了这个检查,因为前面几篇的对象里就有 0.5 * h 这种写法,我没有为它改旧代码。需要说清楚:能编译不等于能用。 我另写了一个 15 行的 C 程序,用 -DPL_USE_FLOAT 把 LQR 的 4 阶 DARE 跑了一遍:它在 9134 步停下来(double 是 13067 步), 是 17131.5,double 的是 17131.1,相对差 。 的判据在 float 下达不到,它还是停了,我猜是迭代在 float 的精度上卡住不动了。这个 的精度我没有量。LQR 的增益本来就应该在 PC 上算好再写进 MCU,上车的代码只需要 那几次乘加,这是第 10 篇的事。第二,cargo build --lib --features f32 能过:库本身是 no_std 兼容的,mat.rs 和 lqr.rs 没有引入任何新依赖。
checkpatch.pl 这次没有重现第 8 篇的那个误报(它对 pl_real 的第一次使用报间距),因为 mat.h 里 PL_MAX_DIM 的 #define 在 pl_real 的第一次使用之前。这一回是我碰巧按第 8 篇学到的做法排的序,不是修了什么。
结果
make ch09 一次跑完(Python 的 ref 里有 Nelder–Mead 的约 930 次仿真,加上 DARE,整套大约 100 秒,三个原生程序各约 0.1 到 0.2 秒(含 DARE 和写文件))。14 个文件,每种语言 14 个,42 个对比文件,最大差异 (push_cascade_rs.csv),出现在 Rust 的串级里,我猜是 libm 和 glibc 的 sin、cos 在最后一位上的差别在 5 秒的仿真里累积。下面的输出裁掉了中间 36 行 ok;三个原生程序的能量自检、迭代次数完全一样,DARE 的迭代次数(13067 和 15178)在三种语言里一步不差:
$ make -s ch09energy check: max |dE/E0| = 1.063e-13 over 2 s (limit 1e-06)DARE iterations: LQR 13067, LQI 15178ch09: C wrote 12 cases to out/ch09energy check: max |dE/E0| = 1.063e-13 over 2 s (limit 1e-06)DARE iterations: LQR 13067, LQI 15178ch09: C++ wrote 12 cases to out/ch09energy check: max |dE/E0| = 1.063e-13 over 2 s (limit 1e-6)DARE iterations: LQR 13067, LQI 15178ch09: Rust wrote 12 cases to out/ch09ok energy_c.csv: max diff 0.000e+00 <= 1.0e-09ok energy_cpp.csv: max diff 0.000e+00 <= 1.0e-09ok energy_rs.csv: max diff 7.898e-16 <= 1.0e-09... (中间 36 行 ok 省略)ok tilt_lqr_c.csv: max diff 0.000e+00 <= 1.0e-09ok tilt_lqr_cpp.csv: max diff 0.000e+00 <= 1.0e-09ok tilt_lqr_rs.csv: max diff 0.000e+00 <= 1.0e-09
Wip: A, B from the Lagrange model; ts = 0.001 s, Q = diag(4.0, 1.0, 100.0, 1.0), R = 0.01, q_z = 4energy, tau = 0, h = 0.0001, 2 s: max |dE/E0| = 1.063e-13 same run at h = 1e-3 (2000 steps): max = 9.897e-10torque and force on, 3 s: max |E - E0 - W| = 3.181e-12 Jsign check, tau = +1 at rest: xdd = +1.5054, phidd = -5.2419A, B vs central differences: max error 4.47e-11A =[[ 0. 1. 0. 0. ] [ 0. 0. -7.59483871 0. ] [ 0. 0. 0. 1. ] [ 0. 0. 47.46774194 0. ]]B^T = [ 0. 1.50537634 0. -5.24193548]open-loop poles (rad/s): [-6.89 0. 0. 6.89]
expm vs scipy.linalg.expm: max relative error 2.51e-13LQR: 13067 iterations, P vs solve_discrete_are 6.53e-10, K vs scipy 3.07e-10 (relative to the max entry)LQI: 15178 iterations, P vs solve_discrete_are 4.53e-10, K vs scipy 1.99e-10 (relative to the max entry)textbook form A'PA - A'PB (R + B'PB)^-1 B'PA: max|dP| bottoms out at 4.2e-02 (step 4454), then grows to 4.9e+44 by step 20000; the stabilized form converged in 13067
LQR gain K (u = -K x), x = [x, xd, phi, phid]:[ -19.3507 -29.8702 -133.6297 -20.8277]LQI gain (last entry is k_z):[ -46.3429 -45.8187 -150.3896 -25.5436 19.3436]
cascade mapping: P = 150.390, D = 25.544, kv = 0.3047, alpha = 0.3082, beta = 0.1286, discriminant alpha^2 - 4 kv beta = -0.0618nearest cascade gains: kx = 0.5057, kv = 0.3047, ki = 0.1541, p = 150.3896, d = 25.5436Nelder-Mead: 596 iterations, 932 evaluations, cost 6.318 -> 6.162tuned cascade gains: kx = 0.6546, kv = 0.2174, ki = 1.528e-12, p = 119.6, d = 17.76equivalent K = [K_x, K_xd, K_phi, K_phid, K_z]: LQI [ -46.343 -45.819 -150.390 -25.544 19.344] cascade (tuned) [-1.702e+01 -2.600e+01 -1.196e+02 -1.776e+01 1.196e-10] cascade (nearest) [ -46.343 -45.819 -150.390 -25.544 11.718]
LQR max |eig| = 0.999158 slowest decay 0.842 1/s (tau = 1.19 s)LQI max |eig| = 0.999235 slowest decay 0.765 1/s (tau = 1.31 s)cascade (tuned, no I) max |eig| = 0.999185 slowest decay 0.816 1/s (tau = 1.23 s)cascade (nearest to LQI) max |eig| = 0.999642 slowest decay 0.358 1/s (tau = 2.80 s)
tilt: phi0 = 0.15 rad, x_ref = 0ctl |tau| max sat ms x max x end phi<0.01 atcascade 10.00 18 0.082 -0.0020 1.049lqr 10.00 18 0.084 -0.0017 1.080lqi 10.00 22 0.075 -0.0090 0.973
step: x_ref = 1 m at 0.5 sctl overshoot% x min x end t95 (s) phi max |tau| max sat mscascade 2.7 -0.033 1.027 3.52 0.135 10.00 13lqr 2.2 -0.032 1.022 3.55 0.134 10.00 14lqi 38.8 -0.072 1.132 nan 0.299 10.00 45
mass130: x_ref = 1 m at 0.5 sctl overshoot% x min x end t95 (s) phi max |tau| max sat mscascade 2.1 -0.030 1.021 3.52 0.135 10.00 13lqr 1.8 -0.029 1.018 3.56 0.133 10.00 13lqi 37.9 -0.065 1.131 nan 0.297 10.00 42
push: 10 N on the body COM from 2.0 sctl x @3 s x @4 s x @5 s x max phi @5 s tau @5 scascade 0.293 0.632 0.802 0.802 -0.1469 -1.1813lqr 0.292 0.625 0.791 0.791 -0.1462 -1.1748lqi 0.248 0.339 0.228 0.343 -0.1296 -1.0185
step-scenario cost sum (x'Qx + R tau^2) ts (substeps = 1) cascade (tuned) 6.162 cascade (nearest to LQI) 6.318 lqr 6.163 lqi 10.783
push equilibrium for LQR: tau = -1.000 N m, phi = -0.1271 rad, x = 0.8259 mcascade 30 s: x(10 s) = +0.8343, x(20 s) = +0.8344, x(30 s) = +0.8344, phi(30 s) = -0.1271lqr 30 s: x(10 s) = +0.8260, x(20 s) = +0.8259, x(30 s) = +0.8259, phi(30 s) = -0.1271lqi 30 s: x(10 s) = -0.0011, x(20 s) = +0.0000, x(30 s) = -0.0000, phi(30 s) = -0.1271cascade_map 30 s: x(10 s) = +0.0446, x(20 s) = +0.0012, x(30 s) = +0.0000, phi(30 s) = -0.1271cascade (nearest) vs state feedback with its equivalent K, push: max |dx| = 8.67e-05 m over 5 s
mass sweep (linear, fixed gains, no saturation): stable for s in lqr 0.2 to 14.8 (contiguous) lqi 0.2 to 15.2 (contiguous) cascade (tuned, no I) 0.2 to 13.2 (contiguous) cascade (nearest to LQI) 0.2 to 15.2 (contiguous)
step, 30 s run (Python only) cascade peak x = 1.0268 at 5.04 s (overshoot 2.7%), x(30 s) = 1.00000 lqr peak x = 1.0226 at 5.11 s (overshoot 2.3%), x(30 s) = 1.00000 lqi peak x = 1.3884 at 3.19 s (overshoot 38.8%), x(30 s) = 1.00000figure: figures/ch09/energy-check.svgfigure: figures/ch09/step-compare.svgfigure: figures/ch09/push-offset.svgfigure: figures/ch09/mass-mismatch.svgfigure: figures/ch09/gain-structure.svg
ch09 OK模型对得上吗
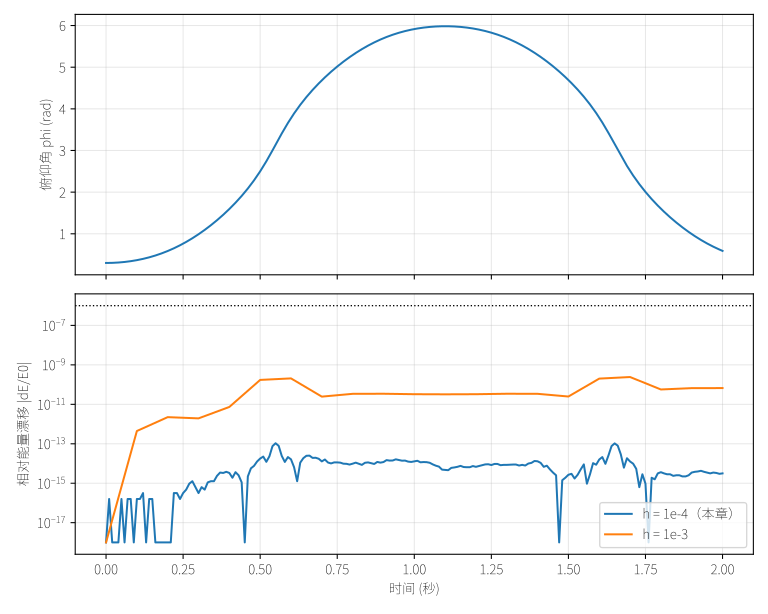
上图是原生程序启动时的自检(也是 Python 的 energy_run): rad,,没有阻尼,车身倒下去,0.4 s 过了水平,到 2 s 一路摆到了对面: 的最大值是 5.9832 rad,正好是 ,也就是几乎回到起点的高度,这是能量守恒最直观的证据。相对能量漂移最大 ,是舍入量级。步长放大 10 倍(,等于每个控制周期只积分一步,不做子步)最大漂移是 ,仍然在 以下,所以对这个对象,每个周期积分 10 步已经是很宽的余量,积分器不会是误差来源。
能量守恒只能说明 和 对应的运动方程自洽,说明不了广义力的符号。所以还有一个检查:施加 和 跑 3 s,把电机和外力做的功 当作第五个状态一起积分,最大的 是 J。 静止出发的加速度是 、,和手推的 的第二、第四项 、 一致,符号也对:向前滚,车身向后。模型的符号没有错。
增益和闭环极点
LQR 的 (,状态 )是 ,LQI 是 。倾角分量是 :倾 0.1 rad 就要 13 N·m,超过了 10 N·m 的上限,所以后面的 tilt 和 step 一开始都会撞限幅。四个闭环(LQR、LQI、整定后的串级、最接近 LQI 的串级)的离散特征值模都小于 1,最慢的极点:
| 闭环 | 最大 | 最慢衰减 | 时间常数 |
|---|---|---|---|
| LQR | 0.999158 | 0.842 /s | 1.19 s |
| LQI | 0.999235 | 0.765 /s | 1.31 s |
| 串级(整定后,无积分) | 0.999185 | 0.816 /s | 1.23 s |
| 串级(最接近 LQI 的增益) | 0.999642 | 0.358 /s | 2.80 s |
最慢极点都在 1 s 以上,和 (位置只惩罚了 0.5 m 对应的权重)有关:位置回路在设计上就是慢的,这个时间常数决定了后面几乎所有的“5 秒里没到”。
倾倒、阶跃:三个控制器几乎一样(除了 LQI)
tilt: rad,位置参考 0。三个控制器都先把力矩打满 10 N·m,然后拉回:
| 控制器 | 峰值 | 饱和时间 | 最大 | 5 s 末 | 的时刻 |
|---|---|---|---|---|---|
| 串级 | 10.00 N·m | 18 ms | 0.082 m | −0.0020 m | 1.049 s |
| LQR | 10.00 N·m | 18 ms | 0.084 m | −0.0017 m | 1.080 s |
| LQI | 10.00 N·m | 22 ms | 0.075 m | −0.0090 m | 0.973 s |
三个都稳。倾 0.15 rad 要 20 N·m 的线性反馈,实际只给 10,饱和了 18 到 22 ms,在不稳定极点 6.89 rad/s 下这点时间还救得回来。
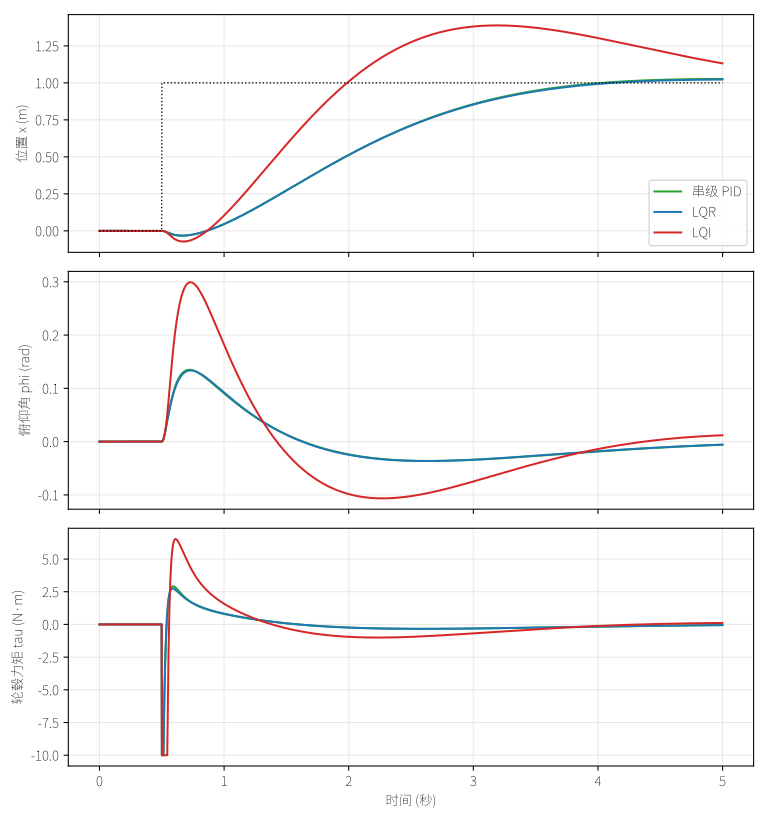
step:0.5 s 时位置参考从 0 跳到 1 m。上图的三条曲线里串级(绿)和 LQR(蓝)几乎盖在一起:
| 控制器 | 超调(5 s 窗口) | 超调(30 s) | 最小 (凹坑) | 5 s 末 | 进入 ±5% | 峰值 | 饱和时间 |
|---|---|---|---|---|---|---|---|
| 串级 | 2.7% | 2.7%(5.04 s) | −0.033 m | 1.027 m | 3.52 s | 0.135 rad | 13 ms |
| LQR | 2.2% | 2.3%(5.11 s) | −0.032 m | 1.022 m | 3.55 s | 0.134 rad | 14 ms |
| LQI | 38.8% | 38.8%(3.19 s) | −0.072 m | 1.132 m | 5 s 内没有 | 0.299 rad | 45 ms |
两个观察。凹坑是非最小相位。 前面推 的时候说了, 对 和 的作用符号相反:LQR 在 0.665 s 的时候 凹到 m,力矩一开始是 N·m,让轮子向后滚、车身向前倾,然后车才往前去。这个凹坑是对象的性质,不是控制器的:任何增益都躲不掉(只能调大小),三个控制器都有。LQI 的 38.8% 超调是积分器的账。 我原本以为 LQI 只是 LQR 加了抗扰能力,阶跃成绩应该差不多,结果不是。阶跃之后位置要到 2 s 左右才越过 1 m,这 1.5 s 里位置误差一直是 m, 积了一大块,然后要靠“位置冲过头”来还。30 s 里它也回到了 1.00000,只是 5 秒的窗口看不到。LQI 的阶跃代价()是 10.783,LQR 是 6.163,LQI 是 LQR 的 1.75 倍:积分作用买的是抗扰,不是阶跃的成绩。我没有去扫 压这个超调, 是我设的第一个值,扫它是另一个实验。
推一把:LQR 偏离 0.826 m,LQI 能拉回来,但 5 秒不够
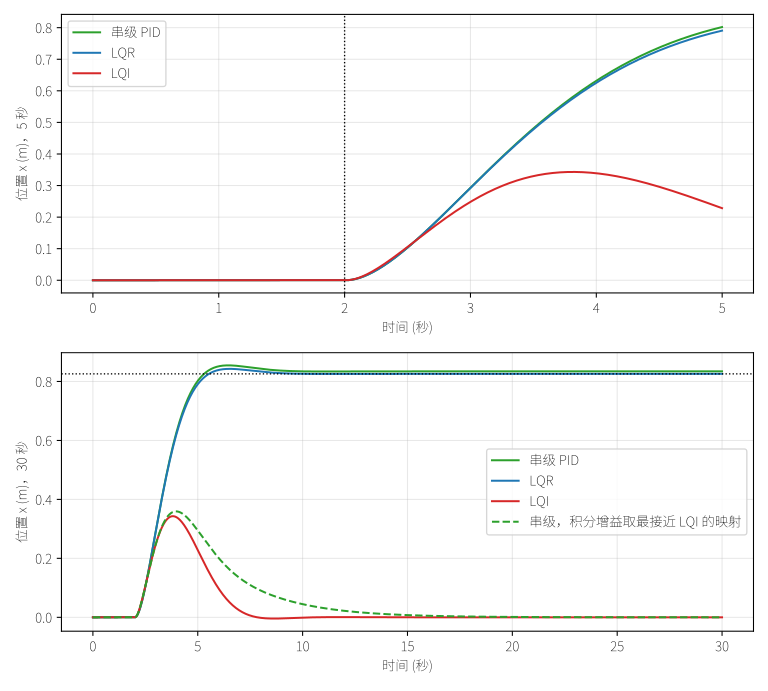
push:2.0 s 起,一个 10 N 的水平力作用在车身质心上。要平衡住,稳态必须满足 N·m(第一个运动方程),倾角由第二个方程 定: rad,车身向后仰着顶住这股力。然后 LQR 的 要产生 N·m 的力矩,,解出 m。这个预言在 30 s 的仿真里得到了:LQR 的 ,,和预测一致到小数点后四位。
| 控制器 | @3 s | @4 s | @5 s | 最大 | @5 s | @10 s | @30 s |
|---|---|---|---|---|---|---|---|
| 串级(整定后) | 0.293 | 0.632 | 0.802 | 0.802 | −0.1469 | 0.8343 | 0.8344 |
| LQR | 0.292 | 0.625 | 0.791 | 0.791 | −0.1462 | 0.8260 | 0.8259 |
| LQI | 0.248 | 0.339 | 0.228 | 0.343 | −0.1296 | −0.0011 | 0.0000 |
| 串级(最接近 LQI) | 无 | 无 | 无 | 无 | 无 | 0.0446 | 0.0000 |
最后一行只在 Python 里跑了 30 s,不在 out/ch09/ 的 CSV 里。LQI 确实能去除偏差,但要很久。 5 秒的窗口里,LQI 的 在 3.81 s 到顶 0.343 m,到 5 s 回到 0.228 m,还没有到 0。它最慢的闭环极点的时间常数是 1.31 s,推力在 2.0 s 才来,只剩 3 s,不到 2.3 个时间常数,不够。30 s 的仿真才看见零偏差:10 s 时 m,20 s 后 m(report 在 30 s 处断言 )。同时 5 s 窗口里我断言了 LQI 的 小于 LQR 的 0.35 倍(实际 0.228 对 0.791,是 0.29 倍)。
整定好的串级 PID 没有消除偏差,和 LQR 一样。 Nelder–Mead 把积分增益 整定到了 ,等于删掉了积分。原因我想得到:优化的目标是 step 算例的代价,这个场景里没有外力,积分项对代价没有任何好处,只会带来超调,优化器就把它关了。串级的结构有积分,整定的目标把它关了,这是我选目标的问题,不是串级的问题。最后一行是反证:把串级的增益换成“最接近 LQI”的那一组(),它也能把偏差拉回 0(,),比 LQI 慢一点,因为 只有 11.72。这一组的串级和它的等价状态反馈在 push 上的位置最大差 m(5 秒里最大位移是 0.34 m),验证了上面“串级就是状态反馈”的推导;这点差别来自 D 项:串级里是 1 ms 的后向差分,状态反馈里是真的 ,所以只有在 D 项读陀螺仪的时候两者才严格等价,阶跃场景里积分器的初值还差一个常数(前面推导里说过)。
质量对不上:比我预期的温和得多
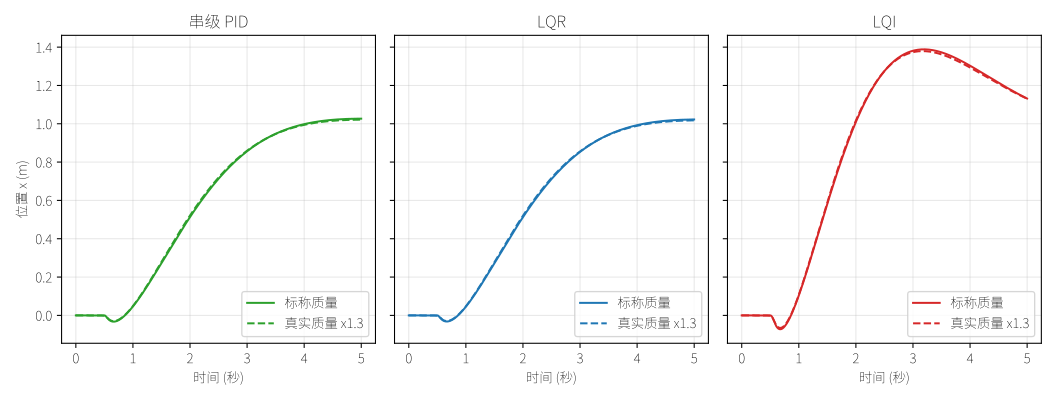
mass130:控制器按 kg 设计,对象的车身质量是 。三个控制器的阶跃响应和标称质量几乎重合:串级的超调 2.1%(标称 2.7%),LQR 1.8%(2.3%),LQI 37.9%(38.8%),最小 差 0.003 到 0.007 m,5 s 末的 差 0.001 到 0.006 m。我预想质量不对会在 LQR 和串级之间分出胜负,没有分出来。线性的稳定范围解释了为什么:把真实质量扫成 kg,固定增益,看离散闭环是否稳定,LQR 在 内稳定,LQI 到 15.2,整定后的串级到 13.2,最接近 LQI 的串级到 15.2。1.3 在这个范围的最近一端的十倍以外。这是线性、无饱和的结论,不是说真车上质量差 10 倍也没事(那时候力矩早就饱和了),我只想说: 离这个设计的失稳边界很远,失配实验在这个强度上没有信息量。
增益的结构:串级够不到 LQI
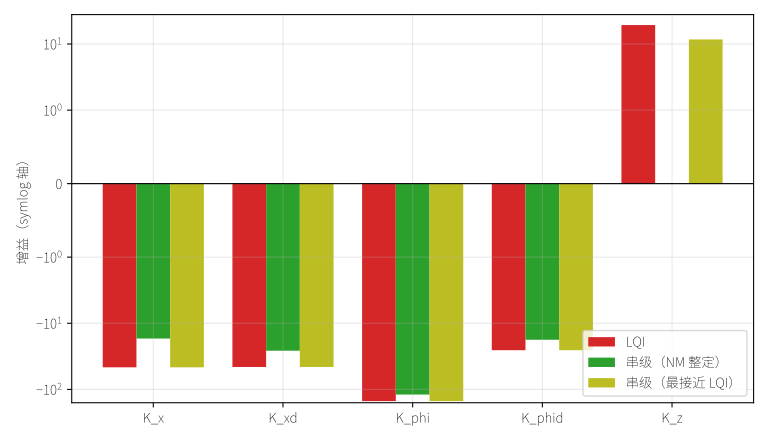
纵轴是 symlog,所以 看起来矮,其实 19.3 和 是同一个数量级的东西。三根柱子:红的是 LQI 的 ;黄的是“最接近 LQI 的串级”的等价 ,前四个分量和红的一样,只有 不同(11.72 对 19.34),因为那个二次方程没有实根(判别式 );绿的是 Nelder–Mead 整定后的串级,,和 LQR 的 的比值是 0.88、0.87、0.90、0.85,整定后的串级大约是 LQR 的 0.87 倍缩放。step 的代价 6.162 对 LQR 的 6.163,优化器没有找到比 LQR 更好的东西(在线性、无饱和、无限时域的意义上 LQR 就是最优的,不可能被超过),差的这 0.001 我猜来自力矩饱和和 5 s 的截断,没有去验证。
所以我对开头那个问题的回答是:串级 PID 和状态反馈的差别不在“多不多维”,在“增益是怎么来的”。 展开之后它就是 ,五个自由参数;LQR 的好处是增益从一个代价函数里算出来,改一个权重(比如把 放大一倍)重新算一遍就好,串级要重新整定五个互相耦合的增益。这一次实验里串级的表现不比 LQR 差,是因为我让优化器去优化同一个代价。如果让一个人手调这五个增益,我不知道结果会怎样,我没有做这个实验。
这些结果的边界
- 所有对象参数都是我取的量级。 、、、、、 和 10 N·m 的力矩上限都是假设,不是实测。没有轮子和地面的摩擦,没有电机的电流环动态(力矩指令即力矩),没有编码器和陀螺仪的噪声,也没有第 7 篇那样的延迟。真车上这些加起来,LQR 的 1 kHz 反馈就未必能站得这么稳。
- 只有一个推力、一个初始倾角、一个质量失配。 所有数都是各一个场景,我没有扫。
检查点
在 pid-lab 的根目录运行(nix develop 里,或者你自己装好依赖):
make -s ch09输出的结构就是上面“结果”里那一大段:三个原生程序各打印一次能量自检(漂移 )和 DARE 迭代次数(LQR 13067,LQI 15178),然后是 42 行 ok(最大差异 ),然后是 report 的表,最后一行 ch09 OK。report 里的断言全部通过,包括:能量漂移小于 ,expm 对 scipy.linalg.expm 的相对误差小于 ,Riccati 迭代对 solve_discrete_are 小于 ,LQI 在 30 s 的 push 里 。
这一篇新增或依赖的文件(data/ch09_*.csv 和 figures/ch09/*.svg 由 make ch09 生成,不在仓库里):
Python:
| 文件 | 命令 | 结果 |
|---|---|---|
python/pidlab/mat.py | make -s ch09 | 小矩阵运算,被 lqr.py 使用 |
python/pidlab/lqr.py | make -s ch09 | expm 对 scipy 相对误差 ;DARE 13067 步(LQI 15178 步),对 solve_discrete_are |
python/pidlab/plants.py | make -s ch09 | Wip:能量漂移 ,、 对中心差分 |
python/pidlab/pid.py、python/pidlab/sim.py | make -s ch09 | 第 5 篇的 Pid 和第 1 篇的 RK4 积分,这一篇没有改 |
python/ch09_lqr.py | python3 python/ch09_lqr.py ref 再 report(make -s ch09 会依次跑) | 写 data/ 和 out/ch09/*_py.csv;,Nelder–Mead 932 次评估,代价 6.318 到 6.162;5 张图 |
C:
| 文件 | 命令 | 结果 |
|---|---|---|
c/include/pl/mat.h、c/src/mat.c | make -s ch09 | 平铺行优先矩阵,维数 PL_MAX_DIM,没有堆 |
c/include/pl/lqr.h、c/src/lqr.c | make -s ch09 | DARE 13067 和 15178 步,与 Python 一步不差 |
c/include/pl/plants.h、c/src/plants.c | make -s ch09 | pl_wip_deriv、pl_wip_energy |
c/apps/ch09.c | make -s ch09 | ch09: C wrote 12 cases to out/ch09,14 个 ok |
C++:
| 文件 | 命令 | 结果 |
|---|---|---|
cpp/include/pidlab/mat.h | make -s ch09 | Mat<T, R, C>,维数在类型里 |
cpp/include/pidlab/lqr.h | make -s ch09 | Expm、C2dZoh、DareIterate、LqiAugment |
cpp/include/pidlab/plants.h | make -s ch09 | Wip<T> |
cpp/apps/ch09.cc | make -s ch09 | ch09: C++ wrote 12 cases to out/ch09,14 个 ok |
Rust:
| 文件 | 命令 | 结果 |
|---|---|---|
rust/src/mat.rs | make -s ch09 | Mat<N, M> 加 const 泛型 |
rust/src/lqr.rs | make -s ch09 | c2d_zoh::<4, 5> 和 lqi_augment 多一个 M = N + 1 参数 |
rust/src/plants.rs | make -s ch09 | Wip |
rust/src/bin/ch09.rs | make -s ch09 | ch09: Rust wrote 12 cases to out/ch09,14 个 ok;最大差异 出现在这里的 push_cascade_rs.csv |
构建入口:Makefile 的 ch09 目标,c/Makefile 和 cpp/Makefile 会自动编译 apps/ 下的新文件。
下一篇
这一篇我把平衡步兵的拉格朗日模型写成了四种语言里的 Wip(能量漂移 ),把 LQR 和 LQI 的整条链(矩阵指数、ZOH、Riccati 迭代、增广)写了四遍,三种语言的 和 Python 逐位一致,DARE 迭代次数一步不差。LQR 在 10 N 的推力下稳态偏离 0.826 m,LQI 在 30 s 内拉回 0(5 s 内没拉完),代价是阶跃超调 38.8%(LQR 2.3%);串级 PID 被整定成了 LQR 的 0.87 倍缩放(代价 6.162 对 6.163),LQI 的增益向量落在串级能表达的范围之外(判别式 )。四种语言 42 个对比文件最大差异 。
第 10 篇是最后一篇:前九篇所有的控制器都跑在 double 上,真车上的 C 板没有这个余裕。我会把第 5 篇的 Pid 搬到 float,再搬到 Q16.16 定点,让它在一个会停住的积分器、整数化的 CAN 量化、抖动的采样周期下各跑一遍,看每一步丢了什么。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!