
 Better Mistakes



音乐
暂未播放
上车之前:float32、定点数与 CAN 量化
前九篇所有的控制器都跑在 double 上,这对一台笔记本是理所当然的,对 RoboMaster 的 C 板不是。据我所知(我查了C 板的用户手册,它的供电框图里把主控标成 STM32F407;ST 的产品页说这个系列是带 DSP 和 FPU 的 Arm Cortex-M4 内核,168 MHz),C 板上是 Cortex-M4F。据我所知,M4F 的 FPU 只做单精度,一个 double 乘法会掉进软件库。所以这一篇要回答的问题是:把第 5 篇的 Pid 搬到 float,再搬到 Q16.16 定点,每一步丢了什么? 我的做法照旧:同一份数据、四种语言、和 Python 的 double 版逐位对,然后在三个上车一定会撞上的麻烦里各跑一遍:一个会停住的积分器、CAN 总线上整数化的反馈和命令、抖动的采样周期。我预料 float32 的积分器会停。停是停了,但停得很轻,轻到我一开始以为自己的实验是错的。
这一篇结束时你会有:make ch10 通过,out/ch10/ 下 52 个文件(Python 的 5 个浮点算例和 3 个定点算例;C、C++、Rust 各自的 5 个 double 算例、3 个定点算例和 5 个 float32 算例;5 个计时文本),figures/ch10/ 下 5 张图;以及 Q16.16 PID、float32 构建、三个“上车麻烦”的实验,和 Cortex-M4F 的代码体积。
新增模块:Python pidlab.pid_q,C pl/pid_q.h 和 src/pid_q.c,C++ pidlab/pid_q.h,Rust pid_q.rs(Q16.16 的乘法、饱和、PidQ);cpp/tests/no_heap.cc 和 scripts/ch10_checks.sh(四项静态检查)。Pid 本身没有改,只是第一次在 float 下被四种语言同时使用。
前置:第 5 篇的 Pid(CLAMP 抗饱和、cfg 可在运行时修改)。需要的数学:浮点数的舍入、二进制补码。
三种数,三种丢法
同一个速度环,我让它在三种数字格式里各算一遍。
- float32。 24 位有效数字(23 位存储加一个隐含位),相对精度 。数越大,相邻两个数的间隔(ulp)越大:落在 里的数,ulp 是 。
- Q16.16 定点。 一个
int32,高 16 位整数、低 16 位小数,实数值是整数除以 65536。间隔永远是 ,范围是 。间隔不随数的大小变,代价是范围固定。 - CAN 上的整数。 C620 电调的命令是 的整数,对应 A,也就是每个单位 mA;反馈里的转子转速以 rpm 为单位的整数。这两条我都核对了C620 的用户手册(我拿到的是 GitHub 上的一份镜像,不是官网的原件):“controllable current range is -16384 ~ 0 ~ 16384”对应“-20 ~ 0 ~ 20 A”,反馈报文默认 1 kHz,“rotor speed value unit rpm”。手册没有写反馈转速字段有没有符号,我按有符号 16 位处理,这是我的假设。
这一篇所有的 PID 都用“原始单位”:命令是 raw(),反馈是转子侧的 rpm(手册说的是 rotor speed,所以要把输出轴转速乘上 的减速比,这个比值是 M3508 P19 数据手册里的“Reduction Ratio 3591/187”)。第 5 篇的速度环(,)换算到原始单位,只需要把 、 乘上“raw 每安培”再除以“rpm 每 rad/s”。python/ch10_embedded.py 里的 raw_gains 就是这几行:
RAW_FULL = 16384.0AMP_PER_RAW = 20.0 / RAW_FULLRAW_PER_AMP = RAW_FULL / 20.0RPM_PER_RADS = 60.0 / (2.0 * math.pi) * (3591.0 / 187.0)
def raw_gains() -> tuple[float, float]: """The ch05 speed PI (wn = 30, zeta = 0.7) in raw units per rpm.""" m = MotorSpeedLag() kp = (2.0 * ZETA * WN * m.j - m.b) / m.kt ki = WN * WN * m.j / m.kt scale = RAW_PER_AMP / RPM_PER_RADS return kp * scale, ki * scale结果是 raw/rpm, raw/(rpm·s),。
这些参数里有一处我没弄明白:数据手册给的转矩常数是 0.3 N·m/A,转速常数是 24.48 rpm/V,后者换成反电势常数是 V·s/rad。理想电机里两个应该相等,这里差了 30%。我不知道手册的这两个数各自对应哪个轴、哪种电流定义,所以整个系列照用 0.3,把它当作我取的量级,不当作经过验证的参数。
float32:积分器为什么会停,半个 ulp
第 5 篇的积分器每个采样做一次 integral += ki*ts*e。设积分项现在是 ,增量是 。浮点加法先算精确和再舍入到最近的 float32,所以只要 小于 附近 ulp 的一半, 就舍入回 ,这一步等于没做。积分器停住了。
稳态下 就是负载电流,在这次实验里大约是 10400 raw,落在 ,,ulp 。要让积分器动起来,误差至少得是
也就是说积分器自己把误差“留”在 以内:误差再小,I 项就不管了。在这个速度环上这是 2000 rpm 的 ,没有任何意义。但这个公式里有两个旋钮: 越大(接近满量程 16384 时 ulp 翻倍)、 越小, 越大。RM 代码里把时间常数折进 ki 的写法(第 1 篇和第 4 篇提过,我猜很常见)会让 比这里小得多, 对应 0.049 rpm, 对应 0.49 rpm。
光有公式我不放心,所以 report 里还有一个二分:在真正的 float32 加法里找最小的误差,让 base + gain*e 不等于 base。
def f32_deadband(level: float, ki_ts: float) -> float: """Smallest error that still moves a float32 integrator at `level`.""" base = np.float32(level) gain = np.float32(ki_ts) lo, hi = 1e-12, 1e3 for _ in range(200): mid = math.sqrt(lo * hi) if base + gain * np.float32(mid) != base: hi = mid else: lo = mid return hi
def half_ulp_deadband(level: float, ki_ts: float) -> float: return float(np.spacing(np.float32(level))) / 2.0 / ki_ts两个函数对得上,说明“半个 ulp”的推导没有漏掉东西(舍入到偶数的平局不影响二分的结果,因为 是连续的)。
Q16.16:先写 Python 参考
乘法
两个 Q16.16 数的乘积有 32 位小数,要右移 16 位才回到 Q16.16。但乘积本身要 64 位: 的 Q16.16 表示是 (21 位),误差 2000 rpm 是 (27 位),乘起来 48 位,int32 装不下。所以:
加 再向下取整等于四舍五入(平局向 ),不加的话每次乘法都向 偏半个最低位,积分起来就是一个固定的漂移。右移用算术移位,负数的取整就是向 。加法也要饱和: 在 超过 32768 raw 时会溢出 int32。这里 raw,确实会超,饱和成 32768 raw,但它比输出的钳位 16384 大,所以最后决定输出的还是钳位,积分器的抗饱和判断(v 和 u 的大小关系)也不受影响。
Python 的整数是任意精度的,不会溢出,所以参考实现必须主动模拟 int32 的饱和,否则它描述的就不是硬件。python/pidlab/pid_q.py 的基本操作:
def sat32(x: int) -> int: return INT32_MIN if x < INT32_MIN else (INT32_MAX if x > INT32_MAX else x)
def to_q(x: float) -> int: """Real to Q16.16: round half away from zero, saturate to int32.""" return sat32(int(round_half_away(x * ONE)))
def qmul(a: int, b: int) -> int: """(a * b) in Q16.16: int64 product, round half up, saturate.""" return sat32((a * b + (1 << (FRAC - 1))) >> FRAC)to_q 用“四舍五入、平局远离零”(和第 4 篇起所有舍入的约定一样,Python 内置的 round 是银行家舍入,不能用);而 qmul 里的舍入是“平局向上”,两处不同是有意的:前者是一次性的转换,后者每个采样都发生,必须便宜。
update
make_config 把三个增益提前换成 Q16.16:、、,之后每个采样里没有除法。update 就是第 5 篇的 CLAMP 规则换成整数:输出被钳位、并且误差把积分往钳位的方向推的时候,积分器不动。
def update(self, r_q: int, y_q: int) -> int: """One sample; returns the int16 command.""" c = self.cfg e = sat32(r_q - y_q) if not self.primed: self.prev_e = e self.primed = True p = qmul(c.kp_q, e) d = qmul(c.kd_over_ts_q, sat32(e - self.prev_e)) self.prev_e = e v = sat32(sat32(p + self.integral) + d) u = min(max(v, c.u_min_q), c.u_max_q) self.saturated = u != v if not (self.saturated and (e > 0) == (v > u) and e != 0): self.integral = sat32(self.integral + qmul(c.ki_ts_q, e)) return (u + (ONE >> 1)) >> FRAC每个加减法都过一次 sat32,包括 :两个 int32 相减也能溢出。最后一行把 Q16.16 的输出舍入成 int16 的命令。注意这一步:无论控制器内部用什么格式,C620 收到的命令都是整数,这一步后面会成为 Q16.16 残余误差的来源。
三种语言的 Q16.16
pid_q 是 Python 版的逐行翻译。区别在这几处。
C。 两个基本操作是 static inline,放在头文件里。右移负数在 C 里是“实现定义”,GCC 在手册的 Integers implementation 一页里明确写了 “Signed ‘>>’ acts on negative numbers by sign extension”,所以 C 版本的可移植性依赖编译器(C++20 和 Rust 的标准则保证算术移位),我在注释里写了这一点:
/* a * b in Q16.16: 64-bit product, round half up, saturate. The *//* right shift of a negative value is an arithmetic shift in GCC. */static inline int32_t pl_q_mul(int32_t a, int32_t b){ return pl_q_sat(((int64_t)a * b + (1 << (PL_Q_FRAC - 1))) >> PL_Q_FRAC);}update 的结构和 Python 相同,只有抗饱和条件写成了更直接的形式:wind_up = (e > 0 && v > u) || (e < 0 && v < u),和 Python 里 saturated and (e > 0) == (v > u) and e != 0 等价(v != u 时 v > u 与 v < u 互斥)。
p = pl_q_mul(c->kp_q, e); d = pl_q_mul(c->kd_over_ts_q, pl_q_sat((int64_t)e - pid->prev_e)); pid->prev_e = e; v = pl_q_sat((int64_t)pl_q_sat((int64_t)p + pid->integral) + d); u = v < c->u_min_q ? c->u_min_q : (v > c->u_max_q ? c->u_max_q : v); pid->saturated = u != v; wind_up = (e > 0 && v > u) || (e < 0 && v < u); if (!wind_up) pid->integral = pl_q_sat((int64_t)pid->integral + pl_q_mul(c->ki_ts_q, e)); return (int16_t)((u + (PL_Q_ONE >> 1)) >> PL_Q_FRAC);C++。 PidQ 是一个很小的类,没有堆,也没有异常;配置的构造 MakePidQConfig 校验失败时返回 std::nullopt,和第 5 篇的 Pid<T>::Create 同一个思路:
template <class T>std::optional<PidQConfig> MakePidQConfig(T kp, T ki, T kd, T ts, T u_min, T u_max) { if (ts <= T(0) || u_min > u_max) return std::nullopt; if (u_min < -kQRawMax || u_max > kQRawMax) return std::nullopt; return PidQConfig{QFromReal(kp), QFromReal(ki * ts), QFromReal(kd / ts), QFromReal(u_min), QFromReal(u_max)};}QMul 里的 static_cast<std::int64_t> 必须写在乘法的前面,写在后面就晚了,int32 * int32 已经溢出。QFromReal 是模板,所以 float32 构建里 T = float,转换在 float 里做。
Rust。 as i64 是显式的,哪里升到了 64 位一眼就看得出来。漏写编译器不报错:溢出的时候 debug 构建 panic,release 构建回绕。饱和是一行 clamp:
/// Saturate a 64-bit value to `i32`.pub fn q_sat(x: i64) -> i32 { x.clamp(i32::MIN as i64, i32::MAX as i64) as i32}
/// `a * b` in Q16.16: 64-bit product, round half up, saturate.pub fn q_mul(a: i32, b: i32) -> i32 { q_sat((a as i64 * b as i64 + (1 << (Q_FRAC - 1))) >> Q_FRAC)}标量类型和没有堆。 第 5 篇的 Pid 在 C 里是 pl_real(-DPL_USE_FLOAT 时是 float)、C++ 是模板参数 T(这一次用 Pid<float>)、Rust 是 Real(--features f32 时是 f32)。pid_q 不受这个开关影响,永远是整数。三种语言的 PID 都没有堆分配,证据在后面的“静态检查”里。
仿真:同一份数据,三个麻烦
CAN 量化:一转的反馈是 18.6 个命令单位。 反馈取整到 1 rpm 以后,量化误差在 rpm 之间均匀分布,比例项把它放大 倍,所以反馈跳一个 rpm,命令就跳 18.6 raw(22.7 mA)。命令取整到 1 raw 还要再加 raw 的转矩误差。后面的实验里这两个效应会同时出现,而且我能用一个数字把第二个对上。
周期抖动:测得的周期只比标称值多一个零均值噪声。 采样周期 ,。控制器在第 步看到测量 ,它是上一个周期( 长)积分的结果,所以积分项正确的矩形近似是 。标称版本用的是 ,两者的差是
零均值、互相独立,所以这是一个零均值的噪声项,不是偏差。只有误差 大的时候它才大,也就是设定值跳变的那几十毫秒。我手算的结论是:实测周期的补偿应该有用,但用处很小。
“用实测周期”在代码里就是每次更新前把 cfg.ts 设成上一个周期,不需要新的接口,第 5 篇已经说过 cfg 是可以在运行时改的。
数据和仿真循环
数据由 Python 生成,原生程序只读,不用任何随机数发生器。三份:ch10_stall 是 2000 rpm 的阶跃加一个从 1 s 开始、每秒 0.9 N·m、到 3.7 N·m 为止的缓升负载(20 s);ch10_quant 是同样的阶跃加 1.5 s 处 1 N·m 的负载(3 s);ch10_jitter 的设定值在 1 s 处从 2000 降到 1000 rpm,2 s 处加 2 N·m 的负载,并带有 (numpy 种子 10)。write_data 里最关键的两行是阶跃和缓升:
step = lambda t: 2000.0 * (t >= 0.05) # noqa: E731 # load ramps to 3.7 N*m in 4.1 s, then holds ramp = lambda t: np.clip(0.9 * (t - 1.0), 0.0, 3.7) # noqa: E731 write_csv(DATA / "ch10_stall.csv", table(20000, step, ramp))浮点版本的仿真循环,就是第 5 篇的 Pid、一个带电流环的 MotorSpeedLag、和上面的单位换算。每个采样先把真实转速换算成转子 rpm,需要的话取整成“CAN 反馈”,然后(实测模式下)把 cfg.ts 设成上一个周期,更新,需要的话把命令取整,最后用真实的周期推进对象(RK4,10 个子步):
for k in range(len(data["t"])): r, d, w = data["r"][k], data["d"][k], data["w"][k] ts_k = TS * (1.0 + JITTER * w) ytrue = x[0] * RPM_PER_RADS y = round_half_away(ytrue) if case.quant else ytrue if case.jitter == 2: pid.cfg.ts = prev u = pid.update(r, y) if case.quant or case.quant_u: u = round_half_away(u) t = t_act if case.jitter else data["t"][k] rows.append([t, r, y, u, ytrue, pid.integral, float(pid.saturated)]) x = advance(plant.deriv, x, [u * AMP_PER_RAW, d], ts_k, SUBSTEPS) t_act += ts_k prev = ts_kt 列在抖动算例里是累加的真实时间。quant_u 是只在 Python 里用的一个开关,只取整命令、不取整反馈,后面解释它为什么存在。
Q16.16 的循环只多了两件事:把 r、y 用 to_q 转成 Q16.16 再交给 PidQ,以及输出已经是整数命令,直接乘 AMP_PER_RAW 喂给对象。
C 的循环是同一个形状。pid.cfg.ts = prev 就是“实测周期”:
if (c->jitter == 2) pid.cfg.ts = prev; u = pl_pid_update(&pid, row[cr], y, 0, false); if (c->quant) u = PL_ROUND(u);C++ 的版本是函数模板,T 是 double 或 float,RunAll<float>() 用的就是第 5 篇原封不动的 Pid<float>;Rust 的 Real 在 f32 特性下是 f32,同一份源码编译出两个版本,只有定点部分(run_fixed)永远用整数。三个 float32 构建的命令是:
make -C c BUILD=../build/c32 EXTRA_CFLAGS=-DPL_USE_FLOAT ONLY=ch10cd rust && cargo build --release --features f32 --bin ch10 --target-dir target32C++ 不需要单独构建,同一个程序里 RunAll<double>() 和 RunAll<float>() 各跑一遍。文件名里 float32 的是 _f32_c.csv、_f32_cpp.csv、_f32_rs.csv。
增益在 double 里算:三种语言的 raw_gains 都用 double 做算术,输入是对象自己的参数(float32 构建里这些参数本身就是 float32),然后才转成 pl_real、T 或 Real,这样三种语言从同一个数起步。
只在 Python 里存在的一个函数
原生的 float32 构建里控制器和对象都是 float32,对象自己的状态也会舍入,两件事混在一起。所以我在 Python 里加了 run_f32_controller:控制器是 numpy 的 float32,对象仍是 float64。
kp, ki = (np.float32(v) for v in raw_gains()) ts, lim = np.float32(TS), np.float32(RAW_FULL) ... y = np.float32(ytrue) v = kp * (r - y) + integral u = min(max(v, -lim), lim) e = r - y if not (u != v and e * (v - u) > 0): integral = integral + ki * ts * e这一段是第 5 篇 CLAMP 规则的 float32 版,所有算术都在 np.float32 里。后面讲结果时会看到,为什么要把这两件事分开。
静态检查
scripts/ch10_checks.sh 做四件事,都是 make ch10 里自动跑的。
- C 没有堆。 对
build/c/obj/*.o(除了读写 CSV 的csv.o)跑nm -u,找不到malloc、calloc、realloc、free。 - C++ 没有堆。
cpp/tests/no_heap.cc实例化Pid<float>、Pid<double>和PidQ,用-fno-exceptions -fno-rtti编译,nm -C -u里没有operator new和malloc。 - Rust 的
no_std构建。cargo build --lib --no-default-features --features f32通过,库本身不依赖std,也没有alloc。 - Cortex-M4F 的编译。
arm-none-eabi-gcc(15.2.1)编译pid.c和pid_q.c,然后arm-none-eabi-size。
前两项的核心是一个 nm 过滤,最后一项的关键是 -Wdouble-promotion -Werror:任何一处 float 悄悄升成 double 都会让编译失败。脚本最后还数一下目标文件里引用了几个 __aeabi_d* 软件双精度函数。
for o in build/c/obj/*.o; do [ "$(basename "$o")" = csv.o ] && continue if nm -u "$o" | grep -E ' (malloc|calloc|realloc|free)$'; then echo "heap symbol in $o" bad=1 fidone# ...flags="-mcpu=cortex-m4 -mthumb -mfpu=fpv4-sp-d16 -mfloat-abi=hard -O2 -ffunction-sections -fdata-sections -std=c11 -DPL_USE_FLOAT -Wall -Wextra -Wdouble-promotion -Werror -I c/include"for s in pid pid_q; do arm-none-eabi-gcc $flags -c "c/src/$s.c" -o "build/arm/$s.o"donearm-none-eabi-size build/arm/pid.o build/arm/pid_q.o风格检查:C 用内核的 checkpatch.pl(--no-tree,忽略 SPDX 和 typedef 两项)对 c/include/pl/*.h、c/src/*.c、c/apps/*.c 全部检查,0 errors、0 warnings;C++ 用 clang-format 21.1.8 的 Google 风格(-Werror,现在连 cpp/tests 也在内);Python 用 ruff 0.15.14(行宽 79,ruff format --check 和 ruff check);Rust 用 cargo fmt --check 和 cargo clippy --release -- -D warnings(float32 的构建也跑 clippy)。
结果
make ch10 是第 8 篇那种手写的目标:先 ref,再构建 double 和 float32 的 C、Rust,然后各个程序依次运行,再是静态检查,最后跑计时,最后才是 report。计时不能和别的东西并行,所以整条链是串行的。构建已经缓存的时候整条链大约 10 秒。完整输出在文末的“检查点”里,下面按问题一个个看。
对得上吗:Q16.16 逐位一致,float32 也是
24 个比较文件全部通过。三个 fixed_* 算例的容差是 0,每种语言的每一列,包括 r_q、y_q、u、integral_q、sat,最大差异都是 0(所以三种语言的 Q16.16 和 Python 的整数参考实现逐位一致)。五个 double 算例和 Python 的最大差异也是 0.000e+00,比 的容差好得多(这五个算例没有三角函数,Rust 的 libm 和 glibc 的差异不会出现)。
float32 的构建没有 Python 的 float32 参考,所以我做了两件事:三种语言的 float32 输出两两比较,以及和 Python 的 double 参考比较。C、C++、Rust 的 float32 输出逐位一致(我把跨语言的容差设成 ,断言是“不超过 ”,实际是 0)。
这个“逐位一致”不是一次就到的。第一次跑的时候 C 和另外两种语言差了 0.029(积分项),C++ 和 Rust 之间是 0。原因是 sim.c 里的 RK4 写的是 0.5 * h * k1[i] 和 h / 6.0:字面量是 double,在 float32 构建里整个表达式被悄悄提升成 double 再舍回 float,而 C++ 和 Rust 是纯 float 运算。我把这几个字面量改成了 0.5f、6.0f、2.0f(在 double 构建里它们是精确可表示的,所以 double 的结果不变)。freq.c 里的 PL_CABS(1.0 + cur) 在 float32 构建里同样编译不过,改成 (pl_real)1 + cur。这两处都是前面章节的文件,改完以后我重跑了第 1、3、9 篇,都通过;其余章节我没有重跑,只是论证了改动不会改变 double 的结果:0.5f、6.0f、2.0f 都是精确可表示的,(pl_real)1 在 double 构建里就是 1.0。逐位一致也有前提: x86-64 的基线指令集没有融合乘加,gcc 和 rustc 都不会把 a*b+c 合并成一条指令。如果换到有 FMA 的目标(据我所知 M4F 的 FPU 有融合乘加指令),我猜三种语言的结果会因为编译器的合并策略不同而分开,没有试过。
和 double 参考比,float32 在 stall 上的最大差异:转速 0.014 rpm、命令 0.40 raw、积分项 0.38 raw。quant_on 是个例外:转速差 1.0 rpm、命令差 23 raw,因为取整的分支(round(y) 的 0.5 平局)在 float32 和 double 里翻向了不同的一侧,两条轨迹从那个采样起走开了。这是取整这类不连续操作的通病:最后一位上的差异会被放大成一整个量化格。这里翻转发生在 float32 对 double 之间,不是语言之间,所以三种语言互相比较的时候不需要为这个算例放宽容差。
float32 的积分器停了,停在 1 mrpm
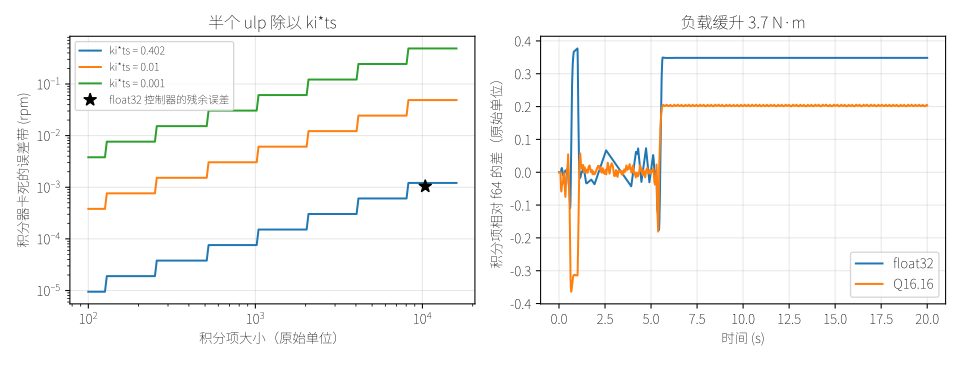
左图是 的阶梯,三条线是三个 :这篇用的 0.402、0.01、0.001。每次积分项跨过 2 的幂,误差带翻一倍。黑星是 float32 控制器(对象用 float64)在负载稳定后的实际残余误差。右图是整条回路都在 float32 或 Q16.16 里的积分项和 double 版本的差,大约 5.6 s 之后(负载缓升结束)就冻结了,不再变化。
数字(report 输出里的表):
- 积分项到 10401 raw,超过 ,负载在最后 5 s 恒定。
f64:残余误差 rpm,没有停滞。f32 ctl(float32 控制器,float64 对象):残余误差 rpm,积分项 10401.31(f64是 10401.29,差 0.02)。- 公式 是 rpm,实测是它的 0.86 倍。公式是上限(积分器停在误差带的边缘以内),所以这个比值合理。
- float32 加法二分出来的误差带,和公式在三个 上完全一致:0.4021 对 ,0.01 对 ,0.001 对 rpm。
所以结论是:float32 的积分器停滞是真的,大小和半个 ulp 的推导一致,但对这个速度环它是 rpm 的事,在 2000 rpm 上不值得操心。 如果 小两个数量级,误差带就是 0.5 rpm,开始有意义;我没有在 RM 的真实固件里核实 通常是多大,所以“RM 代码里 很小”只是我的猜测,不是结论。
这里有一个我差点说错的地方。原生的 float32 构建(控制器和对象都是 float32)残余误差是 rpm,积分项 10401.63,和 double 差 0.34;而 float32 控制器配 float64 对象的积分项只差 0.02。多出来的那 0.32 raw 来自对象:float32 的 w 在 10.9 rad/s 附近的 ulp 是 ,RK4 子步的增量 小于一半就丢了,对象自己的状态也在停滞。真实的电机不会这样,所以用 float32 仿真去回答“真车上的 float32 控制器会怎样”会掺进仿真器自己的舍入。我把 f32 ctl 这一行加进了 report 就是为了把它们分开,上面的结论用的是它。
Q16.16 对 float32:不是更准,是误差换了个地方
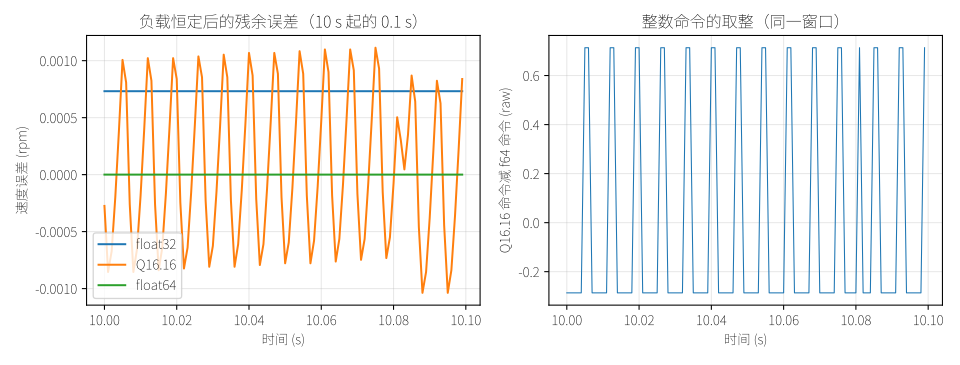
负载恒定之后三种格式的残余误差。float32(整条回路)是一条水平线:积分器停了,误差不动。Q16.16 是锯齿:它的最大误差是 rpm,比 float32 大,但它不是积分器的问题。Q16.16 的积分项分辨率是 raw,比 float32 在 10401 附近的 细 64 倍,积分器根本不会停。锯齿来自最后一步:命令取整成 int16。我在 Python 里把 double 版本的命令也取整成整数(不动反馈,不用定点),残余误差是 rpm,和 Q16.16 的 差不到 0.5%。report 里断言了这两个数在 10% 以内。右图是 Q16.16 的命令减去 double 命令,只在 和 raw 之间跳,就是取整的两侧。
所以“定点数更准”是错的,更准确的说法是:定点数的分辨率是常数,float32 的分辨率随数的大小变;这个对象里积分项是大数(1 万以上),定点数的分辨率反而更细,但输出最后要变成 int16,这一步无论用哪种格式都躲不掉。
CAN 量化:不是抖动,是 0.85 秒一个的锯齿
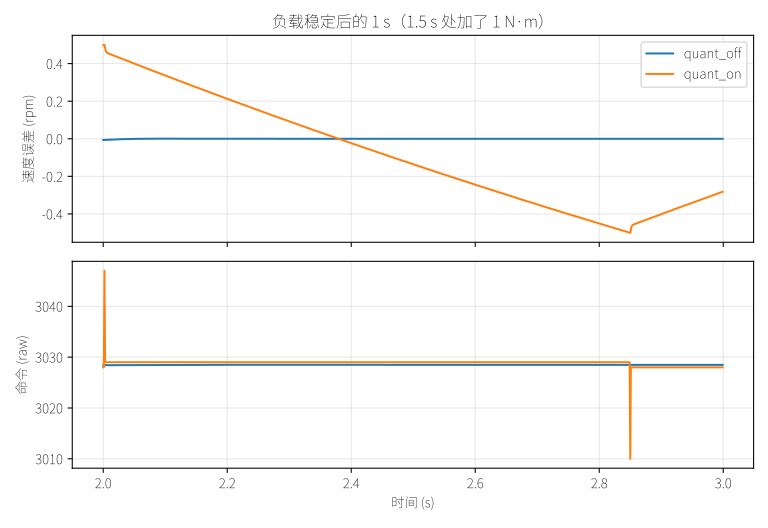
指标(report 输出):
- 负载稳定后(2 到 3 s)速度误差的均方根:
quant_offrpm,quant_onrpm,是 374 倍。 - 这 1 s 里命令变了多少次:
quant_off997 次(每个采样都在微调,峰峰值 0.1 raw),quant_on只有 4 次(峰峰值 37 raw:2.001 s 和 2.002 s 是负载瞬态的尾巴,2.849 s 和 2.850 s 是下面要说的翻档毛刺和恢复)。
我原本以为量化会让命令抖,实际是反过来的:量化让命令几乎不动,让速度慢慢漂。 图里 quant_on 的误差从 rpm 一路线性掉到 rpm,斜率 1.12 rpm/s(我拟合出来是 1.125),到 2.85 s 反馈的整数 rpm 翻了一档,比例项一步把命令拉低了一个 raw(图里的毛刺,3010 对 3029),然后回到 3028,误差跳回去,下一轮锯齿开始。
斜率可以对上:命令是整数 3029,而需要的电流大约对应 3028.5,差半个 raw。半个 raw 的转矩误差是 N·m,除以 得 rad/s²,乘 183.4 rpm/(rad/s) 得 1.119 rpm/s。拟合出来的 1.125 rpm/s 对上了。这个对象的转子 rpm 量化(1 rpm)和命令量化(半个 raw)合起来产生了一个 0.85 s 周期、 rpm 幅度的极限环,在 2000 rpm 上是 0.025%。在这个 下,它不是抖,是慢速的锯齿; 再大几倍,每次翻档的毛刺就会更明显。这是一个设定值和负载都是常数的算例,我没有扫 。
抖动:实测周期只改善了 0.53%
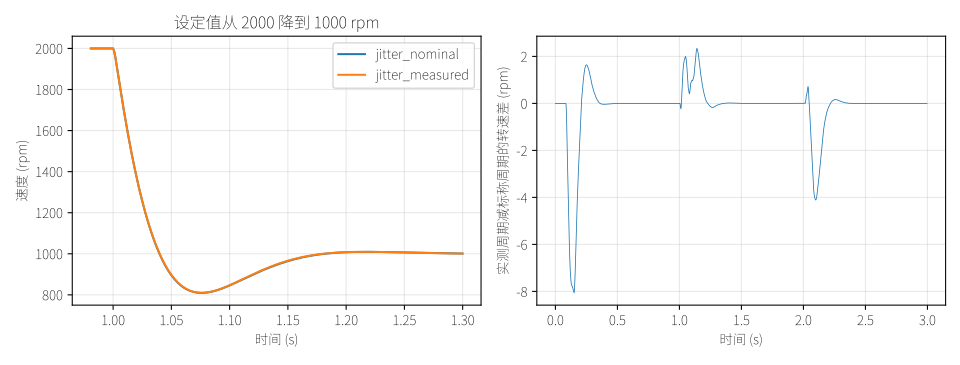
指标:
- 设定值降到 1000 rpm 之后那 1 s 的 IAE:标称 30.947 rpm·s,实测 30.782 rpm·s,差 0.53%。
- 2 到 3 s(负载 2 N·m 加上以后):标称 14.796,实测 14.991;也就是说实测并不总是更好,这一段它多了 1.3%。
- 2.5 s 起的稳态里,命令的标准差 0.0335(标称)对 0.0324(实测),误差的标准差 对 rpm。
所以前面手算的结论成立:差是一个零均值噪声项,大小取决于误差的大小,设定值跳变的时候最大(图右,最多约 8 rpm 的转速差,占 2000 到 1000 的跳变的 0.8%)。对这个对象,±20% 的周期抖动用不着补偿。 这不是说周期抖动永远不用管:这里的抖动是独立同分布、零均值的,真实的抖动(中断被别的任务延迟)往往有偏、有相关,我没有试。
计时:主机上的数,不是 MCU 上的数
下面所有计时都是在我的笔记本(AMD Ryzen 7 PRO 6850U with Radeon Graphics,来自 /proc/cpuinfo)上测的,不是 Cortex-M4F。主机有乱序执行、分支预测和大缓存,更新一次只要几个纳秒;M4F 没有这些,同样的代码要多少时钟周期我没有测。这些数只能比较实现,不能拿来估计 C 板上的耗时。
每个程序做 次更新,重复 5 次,取中位数(纳秒/次),输入是一张 4096 点的带噪声测量表:
| 实现 | float64 | float32 | Q16.16 |
|---|---|---|---|
| C | 4.71 | 4.69 | 3.79 |
| C++ | 1.87 | 2.18 | 2.00 |
| Rust | 4.01 | 4.08 | 5.41 |
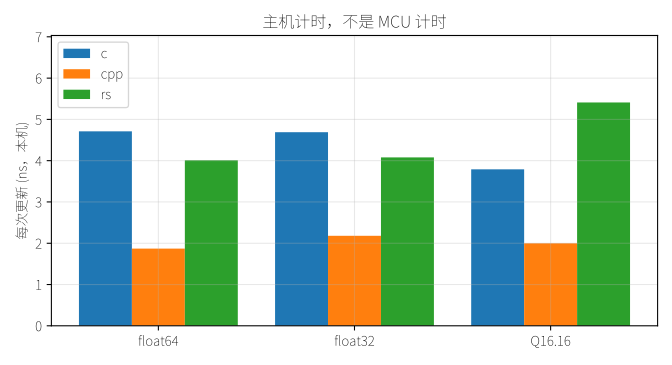
这张图能读出的东西很少。语言之间的差(C++ 比 C 快 2 倍多)大于格式之间的差;我猜原因是 C++ 的 Pid 是头文件里的模板,可以内联进测试循环,而 C 的 pl_pid_update 在另一个编译单元里,没有链接时优化,每次是一个真正的函数调用;这是猜测,我没有看汇编。格式之间的差更没有规律:Q16.16 在 C 里最快,在 Rust 里最慢。在 x86-64 上 float32 和 float64 的标量乘加延迟本来就差不多,所以 float32 没有变快也不奇怪。这些数不能支持“定点比浮点快”或者“float32 比 double 快”。 另外这是 5 次中位数、一台笔记本、没有锁频,噪声本身也不小。
在 M4F 上有一个更有意义的数:目标文件的大小。
$ arm-none-eabi-size build/arm/pid.o build/arm/pid_q.o text data bss dec hex filename 556 0 0 556 22c build/arm/pid.o 1332 0 0 1332 534 build/arm/pid_q.ofloat32 的 pid.o 是 556 字节,Q16.16 的 pid_q.o 是 1332 字节,更大。M4F 有硬件的单精度 FPU,浮点乘加是一条指令;定点这边每次乘法要处理 64 位中间值、舍入和饱和,指令更多。脚本最后数到的软件双精度函数(__aeabi_d*)是 0 个,所以 -Wdouble-promotion -Werror 的意义是实打实的:这两个文件里没有任何一处悄悄用了 double。这回答了开头的问题:在有单精度 FPU 的 C 板上,float32 的 Pid 比 Q16.16 版本更小,我没有测它更快还是更慢(那需要真板子)。定点数的价值在没有 FPU 的核(Cortex-M0、M3 一类)上,那些我没有编译过,所以这是一个推测。
没有按直觉发生的事
- float32 积分器停滞的大小比我预想的小得多。 我预料它会成为这篇最显眼的问题,但在这个速度环上它是 rpm。我没有为了让它更明显去降低 ,那样就不是我手上这个速度环了;二分表里给了 小一到两个数量级时的数字。
- 原生 float32 构建里对象自己也在舍入。 所以停滞的数字取自 Python 的
f32 ctl(控制器 float32,对象 float64),而不是原生构建的 。这个函数只在 Python 里存在,原生程序不做这个组合。 - Q16.16 的残余误差来自
int16命令,不来自定点。 用double加整数命令复现了同样的数字( 对 )。这个实验不在原生程序里,只在report里,靠 Python 的quant_u开关。 - CAN 量化的“抖”不存在,存在的是锯齿。 我预想命令会抖,实测命令几乎不动。我只测了一个 。
- 周期抖动的补偿只有 0.53%。 一个算例,一个种子(10)。2 到 3 s 段补偿反而差了 1.3%。
- 三种语言的 float32 逐位一致依赖 x86-64 没有 FMA。 换到有 FMA 的目标,我不保证。
哪些参数我核实过
M3508 的转矩常数 0.3 N·m/A、减速比 3591/187、空载 482 rpm 和额定 3 N·m 在数据手册里有;C620 的 A 和 rpm 反馈在手册里有(镜像文件);C 板是 STM32F407 来自 C 板手册的框图(PDF 转文字后读到的,图本身我没有看)。没有核实的:数据手册里转矩常数对应哪根轴、反馈转速字段是否有符号、负载惯量 0.03 kg·m²(我取的量级)、电流环时间常数 1 ms(我取的量级)。C 的 pid.o 和 pid_q.o 在 M4F 上的体积是真实的编译结果,但没有在真板子上跑过。
检查点
在仓库根目录、nix develop 里运行:
make -s ch10我的输出(真实运行;24 行 ok ... 的比较结果我只留了 6 行,其余形式相同,全部是 0 差异):
$ make -s ch10ch10: C (f64) wrote 5 cases to out/ch10ch10: C (f32) wrote 5 cases to out/ch10ch10: C++ (f64) wrote 5 cases to out/ch10ch10: C++ (f32) wrote 5 cases to out/ch10ch10: Rust (f64) wrote 5 cases to out/ch10ch10: Rust (f32) wrote 5 cases to out/ch10== C: heap symbols referenced by the library objects (everything except csv.o)ok: no malloc/calloc/realloc/free in 13 library objects== C++: heap symbols in the compiled controllers (-fno-exceptions -fno-rtti)ok: no operator new / malloc; undefined symbols are:== Rust: no_std build of the library (no alloc)ok: cargo build --lib --no-default-features --features f32== Cortex-M4F code size of the controllers (float, -O2, compile only) text data bss dec hex filename 556 0 0 556 22c build/arm/pid.o 1332 0 0 1332 534 build/arm/pid_q.osoft-double helper symbols (__aeabi_d*, __aeabi_f2d) referenced: 0natives vs the Python reference (tolerance 1e-9, Q16.16: 0)ok fixed_stall_c.csv: max diff 0.000e+00 <= 0.0e+00ok fixed_stall_cpp.csv: max diff 0.000e+00 <= 0.0e+00ok fixed_stall_rs.csv: max diff 0.000e+00 <= 0.0e+00ok stall_c.csv: max diff 0.000e+00 <= 1.0e-09ok stall_cpp.csv: max diff 0.000e+00 <= 1.0e-09ok stall_rs.csv: max diff 0.000e+00 <= 1.0e-09
float32 builds: C vs C++ vs Rust, and each vs the f64 referencecase c-cpp c-rs f32-f64 y f32-f64 u f32-f64 intstall 0.00e+00 0.00e+00 1.432e-02 3.994e-01 3.772e-01quant_off 0.00e+00 0.00e+00 1.432e-02 3.986e-01 3.886e-01quant_on 0.00e+00 0.00e+00 1.000e+00 2.300e+01 4.826e+00jitter_nominal 0.00e+00 0.00e+00 1.234e-02 3.510e-01 3.238e-01jitter_measured 0.00e+00 0.00e+00 1.295e-02 3.451e-01 3.261e-01ok float32 outputs agree across languages within 1e-04
speed PI in raw units: kp = 18.614 /rpm, ki = 402.06 /rpm/s, ki*ts = 0.4021integrator stall: slow load ramp, last 5 s (load constant) |integral| end max |e| (rpm)(f32 ctl: float32 controller on a float64 plant; f64 int u: float64 controller, command rounded to int)f64 10401.29 1.137e-12f32 10401.63 7.324e-04q16 10401.49 1.129e-03f32 ctl 10401.31 1.041e-03f64 int u 10401.49 1.124e-03integral gap vs f64: f32 0.377, q16 0.364 (raw)deadband at integral = 10402 (error that still moves it): ki*ts half ulp / (ki*ts) float32 bisection 0.4021 1.214e-03 1.214e-03 0.0100 4.883e-02 4.883e-02 0.0010 4.883e-01 4.883e-01
CAN quantization: integer rpm feedback, int16 command rms e [1,1.5) rms e [2,3) u changes [2,3) u ptp [2,3)quant_off 6.707e-07 7.964e-04 997 0.1quant_on 2.731e-01 2.978e-01 4 37.0one rpm of feedback is kp = 18.6 raw of command
jitter: ts_k = 1 ms * (1 + 0.2 w), w ~ U[-1, 1] IAE [1,2) rpm s IAE [2,3) rpm s late std u late std ejitter_nominal 30.947 14.796 0.0335 2.16e-03jitter_measured 30.782 14.991 0.0324 2.18e-03IAE difference after the setpoint step: 0.53 %
host timing on: AMD Ryzen 7 PRO 6850U with Radeon Graphicsns per update, median of 5 runs of 1e6 (host, NOT the MCU) f64 f32 q16c 4.71 4.69 3.79cpp 1.87 2.18 2.00rs 4.01 4.08 5.41figure: figures/ch10/float32-stall.svgfigure: figures/ch10/fixed-vs-float.svgfigure: figures/ch10/can-quantization.svgfigure: figures/ch10/jitter.svgfigure: figures/ch10/timing.svg
ch10 OK实验清单
所有文件都在 pid-lab 仓库的 tutorial-v1 标签里。下面的命令都在仓库根目录、nix develop 里运行。
Python:
| 文件 | 命令 | 结果 |
|---|---|---|
python/pidlab/pid_q.py | make -s ch10 | Q16.16 的整数参考,三种语言的 fixed_* 文件与它的差异都是 0 |
python/ch10_embedded.py | python3 python/ch10_embedded.py ref 然后 report | 生成 data/ch10_*.csv 和 Python 参考;report 打印上面的表,保存 5 张图,最后一行 ch10 OK |
python/pidlab/pid.py | make -s ch10 | 第 5 篇的 Pid,这一篇原样使用,24 个比较文件全部 ok |
python/pidlab/plants.py、python/pidlab/sim.py | make -s ch10 | MotorSpeedLag 和 RK4 推进,所有语言共用的仿真契约 |
python/compare.py | make -s ch10 | 24 个文件,fixed_* 容差 0,其余 1e-9,最大差异都是 0.000e+00 |
C、C++、Rust:
| 文件 | 命令 | 结果 |
|---|---|---|
c/include/pl/pid_q.h、c/src/pid_q.c | make -C c BUILD=../build/c32 EXTRA_CFLAGS=-DPL_USE_FLOAT ONLY=ch10 | C 的 Q16.16 和 float32 构建;pid.o 556 字节、pid_q.o 1332 字节(M4F,make ch10 的检查里) |
c/apps/ch10.c | ./build/c/ch10 run(make ch10 里自动跑);./build/c/ch10 bench | ch10: C (f64) wrote 5 cases to out/ch10;bench 的 c f64 是 4.71 ns |
c/src/sim.c、c/src/freq.c | make -s ch10 | 这一篇为 float32 构建改的两个旧文件;C、C++、Rust 的 float32 输出逐位一致 |
cpp/include/pidlab/pid_q.h | make -s ch10 | C++ 的 PidQ 和 MakePidQConfig,fixed_*_cpp.csv 差异 0 |
cpp/apps/ch10.cc | ./build/cpp/ch10 run;./build/cpp/ch10 bench | RunAll<double>() 和 RunAll<float>() 各写 5 个算例;bench 的 cpp f64 是 1.87 ns |
cpp/tests/no_heap.cc | ./scripts/ch10_checks.sh | -fno-exceptions -fno-rtti 下编译,没有 operator new 和 malloc |
rust/src/pid_q.rs | cd rust && cargo build --lib --no-default-features --features f32 | Rust 的 PidQ,no_std 构建通过,fixed_*_rs.csv 差异 0 |
rust/src/bin/ch10.rs | ./rust/target/release/ch10 run;cargo build --release --features f32 --bin ch10 --target-dir target32 | ch10: Rust (f64) wrote 5 cases to out/ch10,f32 构建同样写 5 个算例 |
脚本和 Makefile:
| 文件 | 命令 | 结果 |
|---|---|---|
scripts/ch10_checks.sh | ./scripts/ch10_checks.sh | 四项检查全部 ok,13 个 C 库目标文件无堆符号,__aeabi_d* 引用 0 个 |
Makefile | make -s ch10 | ch10 目标:ref、双精度与 float32 构建、运行、静态检查、计时、report,最后一行 ch10 OK |
外推
这一篇我把第 5 篇的 Pid 搬到了 float32(C、C++、Rust 三种语言逐位一致,积分器会停,但停在 rpm),写了 Q16.16 的 PidQ(三种语言和 Python 逐位一致,差异 0),把它们放进三个上车的麻烦里:CAN 量化把 rpm 的稳态误差变成 0.298 rpm 的锯齿,周期抖动在实测补偿下 IAE 只变了 0.53%,M4F 上 float32 的 Pid 是 556 字节、Q16.16 的是 1332 字节。系列到这里是十篇:一个电机,加上 P、I、D,加上传递函数和频域,加上离散化和工程上的坑,加上整定、串级和多变量,最后是状态反馈和这一篇的嵌入式。
下一步不是再写一篇,是把它们装到真的 C 板上。我手上这些控制器(第 5 篇的 Pid、第 7 篇的串级、第 8 篇的矩阵增益、第 9 篇的 LQI)都是 no_std、无堆、可以编译到 M4F 的,而 RoboMaster 的云台还缺一样东西:第 7 篇里的角度和陀螺仪噪声是我从卡尔曼系列的第 4 篇借来的数(陀螺 0.01 rad/s,角度 rad)。真的上车时,这两个量应该来自那一篇的姿态估计,而不是 data/ 里的随机数:Kalman 的姿态输出作为第 7 篇串级的角度反馈,它的角速度估计作为内环的陀螺。我不知道真车上这个组合的相位裕度还有多少:滤波器自己有延迟,第 3 篇的延迟裕度那一套数就是为了这一刻准备的,我下一步想做的就是把滤波器的群延迟算进去,再看内环还剩几毫秒。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!