
 Better Mistakes



音乐
暂未播放
移植之前:float32、定长内存与每步耗时
七个滤波器(1D、KF、Mahony、EKF、ESKF、UKF,再加这一篇的 UD 版 ESKF),每个四种语言,跑过了同一份数据。这一篇不再写新的滤波器,只回答一个问题:如果我现在把它们搬到一块 Cortex-M4F 的板子上,会碰到什么。答案里最出乎我意料的是这个:一个我以为”换成 float32 就完事”的例子,在 float32 下只用了两步就把协方差算成了负数,而第 6 篇 C 版里一个不起眼的 fmod 调用,在 Cortex-M4F 上会悄悄拖进软件实现的 double 运算。
这一篇所有的数字都来自这台机器和这次 make ch08,没有一个来自真实的 MCU。凡是对 MCU 的推测我都会说明是推测。
这一篇结束时你会有:make ch08 通过(它先构建 double 和 float 两套,再顺序跑完所有检查和计时,最好在没有别的负载的机器上跑,大概 3 分钟),out/ch08/ 下的 float32 输出、sizes_*.txt、timing_*.csv,四张图;新模块 eskf_seq(顺序标量更新)、ud(UD 分解)、eskf_ud(UD 形式的 ESKF),各语言各一份;scripts/ch08_checks.sh(静态检查)。
前置:第 7 篇,尤其是第 3 篇关于 Joseph 形式和对称性的讨论。
要量什么
- float32 的精度代价:KF、ESKF、UKF 在 float32 下和 double 的 Python 参考差多少。
- 协方差的数值健康:顺序标量更新、UD 分解,和第 3 篇留下的那个病态例子。
- 内存:每个滤波器结构体多少字节。
- 有没有堆:C、C++、Rust 各自怎么证明。
- 代码体积:C 滤波器编译到 Cortex-M4F 上多大。
- 每步耗时:这台机器上七个滤波器的中位数,以及 numpy 慢多少。
- 移植清单,和一个硬铁偏置的演示。
float32
在第 1 篇我就把标量类型做成可切换的,所以 float32 构建不改任何滤波器代码:C 用 -DKL_USE_FLOAT(kl_real 变成 float,KL_SQRT 变成 sqrtf),C++ 的模板参数 T 取 float,Rust 打开 f32 特性(Real = f32,数学函数走 libm 的 sqrtf 等)。C 和 Rust 要分别构建,所以 make ch08 里有 build/c32 和 rust/target32 两个目录;C++ 一个二进制里两种精度都有。
ch08 run 在两种精度下处理种子 1 的数据,输出 out/ch08/<case>_<f64|f32>_<lang>.csv。double 构建先和 Python 参考对一遍(所有 9 个 case,最大差异小于 ,病态例子除外,和第 3 篇一样是 )。float32 的输出和 float64 的 Python 参考对比:
float32 vs the float64 Python reference (seed 1)case lang max attitude diff (deg) RMS (deg) max |db| (rad/s) min pminkf C 2.283e-05 5.346e-06 2.312e-07 nankf C++ 2.283e-05 5.346e-06 2.312e-07 nankf Rust 2.283e-05 5.365e-06 1.683e-07 naneskf C 2.102e-04 7.632e-05 8.476e-07 6.68e-08eskf C++ 1.707e-04 7.718e-05 7.436e-07 6.68e-08eskf Rust 1.788e-04 7.687e-05 6.021e-07 6.68e-08ukf C 7.688e-03 9.627e-04 2.776e-05 6.68e-08ukf C++ 5.747e-03 7.581e-04 1.828e-05 6.68e-08ukf Rust 6.319e-03 1.048e-03 1.400e-05 6.68e-08float32 ESKF, largest attitude difference between two native languages: 7.55e-05 deg- KF(第 2 篇的角度加零偏):角度最大偏差 度。
- ESKF:姿态最大偏差 到 度,三个语言各不相同(语言之间两两最大偏差 度,这是编译器对浮点表达式的不同合并方式,float32 没有逐位复现的保证)。
- UKF:最大偏差 到 度,是 ESKF 的 30 倍左右。我猜差别来自 sigma 点:13 个点加权求和以及一个额外的 Cholesky 分解,每一步多积累的舍入多得多,但我没有做实验去验证这个猜测。
- 三个滤波器的 的最小主元在整个运行中都是正的(整个运行里的最小值是 ,各版本一样)。
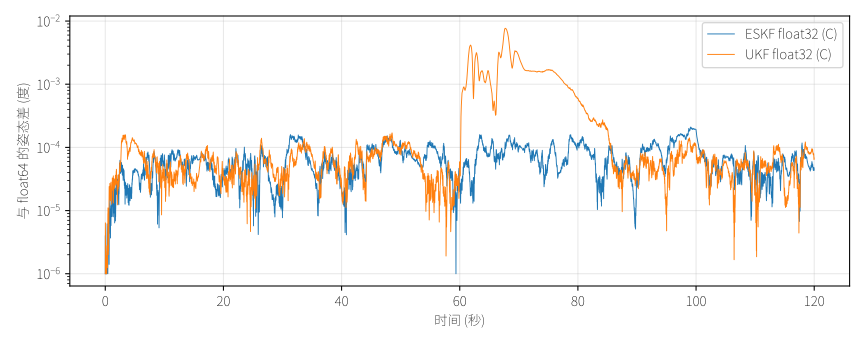
所以在这份数据上,float32 的代价是 到 度,比传感器的精度(加速度计噪声对应约 0.3 度的瞬时角度误差)小两到四个数量级。它不是问题。
顺序标量更新
加速度计的测量噪声是对角的,。三个分量相互独立,所以一次三维的更新可以换成三次一维的更新:每次一个分量, 是个标量,求 Cholesky 变成除一个数,没有矩阵求逆,没有 的分解。
为什么等价。 联合更新是”先验乘似然”,似然 因为噪声独立而分解成三个因子,贝叶斯公式可以一次乘一个:每处理一个分量,后验成为下一个分量的先验。对线性测量,这和联合更新给出同样的后验,是代数恒等式,不是近似。
对误差状态滤波器的一个细节。 三个分量用的 ( 的第 行)都在同一个名义姿态处线性化。处理第 个分量的时候,误差状态已经被前面的分量修正了 ,所以它的新息要减掉这部分:。三个分量处理完,才把累积的 一次性注入名义状态。如果每个分量处理完都注入,后一个分量的线性化点就变了,和联合更新不再等价。
实现:
"""Sequential scalar updates and a UD-factored ESKF (chapter 8). Built on kl.eskf.ESKF."""
import numpy as np
from .eskf import ESKFfrom .imu_sim import Gfrom .quat import qexp, qmul, qnormalize, qrot, skew, wrap_pifrom .ud import bierman_update, thornton_predict, ud_to_P
def scalar_update(P, h, r, y, joseph=True): """One scalar measurement: returns (dx, P_new). joseph=False is the short form (I - K h) P.""" s = h @ P @ h + r if not s > 0: raise np.linalg.LinAlgError("S is not positive") K = P @ h / s A = np.eye(len(h)) - np.outer(K, h) if joseph: Pn = A @ P @ A.T + r * np.outer(K, K) Pn = 0.5 * (Pn + Pn.T) else: Pn = A @ P return K * y, Pn
def update_accel_seq(f, accel, joseph=True): """Accelerometer update processing the three components one at a time (diagonal R).
Same linearization point for all three rows; the nominal state is injected once at the end. """ norm = np.sqrt(accel @ accel) if f.accel_gate is not None and abs(norm - G) > f.accel_gate: return False h = qrot(f.q).T @ np.array([0.0, 0.0, -1.0]) Hm = skew(h) y = accel / norm - h r = (f.sa / G) ** 2 dx = np.zeros(6) for j in range(3): hj = np.zeros(6) hj[:3] = Hm[j] dxj, f.P = scalar_update(f.P, hj, r, y[j] - hj @ dx, joseph) dx = dx + dxj f._inject(dx) return True
def update_mag_heading_seq(f, mag, joseph=True): norm = np.sqrt(mag @ mag) if f.mag_gate is not None and abs(norm - 1.0) > f.mag_gate: return False mw = qrot(f.q) @ mag y = wrap_pi(np.arctan2(mw[1], mw[0]) - np.arctan2(f.m_w[1], f.m_w[0])) h = np.zeros(6) h[:3] = f.heading_jacobian() r = (f.sm / np.hypot(f.m_w[0], f.m_w[1])) ** 2 dx, f.P = scalar_update(f.P, h, r, y, joseph) f._inject(dx) return TrueC、C++、Rust 的版本是各自一个新文件(有两处我碰了第 6 篇的东西:Rust 的 Eskf 的参数字段原来是私有的,我改成了 pub,别的没动;C 的 kl_eskf.c 里的 fmod,见后面的代码体积一节):
/* One scalar measurement h^T x + v, var(v) = r, innovation y: P in place, dx = K y. * w is scratch for 126 kl_real. Returns -1 (P unchanged) if s <= 0. */static int scalar_update(kl_real *P, const kl_real *h, kl_real r, kl_real y, int joseph, kl_real *dx, kl_real *w){ kl_real *Ph = w, *hP = Ph + 6, *K = hP + 6, *A = K + 6, *T = A + 36, *U = T + 36; kl_mat_mul(P, h, Ph, 6, 6, 1); kl_mat_mul(h, P, hP, 1, 6, 6); kl_real s = r; for (int i = 0; i < 6; i++) s += hP[i] * h[i]; if (!(s > 0)) return -1; for (int i = 0; i < 6; i++) { K[i] = Ph[i] / s; dx[i] = K[i] * y; } /* A = I - K h^T */ for (int i = 0; i < 6; i++) for (int j = 0; j < 6; j++) A[i * 6 + j] = (i == j) - K[i] * h[j]; kl_mat_mul(A, P, T, 6, 6, 6); if (joseph) { kl_mat_mul_bt(T, A, U, 6, 6, 6); for (int i = 0; i < 6; i++) for (int j = 0; j < 6; j++) P[i * 6 + j] = U[i * 6 + j] + r * (K[i] * K[j]); kl_mat_symmetrize(P, 6); } else { kl_mat_copy(T, P, 6, 6); } return 0;}inject 在这里又复制了一份(第 6 篇的那份是 static 的,我没有为了去重去改已经定稿的文件)。kl_eskf_update_accel_seq 在一份 P 的拷贝上工作,处理失败时不改动 f->P。
验证。 200 个随机的名义姿态和协方差,分别做向量更新和顺序更新,再做航向更新:
sequential scalar updates vs the vector update, 200 random states: max difference 6.73e-16在整段数据上,三种协方差更新形式(向量 Joseph、顺序 Joseph、顺序短形式)和 UD 形式在 float64 下的姿态差都小于 度。
UD 分解
第 3 篇我没能让短形式崩溃,Joseph 形式的优势是个”保证”而不是实测差距。UD 分解是更强的保证:不存 ,存它的分解 , 是对角线为 1 的上三角矩阵, 是对角矩阵。 半正定等价于 ;如果更新算法只做加法、乘法和除以正数, 就不会变成负数。数值上这还有个额外的好处: 的条件数是 的条件数的平方根, 的动态范围在 UD 里只是 ,float32(相对精度 )勉强装得下。
两个算法(Bierman 1977;Grewal 和 Andrews,Kalman Filtering: Theory and Practice):
测量更新(Bierman)。 标量测量 ,。令 ,。逐列 递推 (),
最后增益 。每一步都是正数的加、乘、除,没有减法抵消。我没有在这里重新推导它,而是按文献实现,再用数值检验:随机的 正定 ,Bierman 更新得到的 和 Joseph 形式的 在 以内, 差 。
时间更新(Thornton)。 要从 得到 的分解。把 ()的行,用权重 做修正的加权 Gram-Schmidt 正交化,得到新的 和 :因为 ,其中 ,正交化给出的就是它的 UD 分解。这里 是对角的,所以 的列配 。
"""UD (unit upper triangular x diagonal) covariance factorization, P = U D U^T.
Bierman's scalar measurement update and Thornton's time update (modified weightedGram-Schmidt). See G. J. Bierman, "Factorization Methods for Discrete SequentialEstimation" (1977) and Grewal and Andrews, "Kalman Filtering: Theory and Practice"."""
import numpy as np
def ud_factor(P): """P (symmetric positive definite) -> (U, D). Raises ValueError if a pivot is <= 0.""" n = P.shape[0] U = np.eye(n) D = np.zeros(n) A = P.copy() for j in range(n - 1, -1, -1): D[j] = A[j, j] if not D[j] > 0: raise ValueError("matrix is not positive definite") for i in range(j): U[i, j] = A[i, j] / D[j] for i in range(j): for k in range(i + 1): A[k, i] -= U[k, j] * D[j] * U[i, j] return U, D
def ud_to_P(U, D): return (U * D) @ U.T
def bierman_update(U, D, h, r, y): """Scalar measurement update of (U, D) in place; returns the correction dx = K y.
Measurement z = h x + v, var(v) = r, innovation y. Uses the Joseph-equivalent factored form, so P stays positive definite by construction. """ n = len(D) f = U.T @ h g = D * f b = np.zeros(n) alpha = r + f[0] * g[0] D[0] = D[0] * r / alpha b[0] = g[0] for j in range(1, n): gamma = alpha alpha = alpha + f[j] * g[j] D[j] = D[j] * gamma / alpha lam = -f[j] / gamma for i in range(j): s = U[i, j] U[i, j] = s + b[i] * lam b[i] = b[i] + s * g[j] b[j] = g[j] return b / alpha * y
def thornton_predict(U, D, F, qdiag): """Time update P <- F P F^T + diag(qdiag) in factored form. Returns new (U, D).""" n = len(D) W = np.hstack([F @ U, np.eye(n)]) # rows are the vectors to orthogonalize wt = np.concatenate([D, qdiag]) # their weights Un, Dn = np.eye(n), np.zeros(n) for j in range(n - 1, -1, -1): c = wt * W[j] Dn[j] = W[j] @ c d = c / Dn[j] for i in range(j): Un[i, j] = W[i] @ d W[i] = W[i] - Un[i, j] * W[j] return Un, DnC 版的 Bierman 更新(Python 的逐行翻译):
void kl_ud_bierman(kl_real *U, kl_real *D, const kl_real *h, kl_real r, kl_real y, int n, kl_real *dx, kl_real *work){ kl_real *f = work, *g = f + n, *b = g + n; for (int j = 0; j < n; j++) { f[j] = 0; for (int i = 0; i <= j; i++) f[j] += U[i * n + j] * h[i]; g[j] = D[j] * f[j]; } kl_real alpha = r + f[0] * g[0]; D[0] = D[0] * r / alpha; b[0] = g[0]; for (int j = 1; j < n; j++) { kl_real gamma = alpha; alpha = alpha + f[j] * g[j]; D[j] = D[j] * gamma / alpha; kl_real lam = -f[j] / gamma; for (int i = 0; i < j; i++) { kl_real s = U[i * n + j]; U[i * n + j] = s + b[i] * lam; b[i] = b[i] + s * g[j]; } b[j] = g[j]; } for (int i = 0; i < n; i++) dx[i] = b[i] / alpha * y;}C++ 版的 Thornton 时间更新(W 是 的 Mat,行就是被正交化的向量):
// Time update P <- F P F^T + diag(qdiag) in factored form, in place.// The rows of W = [F U | I] are orthogonalized with weights [D, qdiag].template <std::size_t N, class T>void thornton_predict(Mat<N, N, T>& U, std::array<T, N>& D, const Mat<N, N, T>& F, const std::array<T, N>& qdiag) { const Mat<N, N, T> FU = F * U; Mat<N, 2 * N, T> W{}; std::array<T, 2 * N> wt{}, c{}; for (std::size_t i = 0; i < N; i++) { for (std::size_t k = 0; k < N; k++) W(i, k) = FU(i, k); W(i, N + i) = 1; wt[i] = D[i]; wt[N + i] = qdiag[i]; } U = Mat<N, N, T>::identity(); for (std::size_t j = N; j-- > 0;) { T dj = 0; for (std::size_t k = 0; k < 2 * N; k++) { c[k] = wt[k] * W(j, k); dj += W(j, k) * c[k]; } D[j] = dj; for (std::size_t i = 0; i < j; i++) { T u = 0; for (std::size_t k = 0; k < 2 * N; k++) u += W(i, k) * (c[k] / dj); U(i, j) = u; for (std::size_t k = 0; k < 2 * N; k++) W(i, k) -= u * W(j, k); } }}Rust 版的同一个函数,结构一样,但是写法不同:稳定版 Rust 的 const 泛型里不能写 2 * N 当数组长度,所以 被拆成两个 的块 wa 和 wb,权重也拆成 d 和 qdiag,内积分两段累加:
/// Time update P <- F P F^T + diag(qdiag) in factored form, in place./// Orthogonalizes the rows of W = [F U | I] with weights [D, qdiag].pub fn thornton_predict<const N: usize>( u: &mut Mat<N, N>, d: &mut [Real; N], f: &Mat<N, N>, qdiag: &[Real; N],) { let mut wa = *f * *u; let mut wb = Mat::<N, N>::identity(); let mut un = Mat::<N, N>::identity(); let mut dn = [0.0; N]; for j in (0..N).rev() { let ca: [Real; N] = core::array::from_fn(|k| d[k] * wa.m[j][k]); let cb: [Real; N] = core::array::from_fn(|k| qdiag[k] * wb.m[j][k]); let mut dj = 0.0; for k in 0..N { dj += wa.m[j][k] * ca[k]; } for k in 0..N { dj += wb.m[j][k] * cb[k]; } dn[j] = dj; for i in 0..j { let mut s = 0.0; for k in 0..N { s += wa.m[i][k] * (ca[k] / dj); } for k in 0..N { s += wb.m[i][k] * (cb[k] / dj); } un.m[i][j] = s; for k in 0..N { wa.m[i][k] -= s * wa.m[j][k]; wb.m[i][k] -= s * wb.m[j][k]; } } } *u = un; *d = dn;}EskfUD 用它们替换了 ESKF 的协方差:predict 用 Thornton,加速度计三个分量用三次 Bierman(同样的线性化点,同样的 修正),航向一次。它没有重置雅可比(第 6 篇测过它的效果可以忽略,并且 不再是 UD 形式),所以对比的参照是 reset=False 的 ESKF。
class EskfUD: """ESKF whose covariance lives in UD form: Thornton predict, Bierman scalar updates.
No reset Jacobian (it would not preserve the factored form); compare with ESKF(reset=False). """
def __init__(self, sigma_g, sigma_bw, sigma_a, sigma_m, m_w, q0, P0, accel_gate=0.5, mag_gate=0.1): self.ref = ESKF(sigma_g, sigma_bw, sigma_a, sigma_m, m_w, q0, P0, accel_gate, mag_gate, reset=False) d = np.diag(P0).copy() assert np.allclose(np.diag(d), P0), "initial covariance must be diagonal" self.U, self.D = np.eye(6), d
q = property(lambda s: s.ref.q) b = property(lambda s: s.ref.b) P = property(lambda s: ud_to_P(s.U, s.D))
def predict(self, gyro, dt): f = self.ref dq = qexp((gyro - f.b) * dt) F = np.eye(6) F[:3, :3] = qrot(dq).T F[:3, 3:] = -dt * np.eye(3) qd = np.array([f.sg**2 * dt**2] * 3 + [f.sbw**2 * dt] * 3) f.q = qmul(f.q, dq) self.U, self.D = thornton_predict(self.U, self.D, F, qd)
def _inject(self, dx): f = self.ref f.q = qnormalize(qmul(f.q, qexp(dx[:3]))) f.b = f.b + dx[3:]
def update_accel(self, accel): f = self.ref norm = np.sqrt(accel @ accel) if f.accel_gate is not None and abs(norm - G) > f.accel_gate: return False h = qrot(f.q).T @ np.array([0.0, 0.0, -1.0]) Hm = skew(h) y = accel / norm - h r = (f.sa / G) ** 2 dx = np.zeros(6) for j in range(3): hj = np.zeros(6) hj[:3] = Hm[j] dx = dx + bierman_update(self.U, self.D, hj, r, y[j] - hj @ dx) self._inject(dx) return True
def update_mag_heading(self, mag): f = self.ref norm = np.sqrt(mag @ mag) if f.mag_gate is not None and abs(norm - 1.0) > f.mag_gate: return False mw = qrot(f.q) @ mag y = wrap_pi(np.arctan2(mw[1], mw[0]) - np.arctan2(f.m_w[1], f.m_w[0])) h = np.zeros(6) h[:3] = f.heading_jacobian() r = (f.sm / np.hypot(f.m_w[0], f.m_w[1])) ** 2 self._inject(bierman_update(self.U, self.D, h, r, y)) return True完整源码:c/include/kl/kl_ud.h、c/src/kl_ud.c、c/include/kl/kl_eskf_seq.h、c/src/kl_eskf_seq.c、c/include/kl/kl_eskf_ud.h、c/src/kl_eskf_ud.c
/* UD covariance factorization P = U D U^T: U unit upper triangular (row-major n x n, zeros below * the diagonal), D diagonal (n). Bierman's scalar measurement update and Thornton's time update * (modified weighted Gram-Schmidt). See G. J. Bierman, "Factorization Methods for Discrete * Sequential Estimation" (1977) and Grewal and Andrews, "Kalman Filtering: Theory and Practice". */#ifndef KL_UD_H#define KL_UD_H
#include "kl/kl_real.h"
/* Workspace sizes (kl_real count) */#define KL_UD_FACTOR_WORK_LEN(n) ((n) * (n))#define KL_UD_BIERMAN_WORK_LEN(n) (3 * (n))#define KL_UD_THORNTON_WORK_LEN(n) (4 * (n) * (n) + 6 * (n) + (n))#define KL_UD_PIVOT_WORK_LEN(n) ((n) * (n) + (n))
/* P (symmetric positive definite, upper triangle read) -> U, D. Returns -1 if a pivot is <= 0. */int kl_ud_factor(const kl_real *P, kl_real *U, kl_real *D, int n, kl_real *work);/* P = U diag(D) U^T */void kl_ud_to_p(const kl_real *U, const kl_real *D, kl_real *P, int n);/* Scalar update (z = h x + v, var(v) = r, innovation y) of U, D in place; dx = K y. * The factored form keeps P positive definite by construction. */void kl_ud_bierman(kl_real *U, kl_real *D, const kl_real *h, kl_real r, kl_real y, int n, kl_real *dx, kl_real *work);/* P <- F P F^T + diag(qdiag) in factored form, in place. */void kl_ud_thornton(kl_real *U, kl_real *D, const kl_real *F, const kl_real *qdiag, int n, kl_real *work);/* Smallest pivot of the UD elimination of P (upper triangle read). Never fails: a value <= 0 * means P is not positive definite. */kl_real kl_ud_min_pivot(const kl_real *P, int n, kl_real *work);
#endif#include "kl/kl_ud.h"
#include "kl/kl_mat.h"
int kl_ud_factor(const kl_real *P, kl_real *U, kl_real *D, int n, kl_real *work){ kl_real *A = work; kl_mat_copy(P, A, n, n); kl_mat_identity(U, n); for (int j = n - 1; j >= 0; j--) { D[j] = A[j * n + j]; if (!(D[j] > 0)) return -1; for (int i = 0; i < j; i++) U[i * n + j] = A[i * n + j] / D[j]; for (int i = 0; i < j; i++) for (int k = 0; k <= i; k++) A[k * n + i] -= U[k * n + j] * D[j] * U[i * n + j]; } return 0;}
void kl_ud_to_p(const kl_real *U, const kl_real *D, kl_real *P, int n){ for (int i = 0; i < n; i++) for (int j = 0; j < n; j++) { kl_real s = 0; for (int k = 0; k < n; k++) s += U[i * n + k] * D[k] * U[j * n + k]; P[i * n + j] = s; }}
void kl_ud_bierman(kl_real *U, kl_real *D, const kl_real *h, kl_real r, kl_real y, int n, kl_real *dx, kl_real *work){ kl_real *f = work, *g = f + n, *b = g + n; for (int j = 0; j < n; j++) { f[j] = 0; for (int i = 0; i <= j; i++) f[j] += U[i * n + j] * h[i]; g[j] = D[j] * f[j]; } kl_real alpha = r + f[0] * g[0]; D[0] = D[0] * r / alpha; b[0] = g[0]; for (int j = 1; j < n; j++) { kl_real gamma = alpha; alpha = alpha + f[j] * g[j]; D[j] = D[j] * gamma / alpha; kl_real lam = -f[j] / gamma; for (int i = 0; i < j; i++) { kl_real s = U[i * n + j]; U[i * n + j] = s + b[i] * lam; b[i] = b[i] + s * g[j]; } b[j] = g[j]; } for (int i = 0; i < n; i++) dx[i] = b[i] / alpha * y;}
void kl_ud_thornton(kl_real *U, kl_real *D, const kl_real *F, const kl_real *qdiag, int n, kl_real *work){ int m = 2 * n; kl_real *W = work; /* n x 2n: rows are the vectors to orthogonalize, [F U | I] */ kl_real *FU = W + n * m; /* n x n */ kl_real *Un = FU + n * n; /* n x n */ kl_real *wt = Un + n * n; /* 2n weights [D, qdiag] */ kl_real *c = wt + m; /* 2n */ kl_real *d = c + m; /* 2n */ kl_real *Dn = d + m; /* n */
kl_mat_mul(F, U, FU, n, n, n); for (int i = 0; i < n; i++) for (int k = 0; k < m; k++) W[i * m + k] = k < n ? FU[i * n + k] : (k - n == i ? 1 : 0); for (int k = 0; k < n; k++) { wt[k] = D[k]; wt[n + k] = qdiag[k]; } kl_mat_identity(Un, n); for (int j = n - 1; j >= 0; j--) { kl_real dj = 0; for (int k = 0; k < m; k++) { c[k] = wt[k] * W[j * m + k]; dj += W[j * m + k] * c[k]; } Dn[j] = dj; for (int k = 0; k < m; k++) d[k] = c[k] / dj; for (int i = 0; i < j; i++) { kl_real u = 0; for (int k = 0; k < m; k++) u += W[i * m + k] * d[k]; Un[i * n + j] = u; for (int k = 0; k < m; k++) W[i * m + k] -= u * W[j * m + k]; } } kl_mat_copy(Un, U, n, n); kl_mat_copy(Dn, D, n, 1);}
kl_real kl_ud_min_pivot(const kl_real *P, int n, kl_real *work){ kl_real *A = work, *u = work + n * n; kl_real dmin = (kl_real)INFINITY; kl_mat_copy(P, A, n, n); for (int j = n - 1; j >= 0; j--) { kl_real d = A[j * n + j]; if (d < dmin) dmin = d; if (d == 0) continue; for (int k = 0; k < j; k++) u[k] = A[k * n + j] / d; for (int i = 0; i < j; i++) for (int k = 0; k <= i; k++) A[k * n + i] -= u[k] * d * u[i]; } return dmin;}/* Sequential scalar measurement updates for the ESKF (diagonal R, no matrix inverse or Cholesky). * Same linearization point for every row; the nominal state is injected once at the end. */#ifndef KL_ESKF_SEQ_H#define KL_ESKF_SEQ_H
#include "kl/kl_eskf.h"
/* Accelerometer update, one component at a time. joseph = 0 uses the short form (I - K h) P. * Return 1 if applied, 0 if gated out, -1 if a scalar innovation variance is <= 0 (state unchanged). */int kl_eskf_update_accel_seq(kl_eskf *f, const kl_real accel[3], int joseph);/* Heading-only magnetometer update as one scalar update; same return convention. */int kl_eskf_update_mag_heading_seq(kl_eskf *f, const kl_real mag[3], int joseph);
#endif#include "kl/kl_eskf_seq.h"
#include "kl/kl_ekf_att.h"#include "kl/kl_mat.h"#include "kl/kl_quat.h"
/* One scalar measurement h^T x + v, var(v) = r, innovation y: P in place, dx = K y. * w is scratch for 126 kl_real. Returns -1 (P unchanged) if s <= 0. */static int scalar_update(kl_real *P, const kl_real *h, kl_real r, kl_real y, int joseph, kl_real *dx, kl_real *w){ kl_real *Ph = w, *hP = Ph + 6, *K = hP + 6, *A = K + 6, *T = A + 36, *U = T + 36; kl_mat_mul(P, h, Ph, 6, 6, 1); kl_mat_mul(h, P, hP, 1, 6, 6); kl_real s = r; for (int i = 0; i < 6; i++) s += hP[i] * h[i]; if (!(s > 0)) return -1; for (int i = 0; i < 6; i++) { K[i] = Ph[i] / s; dx[i] = K[i] * y; } /* A = I - K h^T */ for (int i = 0; i < 6; i++) for (int j = 0; j < 6; j++) A[i * 6 + j] = (i == j) - K[i] * h[j]; kl_mat_mul(A, P, T, 6, 6, 6); if (joseph) { kl_mat_mul_bt(T, A, U, 6, 6, 6); for (int i = 0; i < 6; i++) for (int j = 0; j < 6; j++) P[i * 6 + j] = U[i * 6 + j] + r * (K[i] * K[j]); kl_mat_symmetrize(P, 6); } else { kl_mat_copy(T, P, 6, 6); } return 0;}
/* q = normalize(q (x) exp(dtheta)), b += db, then the reset Jacobian if f->reset */static void inject(kl_eskf *f, const kl_real dx[6]){ kl_real *G = f->work, *T = G + 36, *U = T + 36; kl_real dq[4], qn[4]; kl_quat_exp(dx, dq); kl_quat_mul(f->q, dq, qn); kl_quat_normalize(qn); kl_mat_copy(qn, f->q, 4, 1); for (int i = 0; i < 3; i++) f->b[i] += dx[3 + i]; if (f->reset) { kl_real half[3] = {(kl_real)0.5 * dx[0], (kl_real)0.5 * dx[1], (kl_real)0.5 * dx[2]}; kl_real S[9]; kl_skew(half, S); kl_mat_identity(G, 6); for (int i = 0; i < 3; i++) for (int j = 0; j < 3; j++) G[i * 6 + j] -= S[i * 3 + j]; kl_mat_mul(G, f->P, T, 6, 6, 6); kl_mat_mul_bt(T, G, U, 6, 6, 6); kl_mat_copy(U, f->P, 6, 6); }}
int kl_eskf_update_accel_seq(kl_eskf *f, const kl_real accel[3], int joseph){ kl_real *Pw = f->work, *w = Pw + 36; kl_real norm = KL_SQRT(accel[0] * accel[0] + accel[1] * accel[1] + accel[2] * accel[2]); if (f->accel_gate >= 0 && KL_FABS(norm - (kl_real)KL_GRAVITY) > f->accel_gate) return 0; const kl_real down[3] = {0, 0, -1}; kl_real h[3], S[9], y[3], dx[6] = {0, 0, 0, 0, 0, 0}, dxj[6]; kl_real r = (f->sa / (kl_real)KL_GRAVITY) * (f->sa / (kl_real)KL_GRAVITY); kl_ekf_att_rot_inv(f->q, down, h); kl_skew(h, S); for (int i = 0; i < 3; i++) y[i] = accel[i] / norm - h[i]; kl_mat_copy(f->P, Pw, 6, 6); /* work on a copy so a failure leaves P untouched */ for (int j = 0; j < 3; j++) { kl_real hj[6] = {S[j * 3], S[j * 3 + 1], S[j * 3 + 2], 0, 0, 0}, hd = 0; for (int k = 0; k < 6; k++) hd += hj[k] * dx[k]; if (scalar_update(Pw, hj, r, y[j] - hd, joseph, dxj, w) != 0) return -1; for (int k = 0; k < 6; k++) dx[k] += dxj[k]; } kl_mat_copy(Pw, f->P, 6, 6); inject(f, dx); return 1;}
int kl_eskf_update_mag_heading_seq(kl_eskf *f, const kl_real mag[3], int joseph){ kl_real *Pw = f->work, *w = Pw + 36; kl_real norm = KL_SQRT(mag[0] * mag[0] + mag[1] * mag[1] + mag[2] * mag[2]); if (f->mag_gate >= 0 && KL_FABS(norm - 1) > f->mag_gate) return 0; kl_real C[9], mw[3], h[6] = {0, 0, 0, 0, 0, 0}, dx[6], y; kl_quat_to_dcm(f->q, C); kl_mat_mul(C, mag, mw, 3, 3, 1); y = kl_wrap_pi(KL_ATAN2(mw[1], mw[0]) - KL_ATAN2(f->m_w[1], f->m_w[0])); kl_eskf_heading_jacobian(f, h); kl_real mh = KL_SQRT(f->m_w[0] * f->m_w[0] + f->m_w[1] * f->m_w[1]); kl_real r = (f->sm / mh) * (f->sm / mh); kl_mat_copy(f->P, Pw, 6, 6); if (scalar_update(Pw, h, r, y, joseph, dx, w) != 0) return -1; kl_mat_copy(Pw, f->P, 6, 6); inject(f, dx); return 1;}/* ESKF whose covariance lives in UD form: Thornton predict, Bierman scalar updates. * No reset Jacobian (it would not preserve the factored form); compare with kl_eskf (reset = 0). * Quaternion conventions: see kl_quat.h. All storage is inline. */#ifndef KL_ESKF_UD_H#define KL_ESKF_UD_H
#include "kl/kl_real.h"
typedef struct { kl_real q[4], b[3]; kl_real U[36], D[6]; /* P = U diag(D) U^T */ kl_real sg, sbw, sa, sm; kl_real m_w[3]; kl_real accel_gate, mag_gate; /* negative disables the gate */ kl_real work[256];} kl_eskf_ud;
/* p0_diag: initial diagonal of P (6); the initial covariance is diagonal so U = I, D = p0_diag. */void kl_eskf_ud_init(kl_eskf_ud *f, const kl_real q0[4], const kl_real p0_diag[6], kl_real sigma_g, kl_real sigma_bw, kl_real sigma_a, kl_real sigma_m, const kl_real m_w[3], kl_real accel_gate, kl_real mag_gate);void kl_eskf_ud_predict(kl_eskf_ud *f, const kl_real gyro[3], kl_real dt);/* Three sequential Bierman updates. Return 1 applied, 0 gated out. */int kl_eskf_ud_update_accel(kl_eskf_ud *f, const kl_real accel[3]);int kl_eskf_ud_update_mag_heading(kl_eskf_ud *f, const kl_real mag[3]);/* P = U diag(D) U^T (6x6) */void kl_eskf_ud_cov(const kl_eskf_ud *f, kl_real P[36]);
#endif#include "kl/kl_eskf_ud.h"
#include "kl/kl_ekf_att.h"#include "kl/kl_eskf.h"#include "kl/kl_mat.h"#include "kl/kl_quat.h"#include "kl/kl_ud.h"
void kl_eskf_ud_init(kl_eskf_ud *f, const kl_real q0[4], const kl_real p0_diag[6], kl_real sigma_g, kl_real sigma_bw, kl_real sigma_a, kl_real sigma_m, const kl_real m_w[3], kl_real accel_gate, kl_real mag_gate){ kl_mat_copy(q0, f->q, 4, 1); kl_mat_copy(m_w, f->m_w, 3, 1); kl_mat_copy(p0_diag, f->D, 6, 1); kl_mat_identity(f->U, 6); for (int i = 0; i < 3; i++) f->b[i] = 0; f->sg = sigma_g; f->sbw = sigma_bw; f->sa = sigma_a; f->sm = sigma_m; f->accel_gate = accel_gate; f->mag_gate = mag_gate;}
void kl_eskf_ud_cov(const kl_eskf_ud *f, kl_real P[36]){ kl_ud_to_p(f->U, f->D, P, 6);}
void kl_eskf_ud_predict(kl_eskf_ud *f, const kl_real gyro[3], kl_real dt){ kl_real F[36], qd[6], omega[3], dq[4], C[9], qn[4]; for (int i = 0; i < 3; i++) omega[i] = (gyro[i] - f->b[i]) * dt; kl_quat_exp(omega, dq); kl_quat_to_dcm(dq, C); kl_mat_identity(F, 6); for (int i = 0; i < 3; i++) { for (int j = 0; j < 3; j++) F[i * 6 + j] = C[j * 3 + i]; F[i * 6 + 3 + i] = -dt; qd[i] = f->sg * f->sg * dt * dt; qd[3 + i] = f->sbw * f->sbw * dt; } kl_quat_mul(f->q, dq, qn); kl_mat_copy(qn, f->q, 4, 1); kl_ud_thornton(f->U, f->D, F, qd, 6, f->work);}
static void inject(kl_eskf_ud *f, const kl_real dx[6]){ kl_real dq[4], qn[4]; kl_quat_exp(dx, dq); kl_quat_mul(f->q, dq, qn); kl_quat_normalize(qn); kl_mat_copy(qn, f->q, 4, 1); for (int i = 0; i < 3; i++) f->b[i] += dx[3 + i];}
int kl_eskf_ud_update_accel(kl_eskf_ud *f, const kl_real accel[3]){ kl_real norm = KL_SQRT(accel[0] * accel[0] + accel[1] * accel[1] + accel[2] * accel[2]); if (f->accel_gate >= 0 && KL_FABS(norm - (kl_real)KL_GRAVITY) > f->accel_gate) return 0; const kl_real down[3] = {0, 0, -1}; kl_real h[3], S[9], y[3], dx[6] = {0, 0, 0, 0, 0, 0}, dxj[6]; kl_real r = (f->sa / (kl_real)KL_GRAVITY) * (f->sa / (kl_real)KL_GRAVITY); kl_ekf_att_rot_inv(f->q, down, h); kl_skew(h, S); for (int i = 0; i < 3; i++) y[i] = accel[i] / norm - h[i]; for (int j = 0; j < 3; j++) { kl_real hj[6] = {S[j * 3], S[j * 3 + 1], S[j * 3 + 2], 0, 0, 0}, hd = 0; for (int k = 0; k < 6; k++) hd += hj[k] * dx[k]; kl_ud_bierman(f->U, f->D, hj, r, y[j] - hd, 6, dxj, f->work); for (int k = 0; k < 6; k++) dx[k] += dxj[k]; } inject(f, dx); return 1;}
int kl_eskf_ud_update_mag_heading(kl_eskf_ud *f, const kl_real mag[3]){ kl_real norm = KL_SQRT(mag[0] * mag[0] + mag[1] * mag[1] + mag[2] * mag[2]); if (f->mag_gate >= 0 && KL_FABS(norm - 1) > f->mag_gate) return 0; kl_real C[9], mw[3], h[6] = {0, 0, 0, 0, 0, 0}, dx[6], y; kl_quat_to_dcm(f->q, C); kl_mat_mul(C, mag, mw, 3, 3, 1); y = kl_wrap_pi(KL_ATAN2(mw[1], mw[0]) - KL_ATAN2(f->m_w[1], f->m_w[0])); /* d heading / d dtheta = [mx mz, my mz, -(mx^2+my^2)] / (mx^2+my^2) C(q) */ kl_real mx = f->m_w[0], my = f->m_w[1], mz = f->m_w[2], mh2 = mx * mx + my * my; kl_real v[3] = {mx * mz / mh2, my * mz / mh2, -1}; for (int j = 0; j < 3; j++) h[j] = v[0] * C[j] + v[1] * C[3 + j] + v[2] * C[6 + j]; kl_real r = (f->sm / KL_SQRT(mh2)) * (f->sm / KL_SQRT(mh2)); kl_ud_bierman(f->U, f->D, h, r, y, 6, dx, f->work); inject(f, dx); return 1;}完整源码:cpp/include/kl/ud.hpp、eskf_seq.hpp、eskf_ud.hpp
// UD (unit upper triangular x diagonal) covariance factorization, P = U D U^T.// Bierman's scalar measurement update and Thornton's time update (modified weighted// Gram-Schmidt). See G. J. Bierman, "Factorization Methods for Discrete Sequential// Estimation" (1977) and Grewal and Andrews, "Kalman Filtering: Theory and Practice".// U is stored as a full N x N matrix with unit diagonal and zeros below it.#pragma once#include <limits>
#include "kl/mat.hpp"
namespace kl {
// P (symmetric positive definite, upper triangle read) -> (U, D).// Returns false if a pivot is <= 0.template <std::size_t N, class T>bool ud_factor(const Mat<N, N, T>& P, Mat<N, N, T>& U, std::array<T, N>& D) { U = Mat<N, N, T>::identity(); Mat<N, N, T> A = P; for (std::size_t j = N; j-- > 0;) { D[j] = A(j, j); if (!(D[j] > 0)) return false; for (std::size_t i = 0; i < j; i++) U(i, j) = A(i, j) / D[j]; for (std::size_t i = 0; i < j; i++) for (std::size_t k = 0; k <= i; k++) A(k, i) -= U(k, j) * D[j] * U(i, j); } return true;}
template <std::size_t N, class T>Mat<N, N, T> ud_to_p(const Mat<N, N, T>& U, const std::array<T, N>& D) { Mat<N, N, T> UD = U; for (std::size_t i = 0; i < N; i++) for (std::size_t j = 0; j < N; j++) UD(i, j) *= D[j]; return UD * U.transpose();}
// Scalar measurement update of (U, D) in place; returns the correction dx = K y.// Measurement z = h x + v, var(v) = r, innovation y. Positive definiteness is kept// by construction (no subtraction of covariances).template <std::size_t N, class T>Mat<N, 1, T> bierman_update(Mat<N, N, T>& U, std::array<T, N>& D, const Mat<N, 1, T>& h, T r, T y) { std::array<T, N> f{}, g{}, b{}; for (std::size_t j = 0; j < N; j++) { for (std::size_t i = 0; i < N; i++) f[j] += U(i, j) * h(i, 0); // f = U^T h g[j] = D[j] * f[j]; } T alpha = r + f[0] * g[0]; D[0] = D[0] * r / alpha; b[0] = g[0]; for (std::size_t j = 1; j < N; j++) { const T gamma = alpha; alpha = alpha + f[j] * g[j]; D[j] = D[j] * gamma / alpha; const T lam = -f[j] / gamma; for (std::size_t i = 0; i < j; i++) { const T s = U(i, j); U(i, j) = s + b[i] * lam; b[i] = b[i] + s * g[j]; } b[j] = g[j]; } Mat<N, 1, T> dx; for (std::size_t i = 0; i < N; i++) dx(i, 0) = b[i] / alpha * y; return dx;}
// Time update P <- F P F^T + diag(qdiag) in factored form, in place.// The rows of W = [F U | I] are orthogonalized with weights [D, qdiag].template <std::size_t N, class T>void thornton_predict(Mat<N, N, T>& U, std::array<T, N>& D, const Mat<N, N, T>& F, const std::array<T, N>& qdiag) { const Mat<N, N, T> FU = F * U; Mat<N, 2 * N, T> W{}; std::array<T, 2 * N> wt{}, c{}; for (std::size_t i = 0; i < N; i++) { for (std::size_t k = 0; k < N; k++) W(i, k) = FU(i, k); W(i, N + i) = 1; wt[i] = D[i]; wt[N + i] = qdiag[i]; } U = Mat<N, N, T>::identity(); for (std::size_t j = N; j-- > 0;) { T dj = 0; for (std::size_t k = 0; k < 2 * N; k++) { c[k] = wt[k] * W(j, k); dj += W(j, k) * c[k]; } D[j] = dj; for (std::size_t i = 0; i < j; i++) { T u = 0; for (std::size_t k = 0; k < 2 * N; k++) u += W(i, k) * (c[k] / dj); U(i, j) = u; for (std::size_t k = 0; k < 2 * N; k++) W(i, k) -= u * W(j, k); } }}
// Smallest pivot of the UD elimination of P (reads the upper triangle only).// Unlike ud_factor this never fails: a value <= 0 means P is not positive definite.template <std::size_t N, class T>T min_pivot(const Mat<N, N, T>& P) { Mat<N, N, T> A = P; T dmin = std::numeric_limits<T>::infinity(); for (std::size_t j = N; j-- > 0;) { const T d = A(j, j); dmin = d < dmin ? d : dmin; if (d == 0) continue; std::array<T, N> u{}; for (std::size_t i = 0; i < j; i++) u[i] = A(i, j) / d; for (std::size_t i = 0; i < j; i++) for (std::size_t k = 0; k <= i; k++) A(k, i) -= u[k] * d * u[i]; } return dmin;}
} // namespace kl// Sequential scalar updates for the ESKF: with a diagonal R the measurement// components are processed one at a time, so no matrix inverse or Cholesky is needed.#pragma once#include "kl/eskf.hpp"
namespace kl {
// One scalar measurement z = h^T x + v, var(v) = r, innovation y.// Updates P (short form (I - K h^T) P unless joseph) and returns dx = K y.// Returns false, leaving P unchanged, if the innovation variance is not positive.template <class T>bool scalar_update(Mat<6, 6, T>& P, const Mat<6, 1, T>& h, T r, T y, bool joseph, Mat<6, 1, T>& dx) { const T s = (h.transpose() * P * h)(0, 0) + r; if (!(s > 0)) return false; const Mat<6, 1, T> Ph = P * h; Mat<6, 1, T> K; for (std::size_t i = 0; i < 6; i++) K(i, 0) = Ph(i, 0) / s; const Mat<6, 6, T> A = Mat<6, 6, T>::identity() - K * h.transpose(); P = joseph ? (A * P * A.transpose() + (K * K.transpose()) * r).symmetrized() : A * P; dx = K * y; return true;}
namespace detail {
// Injection as in ESKF::inject (duplicated so the ESKF class stays untouched).template <class T>void inject(ESKF<T>& f, const Mat<6, 1, T>& dx) { const Vec3<T> dth{{dx(0, 0), dx(1, 0), dx(2, 0)}}; f.q = (f.q * Quat<T>::exp(dth)).normalized(); f.b = f.b + Vec3<T>{{dx(3, 0), dx(4, 0), dx(5, 0)}}; if (f.reset) { Mat<6, 6, T> G = Mat<6, 6, T>::identity(); const Mat<3, 3, T> S = skew(dth * T(0.5)); for (std::size_t i = 0; i < 3; i++) for (std::size_t j = 0; j < 3; j++) G(i, j) -= S(i, j); f.P = G * f.P * G.transpose(); }}
} // namespace detail
// Accelerometer update, one component at a time. All three rows share the// linearization point; the nominal state is injected once at the end.// Returns false when gated out or on failure (state unchanged).template <class T>bool update_accel_seq(ESKF<T>& f, const Vec3<T>& accel, bool joseph = true) { const T norm = std::sqrt(dot(accel, accel)); if (f.accel_gate >= 0 && std::fabs(norm - T(GRAVITY)) > f.accel_gate) return false; const Vec3<T> h = f.q.dcm().transpose() * Vec3<T>{{0, 0, -1}}; const Mat<3, 3, T> Hm = skew(h); const Vec3<T> y = accel * (1 / norm) - h; const T r = (f.sa / T(GRAVITY)) * (f.sa / T(GRAVITY)); Mat<6, 6, T> P = f.P; Mat<6, 1, T> dx{}; for (std::size_t j = 0; j < 3; j++) { Mat<6, 1, T> hj{}, dxj; for (std::size_t i = 0; i < 3; i++) hj(i, 0) = Hm(j, i); if (!scalar_update(P, hj, r, y(j, 0) - (hj.transpose() * dx)(0, 0), joseph, dxj)) return false; dx = dx + dxj; } f.P = P; detail::inject(f, dx); return true;}
// Heading-only magnetometer update as a single scalar measurement.template <class T>bool update_mag_heading_seq(ESKF<T>& f, const Vec3<T>& mag, bool joseph = true) { const T norm = std::sqrt(dot(mag, mag)); if (f.mag_gate >= 0 && std::fabs(norm - 1) > f.mag_gate) return false; const Vec3<T> mw = f.q.dcm() * mag; const T y = wrap_pi(std::atan2(mw(1, 0), mw(0, 0)) - std::atan2(f.m_w(1, 0), f.m_w(0, 0))); Mat<6, 1, T> h{}, dx; const Mat<1, 3, T> Hp = f.heading_jacobian(); for (std::size_t j = 0; j < 3; j++) h(j, 0) = Hp(0, j); const T r = f.sm / std::hypot(f.m_w(0, 0), f.m_w(1, 0)); Mat<6, 6, T> P = f.P; if (!scalar_update(P, h, r * r, y, joseph, dx)) return false; f.P = P; detail::inject(f, dx); return true;}
} // namespace kl// ESKF whose covariance lives in UD form: Thornton predict, Bierman scalar updates.// There is no reset Jacobian (it would not preserve the factored form), so compare// with ESKF(reset = false).#pragma once#include "kl/eskf.hpp"#include "kl/ud.hpp"
namespace kl {
template <class T = double>class EskfUD {public: Quat<T> q; Vec3<T> b{}; Mat<6, 6, T> U = Mat<6, 6, T>::identity(); std::array<T, 6> D; T sg, sbw, sa, sm; Vec3<T> m_w; T accel_gate, mag_gate; // negative disables the gate
// p0_diag: the initial covariance must be diagonal, so U = I and D = p0_diag. EskfUD(T sigma_g, T sigma_bw, T sigma_a, T sigma_m, const Vec3<T>& m_w, const Quat<T>& q0, const std::array<T, 6>& p0_diag, T accel_gate = T(0.5), T mag_gate = T(0.1)) : q(q0), D(p0_diag), sg(sigma_g), sbw(sigma_bw), sa(sigma_a), sm(sigma_m), m_w(m_w), accel_gate(accel_gate), mag_gate(mag_gate) {}
Mat<6, 6, T> P() const { return ud_to_p(U, D); }
void predict(const Vec3<T>& gyro, T dt) { const Quat<T> dq = Quat<T>::exp((gyro - b) * dt); const Mat<3, 3, T> Ct = dq.dcm().transpose(); Mat<6, 6, T> F = Mat<6, 6, T>::identity(); std::array<T, 6> qd; for (std::size_t i = 0; i < 3; i++) { for (std::size_t j = 0; j < 3; j++) F(i, j) = Ct(i, j); F(i, 3 + i) = -dt; qd[i] = sg * sg * dt * dt; qd[3 + i] = sbw * sbw * dt; } q = q * dq; // not normalized here thornton_predict(U, D, F, qd); }
// Gravity-direction update as three sequential Bierman updates. // Returns false when gated out. bool update_accel(const Vec3<T>& accel) { const T norm = std::sqrt(dot(accel, accel)); if (accel_gate >= 0 && std::fabs(norm - T(GRAVITY)) > accel_gate) return false; const Vec3<T> h = q.dcm().transpose() * Vec3<T>{{0, 0, -1}}; const Mat<3, 3, T> Hm = skew(h); const Vec3<T> y = accel * (1 / norm) - h; const T r = (sa / T(GRAVITY)) * (sa / T(GRAVITY)); Mat<6, 1, T> dx{}; for (std::size_t j = 0; j < 3; j++) { Mat<6, 1, T> hj{}; for (std::size_t i = 0; i < 3; i++) hj(i, 0) = Hm(j, i); dx = dx + bierman_update(U, D, hj, r, y(j, 0) - (hj.transpose() * dx)(0, 0)); } inject(dx); return true; }
// Heading-only magnetometer update as one Bierman update. Returns false when gated out. bool update_mag_heading(const Vec3<T>& mag) { const T norm = std::sqrt(dot(mag, mag)); if (mag_gate >= 0 && std::fabs(norm - 1) > mag_gate) return false; const Mat<3, 3, T> C = q.dcm(); const Vec3<T> mw = C * mag; const T y = wrap_pi(std::atan2(mw(1, 0), mw(0, 0)) - std::atan2(m_w(1, 0), m_w(0, 0))); const T mx = m_w(0, 0), my = m_w(1, 0), mz = m_w(2, 0), mh2 = mx * mx + my * my; const Mat<1, 3, T> Hp = Mat<1, 3, T>{{mx * mz / mh2, my * mz / mh2, T(-1)}} * C; Mat<6, 1, T> h{}; for (std::size_t j = 0; j < 3; j++) h(j, 0) = Hp(0, j); const T r = sm / std::hypot(mx, my); inject(bierman_update(U, D, h, r * r, y)); return true; }
private: void inject(const Mat<6, 1, T>& dx) { q = (q * Quat<T>::exp(Vec3<T>{{dx(0, 0), dx(1, 0), dx(2, 0)}})).normalized(); b = b + Vec3<T>{{dx(3, 0), dx(4, 0), dx(5, 0)}}; }};
} // namespace kl完整源码:rust/src/ud.rs、eskf_seq.rs、eskf_ud.rs
//! UD covariance factorization, P = U D U^T, U unit upper triangular, D diagonal.//!//! Bierman's scalar measurement update and Thornton's time update (modified//! weighted Gram-Schmidt). See G. J. Bierman, "Factorization Methods for Discrete//! Sequential Estimation" (1977) and Grewal and Andrews, "Kalman Filtering: Theory//! and Practice".#![allow(clippy::needless_range_loop)]
use crate::mat::Mat;use crate::real::Real;
/// P (symmetric positive definite) -> (U, D). `None` if a pivot is not positive.pub fn ud_factor<const N: usize>(p: &Mat<N, N>) -> Option<(Mat<N, N>, [Real; N])> { let mut u = Mat::<N, N>::identity(); let mut d = [0.0; N]; let mut a = *p; for j in (0..N).rev() { d[j] = a.m[j][j]; if d[j].is_nan() || d[j] <= 0.0 { return None; } for i in 0..j { u.m[i][j] = a.m[i][j] / d[j]; } for i in 0..j { for k in 0..=i { a.m[k][i] -= u.m[k][j] * d[j] * u.m[i][j]; } } } Some((u, d))}
/// U diag(D) U^Tpub fn ud_to_p<const N: usize>(u: &Mat<N, N>, d: &[Real; N]) -> Mat<N, N> { let mut ud = *u; for row in ud.m.iter_mut() { for (v, dj) in row.iter_mut().zip(d) { *v *= dj; } } ud * u.transpose()}
/// Scalar measurement update of (U, D) in place; returns the correction dx = K y./// Measurement z = h x + v, var(v) = r, innovation y. Factored Joseph-equivalent/// form: P stays positive definite by construction.pub fn bierman_update<const N: usize>( u: &mut Mat<N, N>, d: &mut [Real; N], h: &[Real; N], r: Real, y: Real,) -> [Real; N] { let mut f = [0.0; N]; let mut g = [0.0; N]; for j in 0..N { for i in 0..N { f[j] += u.m[i][j] * h[i]; } g[j] = d[j] * f[j]; } let mut b = [0.0; N]; let mut alpha = r + f[0] * g[0]; d[0] = d[0] * r / alpha; b[0] = g[0]; for j in 1..N { let gamma = alpha; alpha += f[j] * g[j]; d[j] = d[j] * gamma / alpha; let lam = -f[j] / gamma; for i in 0..j { let s = u.m[i][j]; u.m[i][j] = s + b[i] * lam; b[i] += s * g[j]; } b[j] = g[j]; } b.map(|bi| bi / alpha * y)}
/// Time update P <- F P F^T + diag(qdiag) in factored form, in place./// Orthogonalizes the rows of W = [F U | I] with weights [D, qdiag].pub fn thornton_predict<const N: usize>( u: &mut Mat<N, N>, d: &mut [Real; N], f: &Mat<N, N>, qdiag: &[Real; N],) { let mut wa = *f * *u; let mut wb = Mat::<N, N>::identity(); let mut un = Mat::<N, N>::identity(); let mut dn = [0.0; N]; for j in (0..N).rev() { let ca: [Real; N] = core::array::from_fn(|k| d[k] * wa.m[j][k]); let cb: [Real; N] = core::array::from_fn(|k| qdiag[k] * wb.m[j][k]); let mut dj = 0.0; for k in 0..N { dj += wa.m[j][k] * ca[k]; } for k in 0..N { dj += wb.m[j][k] * cb[k]; } dn[j] = dj; for i in 0..j { let mut s = 0.0; for k in 0..N { s += wa.m[i][k] * (ca[k] / dj); } for k in 0..N { s += wb.m[i][k] * (cb[k] / dj); } un.m[i][j] = s; for k in 0..N { wa.m[i][k] -= s * wa.m[j][k]; wb.m[i][k] -= s * wb.m[j][k]; } } } *u = un; *d = dn;}
/// Smallest pivot of the UD elimination of P (reads the upper triangle only)./// Unlike `ud_factor` this never fails: a value <= 0 means P is not positive definite.pub fn min_pivot<const N: usize>(p: &Mat<N, N>) -> Real { let mut a = *p; let mut dmin = Real::INFINITY; for j in (0..N).rev() { let d = a.m[j][j]; if d < dmin { dmin = d; } if d == 0.0 { continue; } let u: [Real; N] = core::array::from_fn(|k| if k < j { a.m[k][j] / d } else { 0.0 }); for i in 0..j { for k in 0..=i { a.m[k][i] -= u[k] * d * u[i]; } } } dmin}//! Sequential scalar updates for the ESKF (diagonal R, no Cholesky, no inverse).
#![allow(clippy::needless_range_loop)]use crate::ekf_att::G;use crate::eskf::{Eskf, wrap_pi};use crate::mat::Mat;use crate::quat::{Quat, skew};use crate::real::{Real, atan2, fabs, sqrt};
/// One scalar measurement with row `h`: returns dx = K y and replaces `p`./// `joseph = false` is the short form (I - K h) P. `None` if S <= 0.fn scalar_update( p: &mut Mat<6, 6>, h: &[Real; 6], r: Real, y: Real, joseph: bool,) -> Option<[Real; 6]> { let hr = Mat::<1, 6> { m: [*h] }; let ph = *p * hr.transpose(); let s = (hr * ph).m[0][0] + r; if s.is_nan() || s <= 0.0 { return None; } let k = ph * (1.0 / s); let a = Mat::<6, 6>::identity() - k * hr; *p = if joseph { (a * *p * a.transpose() + (k * k.transpose()) * r).symmetrized() } else { a * *p }; Some(k.m.map(|row| row[0] * y))}
/// Inject the error state (no reset Jacobian is applied when `f.reset` is false).fn inject(f: &mut Eskf, dx: &[Real; 6]) { f.q = (f.q * Quat::exp([dx[0], dx[1], dx[2]])).normalized(); for i in 0..3 { f.b[i] += dx[3 + i]; } if f.reset { let s = skew([0.5 * dx[0], 0.5 * dx[1], 0.5 * dx[2]]); let mut g = Mat::<6, 6>::identity(); for i in 0..3 { for j in 0..3 { g.m[i][j] -= s.m[i][j]; } } f.p = g * f.p * g.transpose(); }}
/// Accelerometer update processing the three components one at a time. All rows/// share one linearization point; the nominal state is injected once at the end./// False when gated out or on failure (state unchanged).pub fn update_accel_seq(f: &mut Eskf, accel: [Real; 3], joseph: bool) -> bool { let norm = sqrt(accel[0] * accel[0] + accel[1] * accel[1] + accel[2] * accel[2]); if f.accel_gate >= 0.0 && fabs(norm - G) > f.accel_gate { return false; } let c = f.q.dcm(); let h = [-c.m[2][0], -c.m[2][1], -c.m[2][2]]; let hm = skew(h); let r = (f.sa / G) * (f.sa / G); let mut p = f.p; let mut dx = [0.0; 6]; for j in 0..3 { let hj = [hm.m[j][0], hm.m[j][1], hm.m[j][2], 0.0, 0.0, 0.0]; let mut hdx = 0.0; for k in 0..6 { hdx += hj[k] * dx[k]; } let Some(dxj) = scalar_update(&mut p, &hj, r, accel[j] / norm - h[j] - hdx, joseph) else { return false; }; for k in 0..6 { dx[k] += dxj[k]; } } f.p = p; inject(f, &dx); true}
/// Heading-only magnetometer update with one scalar measurement.pub fn update_mag_heading_seq(f: &mut Eskf, mag: [Real; 3], joseph: bool) -> bool { let norm = sqrt(mag[0] * mag[0] + mag[1] * mag[1] + mag[2] * mag[2]); if f.mag_gate >= 0.0 && fabs(norm - 1.0) > f.mag_gate { return false; } let c = f.q.dcm(); let mw = |i: usize| c.m[i][0] * mag[0] + c.m[i][1] * mag[1] + c.m[i][2] * mag[2]; let y = wrap_pi(atan2(mw(1), mw(0)) - atan2(f.m_w[1], f.m_w[0])); let hj = f.heading_jacobian(); let h = [hj[0], hj[1], hj[2], 0.0, 0.0, 0.0]; let mh = sqrt(f.m_w[0] * f.m_w[0] + f.m_w[1] * f.m_w[1]); let mut p = f.p; let Some(dx) = scalar_update(&mut p, &h, (f.sm / mh) * (f.sm / mh), y, joseph) else { return false; }; f.p = p; inject(f, &dx); true}//! ESKF whose covariance lives in UD form: Thornton predict, Bierman scalar updates.//! No reset Jacobian (it would not preserve the factored form).#![allow(clippy::needless_range_loop)]
use crate::ekf_att::G;use crate::eskf::wrap_pi;use crate::mat::Mat;use crate::quat::{Quat, skew};use crate::real::{Real, atan2, fabs, sqrt};use crate::ud::{bierman_update, thornton_predict, ud_to_p};
pub struct EskfUd { pub q: Quat, pub b: [Real; 3], pub u: Mat<6, 6>, pub d: [Real; 6], sg: Real, sbw: Real, sa: Real, sm: Real, m_w: [Real; 3], /// Gates on | |f| - g | (m/s^2) and | |m| - 1 |; negative disables gating. accel_gate: Real, mag_gate: Real,}
impl EskfUd { #[allow(clippy::too_many_arguments)] pub fn new( q0: Quat, p0_diag: [Real; 6], sigma_g: Real, sigma_bw: Real, sigma_a: Real, sigma_m: Real, m_w: [Real; 3], accel_gate: Real, mag_gate: Real, ) -> Self { Self { q: q0, b: [0.0; 3], u: Mat::identity(), d: p0_diag, sg: sigma_g, sbw: sigma_bw, sa: sigma_a, sm: sigma_m, m_w, accel_gate, mag_gate, } }
/// The covariance P = U D U^T. pub fn p(&self) -> Mat<6, 6> { ud_to_p(&self.u, &self.d) }
pub fn predict(&mut self, gyro: [Real; 3], dt: Real) { let w = [ gyro[0] - self.b[0], gyro[1] - self.b[1], gyro[2] - self.b[2], ]; let dq = Quat::exp([w[0] * dt, w[1] * dt, w[2] * dt]); let ct = dq.dcm().transpose(); let mut f = Mat::<6, 6>::identity(); for i in 0..3 { for j in 0..3 { f.m[i][j] = ct.m[i][j]; } f.m[i][3 + i] = -dt; } let qd = [ self.sg * self.sg * (dt * dt), self.sg * self.sg * (dt * dt), self.sg * self.sg * (dt * dt), self.sbw * self.sbw * dt, self.sbw * self.sbw * dt, self.sbw * self.sbw * dt, ]; self.q = self.q * dq; thornton_predict(&mut self.u, &mut self.d, &f, &qd); }
fn inject(&mut self, dx: &[Real; 6]) { self.q = (self.q * Quat::exp([dx[0], dx[1], dx[2]])).normalized(); for i in 0..3 { self.b[i] += dx[3 + i]; } }
/// Three sequential Bierman updates at one linearization point. /// False when gated out. pub fn update_accel(&mut self, accel: [Real; 3]) -> bool { let norm = sqrt(accel[0] * accel[0] + accel[1] * accel[1] + accel[2] * accel[2]); if self.accel_gate >= 0.0 && fabs(norm - G) > self.accel_gate { return false; } let c = self.q.dcm(); let h = [-c.m[2][0], -c.m[2][1], -c.m[2][2]]; let hm = skew(h); let r = (self.sa / G) * (self.sa / G); let mut dx = [0.0; 6]; for j in 0..3 { let hj = [hm.m[j][0], hm.m[j][1], hm.m[j][2], 0.0, 0.0, 0.0]; let mut hdx = 0.0; for k in 0..6 { hdx += hj[k] * dx[k]; } let dxj = bierman_update( &mut self.u, &mut self.d, &hj, r, accel[j] / norm - h[j] - hdx, ); for k in 0..6 { dx[k] += dxj[k]; } } self.inject(&dx); true }
/// Heading-only magnetometer update. False when gated out. pub fn update_mag_heading(&mut self, mag: [Real; 3]) -> bool { let norm = sqrt(mag[0] * mag[0] + mag[1] * mag[1] + mag[2] * mag[2]); if self.mag_gate >= 0.0 && fabs(norm - 1.0) > self.mag_gate { return false; } let c = self.q.dcm(); let mw = |i: usize| c.m[i][0] * mag[0] + c.m[i][1] * mag[1] + c.m[i][2] * mag[2]; let y = wrap_pi(atan2(mw(1), mw(0)) - atan2(self.m_w[1], self.m_w[0])); // d heading / d dtheta = [mx mz, my mz, -(mx^2 + my^2)] / (mx^2 + my^2) C(q) let [mx, my, mz] = self.m_w; let mh2 = mx * mx + my * my; let row = [mx * mz / mh2, my * mz / mh2, -1.0]; let mut h = [0.0; 6]; for k in 0..3 { h[k] = row[0] * c.m[0][k] + row[1] * c.m[1][k] + row[2] * c.m[2][k]; } let r = (self.sm / sqrt(mh2)) * (self.sm / sqrt(mh2)); let dx = bierman_update(&mut self.u, &mut self.d, &h, r, y); self.inject(&dx); true }}ch08 的三个 app(c/apps/ch08.c、cpp/apps/ch08.cpp、rust/src/bin/ch08.rs)有三个子命令:run 写输出,sizes 打印结构体大小,bench 计时。
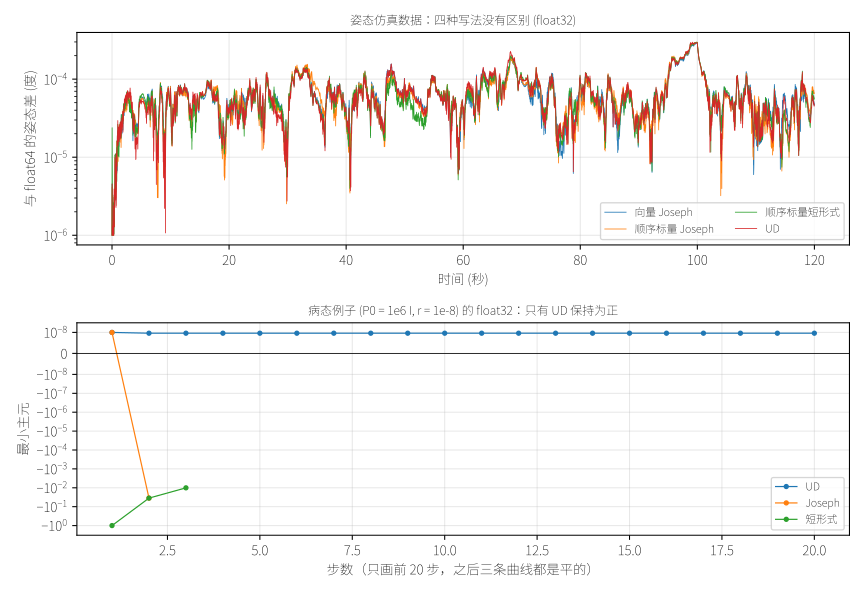
float32 下四种写法。 在姿态数据上,四种写法(向量 Joseph,顺序 Joseph,顺序短形式,UD)的 float32 输出和 float64 参考:
float32 covariance forms, ESKF without reset Jacobian (vs the float64 vector ESKF)variant lang max diff (deg) RMS (deg) min pmin steps pmin<=0v_vec C 2.890e-04 7.777e-05 6.68e-08 0v_vec C++ 2.761e-04 7.707e-05 6.68e-08 0v_vec Rust 2.906e-04 7.965e-05 6.68e-08 0v_seqj C 2.974e-04 7.794e-05 6.68e-08 0v_seqj C++ 2.856e-04 7.869e-05 6.68e-08 0v_seqj Rust 2.762e-04 7.717e-05 6.68e-08 0v_seqs C 2.982e-04 7.763e-05 6.68e-08 0v_seqs C++ 2.921e-04 7.866e-05 6.68e-08 0v_seqs Rust 2.771e-04 7.617e-05 6.68e-08 0v_ud C 2.976e-04 7.942e-05 6.68e-08 0v_ud C++ 3.042e-04 8.131e-05 6.68e-08 0v_ud Rust 2.890e-04 8.071e-05 6.68e-08 0四种写法在这份数据上没有任何可见的区别:最大姿态差都是 度, 的最小主元都是 ,没有一步是非正的。这份数据太温和了, 的动态范围很小。能把它们分出高下的是第 3 篇的病态例子(,,动态范围 )。
病态例子在 float32 下。 C、C++、Rust 的 float32 构建一致地崩溃:
ill-conditioned case (P0 = 1e6 I, r = 1e-8) in float32 C ill_joseph: min eig -3.526e+00, max |P01-P10| 0.000e+00, NaN rows 0, failed updates 998 C ill_short : min eig -1.989e+00, max |P01-P10| 2.154e-04, NaN rows 0, failed updates 997 C++ ill_joseph: min eig -3.526e+00, max |P01-P10| 0.000e+00, NaN rows 0, failed updates 998 C++ ill_short : min eig -1.989e+00, max |P01-P10| 2.154e-04, NaN rows 0, failed updates 997 Rust ill_joseph: min eig -3.526e+00, max |P01-P10| 0.000e+00, NaN rows 0, failed updates 998 Rust ill_short : min eig -1.989e+00, max |P01-P10| 2.154e-04, NaN rows 0, failed updates 9971000 步里 998 步(Joseph)和 997 步(短形式)的更新因为 不正定而失败, 的最小特征值是 和 。原因就在第二步: 从 经过更新应该变成 ,这个相消的量级是 ,float32 的相对精度是 ,绝对误差大约 0.06,结果成了 ,之后一切都乱了。
这和第 3 篇的 Python float32 不一致,那里 Joseph 形式几乎没事。我的解释如下,没有逐位验证:第 3 篇的 Python 是直接做除法求增益 ,那个例子的第二步所有中间量碰巧是整数(,,),舍入没有损失, 精确等于 0。C、C++、Rust 用的是 Cholesky 风格的增益 , 之后的两次除法在 float32 里不再精确,相消失败了。我在 numpy float32 里用同样的 Cholesky 风格增益重做了这个实验,并且换了两组不那么”整”的初值:
ill-conditioned case, Python numpy, Cholesky-style gain: steps with a non-positive pivot (smallest pivot) P0 sigma_v dtype UD Joseph short form 1e+06 1.00e-04 float64 0 ( 9.629e-09) 0 ( 9.630e-09) 0 ( 9.630e-09) 1e+06 1.00e-04 float32 0 ( 9.629e-09) 999 (-3.516e-02) 1000 (-1.000e+00) 1.234e+06 1.17e-04 float64 0 ( 1.301e-08) 0 ( 1.301e-08) 0 ( 1.301e-08) 1.234e+06 1.17e-04 float32 0 ( 1.301e-08) 0 ( 1.301e-08) 1 (-1.000e+00) 3.3e+05 9.00e-05 float64 0 ( 7.853e-09) 0 ( 7.854e-09) 0 ( 7.854e-09) 3.3e+05 9.00e-05 float32 0 ( 7.853e-09) 0 ( 7.854e-09) 1 (-1.000e+00)- UD 在三组初值、两种精度下,一步非正主元都没有,float32 下的最小主元和 float64 一致到 4 位有效数字( 对 )。
- Joseph 形式:第一组初值(整数)float32 下 999 步失败,复现了 C、C++、Rust 的崩溃;后两组(不整的初值)没有失败。
- 短形式:三组初值里,float32 下第一组 1000 步全失败,后两组各有 1 步(第一次更新)非正。
所以我的结论是:Joseph 形式在 float32 下不是”总是安全”,它依赖于具体问题的动态范围;短形式比它更脆弱;UD 在这三组条件里都是正的。三组不是证明,只是我试过的全部。如果你的 和 之间有 以上的动态范围,并且要在 float32 上跑,值得考虑 UD,或者干脆把 设小一点(初始不确定度设到 是我为了制造病态例子故意写的)。
内存
每个滤波器结构体(状态加协方差加参数,不含数据文件)的字节数:
sizeof / size_of of the filter state, bytesfilter c f64 c f32 cpp f64 cpp f32 rs f64 rs f32kf1d 40 20 40 20 40 20kf_2_1_1 416 248 168 84 168 84mahony 96 48 96 48 96 48ekf 2752 1376 512 256 512 256eskf 2472 1236 424 212 424 212eskf_ud 2512 1256 464 232 464 232ukf 4032 2016 424 212 424 212- Rust 和 C++ 的
size_of是 double 到 float 刚好减半:滤波器的状态全是标量。 - C 的数字大一个数量级:
kl_ekf_att2752 字节,kl_ukf_att4032 字节,原因是每个 C 结构体里有一块给joseph_update、predict用的内联工作区(work[...],几百个kl_real),C++ 和 Rust 的临时矩阵是栈上的局部变量,不出现在sizeof里。这未必说明 C 更浪费:C++ 和 Rust 的栈帧在调用时同样需要这些临时空间,我估计量级相近,区别只是它们在不在滤波器对象里。真正要关心的是最坏情况下总的 RAM 占用(对象加栈峰值),我没有测栈峰值。 kl_kf在 C 里只是一组指针(80 字节),表里的 416 字节是我把调用者持有的数组(x、P、F、B、H、Q、R、work)也加上。- 最大的 UKF 在 float32 下 C 版 2 KiB。一块有 64 KiB RAM 的 Cortex-M4 装得下全部。
在写这一节的时候我发现了一个 C 的越界 bug。 第 5 篇的 kl_ekf_att 的工作区我写成了 256 个元素,更新步骤用到 279 个。越界部分写进了紧挨着结构体的下一个变量。第 5 篇的 app 里碰巧没有踩到有用的东西,输出和 Python 对得上,所以测试通过了;第 8 篇的 app 把同一份库代码链接进另一个程序,邻居变成了一个全局常量,UD 滤波器的输出变成了 NaN。改成 280,并把这个数字的来由写在注释里,第 5 篇的正文也据此更新了。AddressSanitizer 和 UBSan 跑 C 的全部 app(ch01 到 ch08 的 run)都是干净的,但它们抓不到结构体内部成员之间的越界,这个 bug 是靠”输出突然是 NaN”发现的。C++ 和 Rust 的矩阵尺寸是类型的一部分,不会有这类问题。
没有堆分配:三个证明
== C: heap symbols referenced by the filter objects (everything except csv.o)ok: no malloc/calloc/realloc/free in 13 filter objects== C++: heap symbols in the compiled filters (-fno-exceptions -fno-rtti)ok: no operator new / malloc; undefined symbols are: U atan2 U atan2f U fmod U fmodf U hypot U hypotf U sincos U sincosf U sqrt U sqrtf U __stack_chk_fail== Rust: no_std build of the library (no alloc)ok: cargo build --lib --no-default-features --features f32- C: 对每个滤波器目标文件(
build/c/obj/下除了csv.o的 13 个)跑nm -u,不引用malloc、calloc、realloc、free。 - C++: 单独一个测试文件
cpp/tests/no_heap.cpp把所有滤波器各实例化一遍(double 和 float),用-fno-exceptions -fno-rtti编译,nm -C -u列出的未定义符号只有数学函数和栈保护__stack_chk_fail,没有operator new和malloc。 - Rust:
cargo build --lib --no-default-features --features f32成功。库是#![no_std],没有alloccrate,所以任何堆分配都会在编译时报错。
这三种检查的强度不同:C 和 C++ 是”当前编译出来的目标文件不引用堆函数”,编译器版本换了或者优化选项变了,结论要重测;Rust 的是”编译不过”,保证更强。
Cortex-M4F 上的代码体积
把 C 滤波器源码(除了 csv.c)按 float 编译成 Cortex-M4F 的目标文件,只编译不链接:
== Cortex-M4F code size of the C filters (float, -O2, compile only) text data bss dec hex filename 516 0 0 516 204 build/arm/kl_baselines.o 1840 0 0 1840 730 build/arm/kl_ekf_att.o 1620 0 0 1620 654 build/arm/kl_eskf.o 1356 0 0 1356 54c build/arm/kl_eskf_seq.o 1160 0 0 1160 488 build/arm/kl_eskf_ud.o 116 0 0 116 74 build/arm/kl_kf1d.o 1360 0 0 1360 550 build/arm/kl_kf.o 532 0 0 532 214 build/arm/kl_mahony.o 1140 0 0 1140 474 build/arm/kl_mat.o 1924 0 0 1924 784 build/arm/kl_quat.o 1424 0 0 1424 590 build/arm/kl_ud.o 2596 0 0 2596 a24 build/arm/kl_ukf_att.o 364 0 0 364 16c build/arm/kl_update.odouble-promotion warnings across all objects: 0distinct soft-double helper symbols (__aeabi_d*) referenced: 0./build/c/ch08 bench所有模块加起来 15948 字节(text),一个具体滤波器要它自己加上它依赖的几个:ESKF 是 kl_eskf(1620)加 kl_mat(1140)加 kl_quat(1924)加 kl_update(364)加 kl_ekf_att 里的 rot_inv(1840,我偷懒直接依赖了整个模块),约 7 KB;UKF 是 kl_ukf_att(2596)加同一批依赖,再加 kl_wrap_pi 所在的 kl_eskf(1620),在 9 到 10 KB 之间。链接的时候 -ffunction-sections -Wl,--gc-sections 会去掉没用到的函数。这些是目标文件的大小,没有链接 libm(sqrtf、atan2f、sincosf 的实现需要几 KB),也没有启动代码。
这个检查还抓到一个 bug:我第一次编译的时候,kl_eskf.o 引用了两个软件 double 的辅助函数(__aeabi_f2d 和 __aeabi_d2f,我的脚本一开始只搜 __aeabi_d*,所以当时数到的是 1 个)。原因是第 6 篇的 kl_wrap_pi 里我写的是 fmod,它是 double 的函数,float 构建里每次调用都要把 float 提升成 double 再降回来。在没有双精度硬件的 Cortex-M4F 上,这会拖进软件实现的 double fmod,既慢又大。改成 float 构建里用 fmodf 之后,脚本数到的软件 double 辅助函数引用变成 0,kl_eskf.o 小了 56 字节。-Wdouble-promotion 的警告数一直是 0,它没有抓到这一个,我没有深究为什么。这个教训我觉得值得单独记一笔:float 构建里一个函数名写错,不会报错,不会警告,只会让你的 MCU 变慢,检查办法是 nm -u 里搜 __aeabi_d。
每步耗时
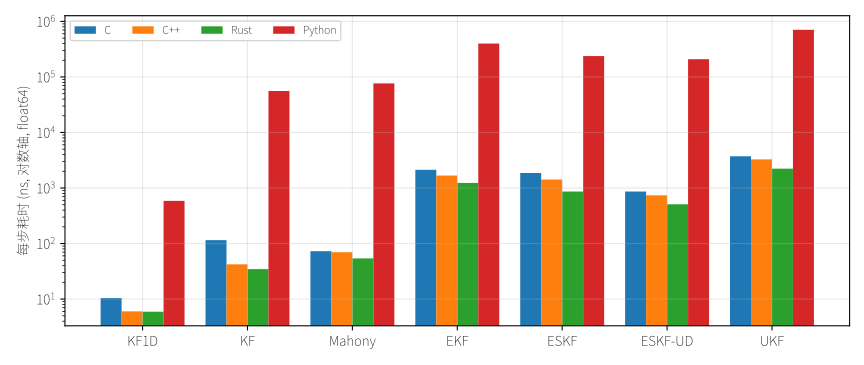
CPU:AMD Ryzen 7 PRO 6850U with Radeon Graphics。C、C++、Rust 各 100 次重复取中位数(每次重复处理整份数据),Python 因为太慢只取 3 到 5 次。不是 Cortex-M 的数字。
$ make ch08 # timing part of the reportfilter c f64 c f32 cpp f64 cpp f32 rs f64 rs f32 py f64 py/c f64KF1D 10 10 6 5 6 5 586 56KF 115 119 42 39 35 31 55807 485Mahony 73 70 70 80 54 47 76632 1053EKF 2131 2138 1677 1366 1235 1153 399979 188ESKF 1862 1787 1420 1029 865 931 237895 128ESKF-UD 864 807 738 620 510 473 208850 242UKF 3730 3680 3274 2715 2232 2088 706759 189单位是纳秒每步。几个观察:
- 最贵的 UKF 每步约 3730 ns(C,double),在 100 Hz 的循环里占 10 ms 预算的 0.037%。在这台机器上,滤波器的算力完全不是问题。
- ESKF 比 EKF 便宜(C 里 1862 对 2131 ns):状态少一维,协方差 对 。
- ESKF-UD 比 ESKF 便宜(864 对 1862 ns),比我预期的好得多:它每步只做 4 次标量更新,没有 Cholesky,没有 的矩阵乘法。我没有拿它去和 Joseph 形式的 ESKF 比”同样的算法”,两者在代码结构上差得太多,这个比较只能说明”UD + 标量更新”这条路在这台机器上没有慢。
- C 在多数滤波器上比 Rust 和 C++ 慢,这可能让人意外。我没有深究:C 版的矩阵库是运行期维度的循环加指针,Rust 和 C++ 的矩阵尺寸是编译期常量,编译器可以完全展开。这说明我的 C 版没有做任何性能上的调优,别拿它当 C 的上限。
- float32 在这台 x86 上并不更快:C 里 float32 和 float64 的耗时之比在 0.93 到 1.03 之间,几乎没变;C++ 在 0.72 到 1.14 之间,EKF、ESKF、UKF 快了 15% 到 30%;Rust 在 0.83 到 1.08 之间,有快有慢(ESKF 的 float32 反而慢了 8%)。x86 的 SSE 标量单精度和双精度的吞吐差不多。float32 的价值在没有双精度硬件的 MCU 上,不在这里。
- Python(numpy)比 C(float64)慢 59 到 1050 倍(按滤波器),最小的是 KF1D(59 倍),最大的是 Mahony(1050 倍),ESKF 是 128 倍。numpy 对 这样的小矩阵没有任何优势,调度开销压倒了计算。
推测,没有测量。 我没有 Cortex-M 的板子在手边,所以下面是外推,不是数据。Cortex-M4F 在 168 MHz,没有乱序执行,没有 SIMD,单精度浮点是单周期的 FMA 量级。我估计同一份代码在上面会比这台机器慢几十倍,大概 30 到 100 倍之间,这样 UKF 每步在 0.1 到 0.4 ms,占 10 ms 预算的 1% 到 4%;ESKF 在几十到一百多微秒。如果真是这个量级,100 Hz 的姿态估计在 M4F 上算力是有富余的,UKF 也是可行的,但请用你自己的板子量一遍再相信我。
移植清单
纯软件做到现在,剩下的问题都是接口和物理世界的问题:
- 回放接口。 在硬件上把原始传感器数据按
data/imu_seed*.csv的列格式(t,gx,gy,gz,ax,ay,az,mx,my,mz,后面的真值列可以是任意值,滤波器不读)记下来,原样拿回这个仓库里,用同一批 app 回放。这样你可以在笔记本上复现板子上的任何一个问题。 - 步长。 我所有的滤波器都用固定的 s。真实 MCU 上的定时器有抖动,要么用硬件定时器保证采样间隔固定,要么用测得的 (predict 里已经有
dt参数,只是 app 里没有用)。把 按 缩放的部分(第 2 篇的连续到离散)已经写对了。 - 时间戳对齐。 陀螺、加速度计、磁力计往往不是同一时刻采的,磁力计经常慢得多(我的仿真里三者同步 100 Hz)。可以把慢传感器的更新放在有新数据的时候做,其余时候只 predict;我的滤波器结构(predict 之后各自独立的 update)已经支持这样。
- 轴映射。 仿真里机体系是 FRD。真实的 IMU 芯片的轴向可能是 FLU、RFU,每个传感器还可能互相不一致(磁力计常常自己一套轴)。在数据进入滤波器之前,用一个常数旋转矩阵统一到 FRD,并用静止的数据检验:水平放置时加速度计读数应该是 。
- 加速度计、陀螺的偏置和比例因子。 陀螺零偏滤波器会估计,但初始值最好静止几秒测一下;加速度计的偏置和比例因子需要多姿态标定。
- 磁力计的硬铁和软铁标定。 见下。
- float 还是 double。 如果 MCU 有双精度 FPU(Cortex-M7 一部分型号),double 不是问题;只有单精度 FPU(M4F)的话,用 float32,并且按上一节检查有没有软件 double 辅助函数混进去。
硬铁偏置:一个演示
磁力计的硬铁偏置是个固定的偏移(板子上的永磁体和电流产生的磁场),在传感器自己的坐标系里不变。我给种子 1 的磁力计读数在机体系里加上 (场强是 1,所以是 20% 的偏置),跑第 6 篇的 ESKF:
hard-iron offset [0.2, 0, 0] in the body frame, ESKF, yaw error over the calm period [20,60) s no offset : yaw mean -0.04 deg, RMS 0.09 deg, total RMS 0.09 deg, gated mag samples 1000 of 12000 offset, |m| gate 0.1 : yaw mean -2.01 deg, RMS 7.95 deg, total RMS 7.92 deg, gated mag samples 4064 of 12000 offset, no gate : yaw mean -2.00 deg, RMS 8.46 deg, total RMS 8.42 deg, gated mag samples 0 of 12000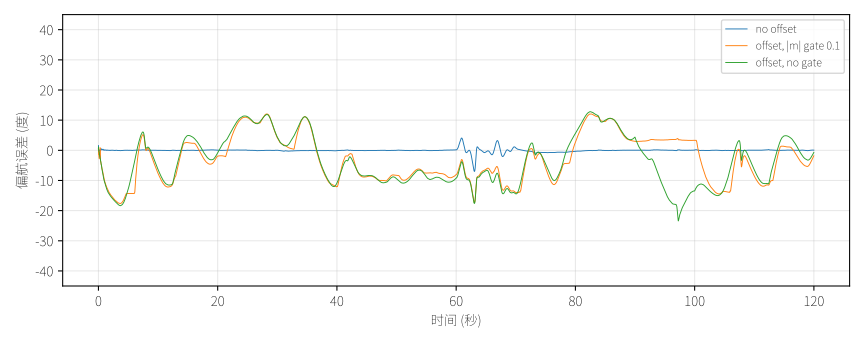
偏航误差从 0.09 度的均方根变成约 8 度,来回摆动,平均值只有 度,但是峰值超过 15 度:偏置是固定在机体上的,机体一转,它在世界系里的方向就转,偏航估计被拉着来回摆。模长门控这次没能帮上忙:被偏置污染以后,磁场模长在 0.8 到 1.2 之间随姿态变化,门控拒绝了 12000 个样本里的 4064 个(34%),剩下的样本仍然是错的,只是错得没有超出门限。门控是对”突发干扰”的检测,不是对”持续偏置”的检测。需要的是标定:转动传感器一圈,拟合出球心,减掉。
外推
回到我最初的目的:控制用的姿态估计。这条路的软件部分到这里做完了:公式有推导,代码有四种语言的实现,每一个数字有可以重跑的来源。真正有意思的部分接下来才开始,在硬件上:你会发现数据里有仿真器没有的东西(传感器延迟、非线性、温度漂移、振动),而你手里已经有一套可以复现每一个数字的工具来逐个对付它们。我会拿 ESKF 先上板子,原因很具体:它比 EKF 少一维、没有四元数协方差的幽灵方向,比 UKF 便宜,C 里大约 2.0 倍,而且在这份数据上,它的结果和 UKF 在三位小数内一样。
要做的第一件事,大概是把上面那个回放接口接上,把静止状态下的 IMU 噪声实测出来,然后把 GYRO_SIGMA、ACC_SIGMA 换成测得的值。第 3 篇的 NEES 检验到时候会用不上(没有真值),但新息自相关一直能用。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!