
 Better Mistakes



音乐
暂未播放
升到高维:多变量卡尔曼滤波的推导与实现
上一篇结尾那个带零偏的数据集,第 1 篇的滤波器在零偏面前几乎没有办法。这一篇把零偏放进状态里,换成二维的滤波器:同样的传感器、同样的噪声,在 6000 步的漂移零偏数据上,第 1 篇的一维滤波器角度 RMSE 是 2.541 度,二维的是 0.348 度,差了 7.3 倍。滤波器多了一个状态,没有多任何”调参”。
要做到这件事,第 1 篇的标量公式必须升级成矩阵公式。这一篇的任务就是推导这个升级,然后把它写成四种语言各一份的、不依赖任何矩阵库的代码。
这一篇结束时你会有:make ch02 通过,out/ch02/ 下有 tilt_bias_{py,c,cpp,rs}.csv 和 cv_{py,c,cpp,rs}.csv,figures/ch02/ 下有三张图;C、C++、Rust 各有一个手写的小矩阵库(kl_mat、mat.hpp、mat.rs)和一个泛型线性卡尔曼滤波器(kl_kf、kf.hpp、kf.rs),这些接口是定稿,后面的章节直接复用。
前置:第 1 篇。需要的数学:矩阵乘法、转置、对称正定矩阵、矩阵迹的求导。
数学
随机向量与协方差矩阵
把标量随机变量换成列向量 。它的均值是 ,方差换成协方差矩阵
是第 个分量的方差, 是分量 与 的协方差。 对称,半正定。多元高斯分布写成 ,概率密度是 乘以归一化常数。
等概率密度面是 ,在二维是一个椭圆。对 做特征分解 ,椭圆的轴沿着特征向量 的列方向,半轴长是 。后面所有”协方差”的图,画的都是 的椭圆(1、2、3 倍标准差)。
线性变换:预测步
设 , 的均值是 ,协方差是 。均值直接变换:。协方差:
是常数,不影响协方差。如果再加一个和 独立的噪声 ,协方差再加 。把状态方程 套进去,就是预测步:
和第 1 篇的 相比,只是 的特例。
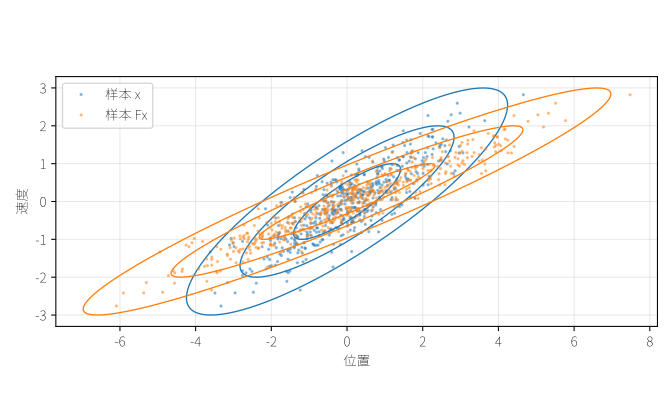
图里的 是匀速模型的 情形。不确定度椭圆被拉长了:位置的不确定度变大,因为速度不确定,位置会越推越不准。同时位置和速度的相关性(椭圆倾斜)也被保留下来,这正是下面更新步用得到的:测量了位置,就顺带修正了速度。
多元高斯的条件分布:更新步
状态 ,测量 , 与 独立。 和 联合是高斯,均值与协方差为
(协方差的非对角块:,因为 与 独立。)
我们要的是 。一般的多元高斯条件公式是:若 ,则
后者叫 的 Schur 补。这个公式有一个很短的证明,值得写出来。令 ,它和 的协方差是
联合高斯的两个变量如果不相关,则相互独立。于是 里,给定 之后只有第二项是确定的, 的分布不受 影响:条件均值是 ,条件协方差就是 ,展开
代入 ,,得到
最后一步用了 ,所以 。第 1 篇标量情形里 ,现在 、,是同一个式子。
第二个推导:让迹最小
另一条路,不用高斯假设,只假设更新是线性的:,问 取什么能让估计误差的总方差最小。先算这个估计的误差协方差。令 ,则
和 独立,所以
这就是 Joseph 形式。注意它对任意 都成立,没有用到最优性。最小化总方差 :用 ( 对称)和 ,展开后求导
和条件分布的推导得到同一个 。这个 代回去,因为 ,Joseph 形式化简成 。
两个推导给出的信息不一样:条件分布说明”在高斯假设下这是完整的后验”,迹最小化说明”即使噪声不是高斯,只要均值和协方差对,它是线性估计里最好的”。
为什么要用 Joseph 形式
化简出来的 更便宜,但它只有在 恰好是最优增益、没有舍入误差时才等于 Joseph 形式。有舍入误差时, 一般不再对称,也可能丢失正定性,协方差矩阵一旦有负特征值,滤波器就会发散。Joseph 形式是两个半正定矩阵之和( 与 ),对任何 都保持半正定,所以 有一点误差也不会出事。我再在 上显式做一次 ,把舍入造成的微小不对称消掉。第 3 篇会拿一个病态例子把两种写法并排跑一遍。
不要求逆:Cholesky
公式里有 。直接求逆既慢又不稳。 对称正定,可以分解成 , 是下三角。要算的是 (因为 对称, 的转置恰好是它),解线性方程组 :先前向代入解 ,再后向代入解 ,不需要求逆。
Cholesky 还附带一个好处:分解过程中某个主元不是正数,就说明 不是正定的,数值上已经出了问题,这是个免费的健康检查。我的实现在这种情况下返回错误并保持状态不变。
从连续到离散:过程噪声
怎么确定 ?物理模型通常是连续时间的:, 是功率谱密度为 的白噪声。离散化之后,一步的过程噪声协方差是
直觉:时刻 注入的噪声,会被系统动力学 带着传播到这一步结束,把所有时刻的贡献加起来。积分变量换成”距离步末的时间”,就是上面的形式。
白噪声加速度(匀速模型)。 一个轴,,,, 的谱密度为 。,,,所以 :
角度加零偏。 状态 。陀螺读数 ,所以 ,。 当控制输入,噪声向量 的谱密度是 ,,,,:
这里的 是谱密度,不是第 1 篇里的每样本标准差。第 1 篇每个样本的陀螺噪声 rad/s,离散化后每步角度噪声的方差是 ,要让 等于它,。零偏的随机游走用 rad/s/,一秒内零偏的标准差漂移 0.001 rad/s。
Python 实现
模型与仿真
模型矩阵和两个仿真器都在 python/kl/models.py:
"""Model matrices and simulators for the linear examples (chapters 2 and 3)."""
from pathlib import Path
import numpy as np
from .io import write_csv
ROOT = Path(__file__).resolve().parents[2]
def tilt_bias_model(dt, gyro_sigma, bias_rw_sigma, meas_sigma): """x = [theta, b], u = omega_m, z = theta + v.
gyro_sigma is the per-sample gyro noise std (rad/s), as in chapter 1, so its continuous white-noise PSD is gyro_sigma^2 * dt. bias_rw_sigma is in rad/s/sqrt(s). """ F = np.array([[1.0, -dt], [0.0, 1.0]]) B = np.array([[dt], [0.0]]) H = np.array([[1.0, 0.0]]) qg = gyro_sigma**2 * dt qb = bias_rw_sigma**2 Q = np.array( [ [qg * dt + qb * dt**3 / 3, -qb * dt**2 / 2], [-qb * dt**2 / 2, qb * dt], ] ) R = np.array([[meas_sigma**2]]) return F, B, H, Q, R
def cv2d_model(dt, qc, meas_sigma): """x = [px, py, vx, vy], position measurements, white-noise acceleration PSD qc.""" I2, Z2 = np.eye(2), np.zeros((2, 2)) F = np.block([[I2, dt * I2], [Z2, I2]]) H = np.block([[I2, Z2]]) Q = qc * np.block( [[dt**3 / 3 * I2, dt**2 / 2 * I2], [dt**2 / 2 * I2, dt * I2]] ) R = meas_sigma**2 * I2 return F, None, H, Q, Rtilt_bias_model 里的 Q 就是上面积分的结果,qg = gyro_sigma**2 * dt 完成了每样本标准差到谱密度的换算。cv2d_model 里 是两个轴共享同一个 块,状态顺序是 ,所以块结构是 [[a I, b I], [b I, c I]]。cv2d_model 返回 B = None:这个模型没有控制输入。
仿真器:
def simulate_tilt_bias(seed, n=6000, dt=0.01, gyro_sigma=0.05, meas_sigma=0.05, bias0=0.05, bias_rw_sigma=1e-3, write=True, gyro_avg=True): rng = np.random.default_rng(seed) t = np.arange(n) * dt w = 2 * np.pi * 0.25 theta = 0.5 * np.sin(w * t) if gyro_avg: # the gyro reports the rate averaged over the sample interval, which is exactly # what the filter's discrete model theta_k = theta_{k-1} + dt * rate assumes omega = (theta - 0.5 * np.sin(w * (t - dt))) / dt else: omega = 0.5 * w * np.cos(w * t) # instantaneous rate at the sample time bias = bias0 + np.concatenate(([0.0], np.cumsum(bias_rw_sigma * np.sqrt(dt) * rng.standard_normal(n - 1)))) omega_m = omega + bias + gyro_sigma * rng.standard_normal(n) z = theta + meas_sigma * rng.standard_normal(n) cols = {"t": t, "omega_m": omega_m, "z": z, "theta": theta, "bias": bias} if write: write_csv(ROOT / "data" / f"ch02_tilt_bias_seed{seed}.csv", cols) return cols
def simulate_cv(seed, n=200, dt=0.1, qc=0.1, meas_sigma=1.0, write=True): rng = np.random.default_rng(seed) F, _, H, Q, R = cv2d_model(dt, qc, meas_sigma) L = np.linalg.cholesky(Q) x = np.array([0.0, 0.0, 1.0, 0.5]) truth = np.empty((n, 4)) for k in range(n): truth[k] = x x = F @ x + L @ rng.standard_normal(4) z = truth[:, :2] + meas_sigma * rng.standard_normal((n, 2)) cols = { "t": np.arange(n) * dt, "zx": z[:, 0], "zy": z[:, 1], "px": truth[:, 0], "py": truth[:, 1], "vx": truth[:, 2], "vy": truth[:, 3], } if write: write_csv(ROOT / "data" / f"ch02_cv_seed{seed}.csv", cols) return cols角度加零偏的数据(这里有一个细节,我踩过一次,第 3 篇会讲):陀螺仪报告的是采样区间内的平均角速度,也就是 ,这恰好是滤波器的离散模型 假设的东西。同样的 真值, s 步长,6000 步(60 秒),零偏从 0.05 rad/s 起步做随机游走,种子 1。匀速模型的真值是从离散过程里直接采样出来的:,,用 的 Cholesky 因子 采样 ,。起点 ,速度 m/s, s,200 步,位置测量噪声 1 m。
滤波器
"""Generic linear Kalman filter (predict / update), Joseph form, Cholesky solve."""
import numpy as npfrom scipy.linalg import cho_factor, cho_solve
class KalmanFilter: """x- = F x + B u, P- = F P F' + Q; K = P- H' S^-1, S = H P- H' + R."""
def __init__(self, F, B, H, Q, R, x0, P0): self.F = np.asarray(F, dtype=float) n = self.F.shape[0] self.B = np.zeros((n, 0)) if B is None else np.asarray(B, dtype=float) self.H = np.asarray(H, dtype=float) self.Q = np.asarray(Q, dtype=float) self.R = np.asarray(R, dtype=float) self.x = np.asarray(x0, dtype=float).copy() self.P = np.asarray(P0, dtype=float).copy()
def predict(self, u=None): self.x = self.F @ self.x if u is not None and self.B.shape[1]: self.x = self.x + self.B @ np.atleast_1d(u) self.P = self.F @ self.P @ self.F.T + self.Q
def update(self, z, joseph=True): """Returns (y, S): innovation and its covariance. Raises LinAlgError if S is not SPD.""" z = np.atleast_1d(z) n = self.x.shape[0] y = z - self.H @ self.x S = self.H @ self.P @ self.H.T + self.R c = cho_factor(S, lower=True) # raises LinAlgError when not positive definite # S K' = H P- (P- symmetric) => K' = S^-1 H P- K = cho_solve(c, self.H @ self.P).T self.x = self.x + K @ y A = np.eye(n) - K @ self.H if joseph: self.P = A @ self.P @ A.T + K @ self.R @ K.T self.P = 0.5 * (self.P + self.P.T) else: self.P = A @ self.P return y, S
def nis(y, S): """Normalized innovation squared y' S^-1 y via Cholesky.""" c = cho_factor(np.atleast_2d(S), lower=True) return float(y @ cho_solve(c, y))predict 和 update 几乎是公式的逐行翻译。有几处值得点出:
B允许为空,用一个 的矩阵表示,这样无控制输入的模型(匀速)和有控制输入的模型(角度加零偏)走同一份代码。cho_factor(S, lower=True)在 不正定时抛LinAlgError,这就是上面说的”免费健康检查”。cho_solve(c, self.H @ self.P)解的是 ,。update返回(y, S),让调用者可以算 NIS (第 3 篇的主角)。
跑两个模型
两个模型用同一个类,只是传入的矩阵不同。角度加零偏:
def run_tilt(d): F, B, H, Q, R = tilt_bias_model(DT, SG, SBW, SV) kf = KalmanFilter(F, B, H, Q, R, np.zeros(2), TILT_P0) n = len(d["t"]) o = {k: np.empty(n) for k in ("theta", "bias", "P00", "P01", "P11", "nis")} for i in range(n): kf.predict(d["omega_m"][i]) y, S = kf.update(d["z"][i]) o["theta"][i], o["bias"][i] = kf.x o["P00"][i], o["P01"][i], o["P11"][i] = kf.P[0, 0], kf.P[0, 1], kf.P[1, 1] o["nis"][i] = nis(y, S) return {"t": d["t"], **o}初值 ,(角度很不确定,零偏标准差 0.1 rad/s 的先验)。每一步 predict(omega_m) 然后 update(z)。
C、C++、Rust 实现
三份实现共享两层结构:一个小矩阵库(乘、加、减、转置、Cholesky、Cholesky 求解),和一个建立在它上面的滤波器。
- 内存。 C:滤波器
kl_kf只持有指针,所有数组(x、P、F…)和一块工作区由调用者提供,库里没有malloc。工作区长度用宏KL_KF_WORK_LEN(n, m)给出,等于update实际用到的元素个数。C++ 和 Rust:矩阵是编译期定尺寸的值类型(std::array或[[Real; C]; R]),放在栈上,没有工作区的概念,临时矩阵由编译器管理。 - 尺寸。 C 的维度是运行期的
int参数,写错了编译器不管;C++ 和 Rust 的维度是模板/const 泛型参数,Mat<2,1> * Mat<2,2>根本编译不过。代价是代码膨胀:每种尺寸组合实例化一份。 - 标量类型。
kl_real/ 模板参数T/Real,第 8 篇会用到。 - 错误。 Cholesky 失败:C 返回
-1,C++ 返回false,Rust 返回Result<(), CholeskyError>。三者都保证失败时状态不变。
C
C 的矩阵库全是平坦的行主序数组加显式维度。声明如下,完整实现放在后面折叠里:
/* Small dense matrices: row-major kl_real arrays with explicit dimensions. * Output buffers must not alias input buffers (except for the in-place routines). */#ifndef KL_MAT_H#define KL_MAT_H
#include "kl/kl_real.h"
/* C = A B; A is n x m, B is m x p, C is n x p. */void kl_mat_mul(const kl_real *A, const kl_real *B, kl_real *C, int n, int m, int p);/* C = A B^T; A is n x m, B is p x m, C is n x p. */void kl_mat_mul_bt(const kl_real *A, const kl_real *B, kl_real *C, int n, int m, int p);/* C = A + B and C = A - B; all n x m. */void kl_mat_add(const kl_real *A, const kl_real *B, kl_real *C, int n, int m);void kl_mat_sub(const kl_real *A, const kl_real *B, kl_real *C, int n, int m);/* C = s A; both n x m. */void kl_mat_scale(const kl_real *A, kl_real s, kl_real *C, int n, int m);/* C = A^T; A is n x m, C is m x n. */void kl_mat_transpose(const kl_real *A, kl_real *C, int n, int m);/* A = I (n x n). */void kl_mat_identity(kl_real *A, int n);/* C = A; both n x m. */void kl_mat_copy(const kl_real *A, kl_real *C, int n, int m);/* A = (A + A^T) / 2 in place; A is n x n. */void kl_mat_symmetrize(kl_real *A, int n);
/* In-place lower Cholesky A = L L^T for symmetric positive definite A (n x n). * Only the lower triangle of A is read; on success it holds L and the strict upper * triangle is zeroed. Returns 0 on success, -1 if a pivot is <= 0 (A is then garbage). */int kl_chol(kl_real *A, int n);/* Solves (L L^T) X = B in place. L is the n x n factor from kl_chol (lower triangle used), * B is n x ncols and is overwritten with X. */void kl_chol_solve(const kl_real *L, kl_real *B, int n, int ncols);
#endif约定输出不与输入别名,所以 kl_mat_mul(A, B, C, ...) 里的 C 必须是另一块内存。这是 C 里最容易写错的地方,也是 kl_kf_update 里有大量临时数组的原因。kl_mat_mul_bt 专门算 ,免得为了转置多拷一份。
滤波器:
/* Generic linear Kalman filter. The caller owns every buffer (the library never allocates). * All matrices are row-major: x n, P n x n, F n x n, B n x p, H m x n, Q n x n, R m x m. */#ifndef KL_KF_H#define KL_KF_H
#include "kl/kl_real.h"
/* Workspace (kl_real count) used by kl_kf_update, laid out in this order: * y m | S m*m | L m*m | HP m*n | Kt m*n | K n*m | A n*n | T n*n | U n*n | KR n*m * (kl_kf_predict only needs a prefix of the same buffer). */#define KL_KF_WORK_LEN(n, m) ((m) + 2 * (m) * (m) + 4 * (m) * (n) + 3 * (n) * (n))
typedef struct { int n, m, p; /* state, measurement, control dimensions (p may be 0) */ kl_real *x, *P, *F, *B, *H, *Q, *R; kl_real *work; /* KL_KF_WORK_LEN(n, m) entries */} kl_kf;
/* x = F x + B u, P = F P F^T + Q. u may be NULL when p == 0. */void kl_kf_predict(kl_kf *kf, const kl_real *u);
/* Joseph-form update. y = z - H x, S = H P H^T + R, K^T = S^-1 (H P) by Cholesky, * x += K y, P = A P A^T + K R K^T with A = I - K H, then P is symmetrized. * Returns -1 if S is not positive definite (x and P are left unchanged), else 0. * y_out (m) and S_out (m x m) receive the innovation and its covariance; either may be NULL. */int kl_kf_update(kl_kf *kf, const kl_real *z, kl_real *y_out, kl_real *S_out);
/* Same as kl_kf_update but with the textbook short form P = (I - K H) P: * no Joseph terms and no symmetrization. Same failure behavior and workspace. */int kl_kf_update_short(kl_kf *kf, const kl_real *z, kl_real *y_out, kl_real *S_out);
/* Workspace (kl_real count) for kl_kf_steady_gain: * P n*n | T n*n | U n*n | V n*n | S m*m | L m*m | HP m*n | Kt m*n | K n*m */#define KL_STEADY_WORK_LEN(n, m) (4 * (n) * (n) + 2 * (m) * (m) + 3 * (m) * (n))
/* Iterates the Riccati recursion P <- F (P - K H P) F^T + Q from P = Q until * max|dP| <= tol * max|P|, then returns the gain K (n x m) and prior covariance P_out (n x n, * may be NULL) at convergence. Returns -1 if it does not converge or S is not SPD. */int kl_kf_steady_gain(const kl_real *F, const kl_real *H, const kl_real *Q, const kl_real *R, int n, int m, kl_real tol, int max_iter, kl_real *K_out, kl_real *P_out, kl_real *work);
#endif预测与更新的实现:
void kl_kf_predict(kl_kf *kf, const kl_real *u){ int n = kf->n; kl_real *fx = kf->work; /* n */ kl_real *fp = fx + n; /* n*n */ kl_real *fpft = fp + n * n; /* n*n */
kl_mat_mul(kf->F, kf->x, fx, n, n, 1); if (kf->p > 0) { kl_real *bu = fpft + n * n; /* n */ kl_mat_mul(kf->B, u, bu, n, kf->p, 1); kl_mat_add(fx, bu, kf->x, n, 1); } else { kl_mat_copy(fx, kf->x, n, 1); }
kl_mat_mul(kf->F, kf->P, fp, n, n, n); kl_mat_mul_bt(fp, kf->F, fpft, n, n, n); kl_mat_add(fpft, kf->Q, kf->P, n, n);}
/* Shared by both update forms: y, S, K^T = S^-1 H P by Cholesky, then x += K y. * Returns -1 before touching x on failure. K ends up at the workspace offset used below. */static int kf_gain_and_state(kl_kf *kf, const kl_real *z, kl_real *y_out, kl_real *S_out){ int n = kf->n, m = kf->m; kl_real *y = kf->work; kl_real *S = y + m; kl_real *L = S + m * m; kl_real *HP = L + m * m; kl_real *Kt = HP + m * n; kl_real *K = Kt + m * n; kl_real *T = K + n * m + n * n; /* skips A */ kl_real *U = T + n * n;
/* y = z - H x */ kl_mat_mul(kf->H, kf->x, S, m, n, 1); /* S is scratch here */ kl_mat_sub(z, S, y, m, 1);
/* S = H P H^T + R */ kl_mat_mul(kf->H, kf->P, HP, m, n, n); kl_mat_mul_bt(HP, kf->H, L, m, n, m); /* L is scratch until the copy below */ kl_mat_add(L, kf->R, S, m, m);
/* K^T = S^-1 H P, so K never needs an explicit inverse */ kl_mat_copy(S, L, m, m); if (kl_chol(L, m) != 0) return -1; kl_mat_copy(HP, Kt, m, n); kl_chol_solve(L, Kt, m, n); kl_mat_transpose(Kt, K, m, n);
if (y_out) kl_mat_copy(y, y_out, m, 1); if (S_out) kl_mat_copy(S, S_out, m, m);
/* x += K y */ kl_mat_mul(K, y, T, n, m, 1); kl_mat_add(kf->x, T, U, n, 1); kl_mat_copy(U, kf->x, n, 1); return 0;}
int kl_kf_update(kl_kf *kf, const kl_real *z, kl_real *y_out, kl_real *S_out){ int n = kf->n, m = kf->m; if (kf_gain_and_state(kf, z, y_out, S_out) != 0) return -1; kl_real *K = kf->work + m + 2 * m * m + 2 * m * n; kl_real *A = K + n * m; kl_real *T = A + n * n; kl_real *U = T + n * n; kl_real *KR = U + n * n;
/* Joseph form: P = A P A^T + K R K^T, A = I - K H */ kl_mat_mul(K, kf->H, T, n, m, n); kl_mat_identity(U, n); kl_mat_sub(U, T, A, n, n); kl_mat_mul(A, kf->P, T, n, n, n); kl_mat_mul_bt(T, A, U, n, n, n); kl_mat_mul(K, kf->R, KR, n, m, m); kl_mat_mul_bt(KR, K, T, n, m, n); kl_mat_add(U, T, kf->P, n, n); kl_mat_symmetrize(kf->P, n); return 0;}kf_gain_and_state 负责 、、Cholesky、 和 ,kl_kf_update 在它后面接 Joseph 形式。把共同部分拆出来,是因为第 3 篇要在同一个文件里加一个 kl_kf_update_short,它和 update 只在协方差那几行不同。work 被切成互不重叠的子数组,布局写在 kl_kf.h 的注释里;S 和 L 在算 的过程中兼作临时空间,这是 C 版为了省内存做的小把戏,也是它比另外两个版本难读的原因。ch02.c 里的使用方式如下,所有存储都在栈上:
const double dt = TILT_DT, qg = SG * SG * dt, qb = SBW * SBW; kl_real x[2] = {0, 0}; kl_real P[4] = {1, 0, 0, 0.01}; kl_real F[4] = {1, (kl_real)-dt, 0, 1}; kl_real B[2] = {(kl_real)dt, 0}; kl_real H[2] = {1, 0}; kl_real Q[4] = {(kl_real)(qg * dt + qb * dt * dt * dt / 3), (kl_real)(-qb * dt * dt / 2), (kl_real)(-qb * dt * dt / 2), (kl_real)(qb * dt)}; kl_real R[1] = {(kl_real)(SV * SV)}; kl_real work[KL_KF_WORK_LEN(2, 1)]; kl_kf kf = {2, 1, 1, x, P, F, B, H, Q, R, work};完整源码:c/src/kl_mat.c
#include "kl/kl_mat.h"
void kl_mat_mul(const kl_real *A, const kl_real *B, kl_real *C, int n, int m, int p){ for (int i = 0; i < n; i++) for (int j = 0; j < p; j++) { kl_real s = 0; for (int k = 0; k < m; k++) s += A[i * m + k] * B[k * p + j]; C[i * p + j] = s; }}
void kl_mat_mul_bt(const kl_real *A, const kl_real *B, kl_real *C, int n, int m, int p){ for (int i = 0; i < n; i++) for (int j = 0; j < p; j++) { kl_real s = 0; for (int k = 0; k < m; k++) s += A[i * m + k] * B[j * m + k]; C[i * p + j] = s; }}
void kl_mat_add(const kl_real *A, const kl_real *B, kl_real *C, int n, int m){ for (int i = 0; i < n * m; i++) C[i] = A[i] + B[i];}
void kl_mat_sub(const kl_real *A, const kl_real *B, kl_real *C, int n, int m){ for (int i = 0; i < n * m; i++) C[i] = A[i] - B[i];}
void kl_mat_scale(const kl_real *A, kl_real s, kl_real *C, int n, int m){ for (int i = 0; i < n * m; i++) C[i] = s * A[i];}
void kl_mat_transpose(const kl_real *A, kl_real *C, int n, int m){ for (int i = 0; i < n; i++) for (int j = 0; j < m; j++) C[j * n + i] = A[i * m + j];}
void kl_mat_identity(kl_real *A, int n){ for (int i = 0; i < n; i++) for (int j = 0; j < n; j++) A[i * n + j] = (i == j) ? 1 : 0;}
void kl_mat_copy(const kl_real *A, kl_real *C, int n, int m){ for (int i = 0; i < n * m; i++) C[i] = A[i];}
void kl_mat_symmetrize(kl_real *A, int n){ for (int i = 0; i < n; i++) for (int j = i + 1; j < n; j++) { kl_real a = (kl_real)0.5 * (A[i * n + j] + A[j * n + i]); A[i * n + j] = a; A[j * n + i] = a; }}
int kl_chol(kl_real *A, int n){ for (int j = 0; j < n; j++) { kl_real d = A[j * n + j]; for (int k = 0; k < j; k++) d -= A[j * n + k] * A[j * n + k]; if (!(d > 0)) /* also catches NaN */ return -1; d = KL_SQRT(d); A[j * n + j] = d; for (int i = j + 1; i < n; i++) { kl_real s = A[i * n + j]; for (int k = 0; k < j; k++) s -= A[i * n + k] * A[j * n + k]; A[i * n + j] = s / d; } for (int i = 0; i < j; i++) A[i * n + j] = 0; } return 0;}
void kl_chol_solve(const kl_real *L, kl_real *B, int n, int ncols){ for (int c = 0; c < ncols; c++) { /* forward: L z = b */ for (int i = 0; i < n; i++) { kl_real s = B[i * ncols + c]; for (int k = 0; k < i; k++) s -= L[i * n + k] * B[k * ncols + c]; B[i * ncols + c] = s / L[i * n + i]; } /* backward: L^T x = z */ for (int i = n - 1; i >= 0; i--) { kl_real s = B[i * ncols + c]; for (int k = i + 1; k < n; k++) s -= L[k * n + i] * B[k * ncols + c]; B[i * ncols + c] = s / L[i * n + i]; } }}完整源码:c/include/kl/kl_kf.h、c/src/kl_kf.c(文件里还有第 3 篇才讲的 `update_short` 和稳态增益)
/* Generic linear Kalman filter. The caller owns every buffer (the library never allocates). * All matrices are row-major: x n, P n x n, F n x n, B n x p, H m x n, Q n x n, R m x m. */#ifndef KL_KF_H#define KL_KF_H
#include "kl/kl_real.h"
/* Workspace (kl_real count) used by kl_kf_update, laid out in this order: * y m | S m*m | L m*m | HP m*n | Kt m*n | K n*m | A n*n | T n*n | U n*n | KR n*m * (kl_kf_predict only needs a prefix of the same buffer). */#define KL_KF_WORK_LEN(n, m) ((m) + 2 * (m) * (m) + 4 * (m) * (n) + 3 * (n) * (n))
typedef struct { int n, m, p; /* state, measurement, control dimensions (p may be 0) */ kl_real *x, *P, *F, *B, *H, *Q, *R; kl_real *work; /* KL_KF_WORK_LEN(n, m) entries */} kl_kf;
/* x = F x + B u, P = F P F^T + Q. u may be NULL when p == 0. */void kl_kf_predict(kl_kf *kf, const kl_real *u);
/* Joseph-form update. y = z - H x, S = H P H^T + R, K^T = S^-1 (H P) by Cholesky, * x += K y, P = A P A^T + K R K^T with A = I - K H, then P is symmetrized. * Returns -1 if S is not positive definite (x and P are left unchanged), else 0. * y_out (m) and S_out (m x m) receive the innovation and its covariance; either may be NULL. */int kl_kf_update(kl_kf *kf, const kl_real *z, kl_real *y_out, kl_real *S_out);
/* Same as kl_kf_update but with the textbook short form P = (I - K H) P: * no Joseph terms and no symmetrization. Same failure behavior and workspace. */int kl_kf_update_short(kl_kf *kf, const kl_real *z, kl_real *y_out, kl_real *S_out);
/* Workspace (kl_real count) for kl_kf_steady_gain: * P n*n | T n*n | U n*n | V n*n | S m*m | L m*m | HP m*n | Kt m*n | K n*m */#define KL_STEADY_WORK_LEN(n, m) (4 * (n) * (n) + 2 * (m) * (m) + 3 * (m) * (n))
/* Iterates the Riccati recursion P <- F (P - K H P) F^T + Q from P = Q until * max|dP| <= tol * max|P|, then returns the gain K (n x m) and prior covariance P_out (n x n, * may be NULL) at convergence. Returns -1 if it does not converge or S is not SPD. */int kl_kf_steady_gain(const kl_real *F, const kl_real *H, const kl_real *Q, const kl_real *R, int n, int m, kl_real tol, int max_iter, kl_real *K_out, kl_real *P_out, kl_real *work);
#endif#include "kl/kl_kf.h"
#include "kl/kl_mat.h"
void kl_kf_predict(kl_kf *kf, const kl_real *u){ int n = kf->n; kl_real *fx = kf->work; /* n */ kl_real *fp = fx + n; /* n*n */ kl_real *fpft = fp + n * n; /* n*n */
kl_mat_mul(kf->F, kf->x, fx, n, n, 1); if (kf->p > 0) { kl_real *bu = fpft + n * n; /* n */ kl_mat_mul(kf->B, u, bu, n, kf->p, 1); kl_mat_add(fx, bu, kf->x, n, 1); } else { kl_mat_copy(fx, kf->x, n, 1); }
kl_mat_mul(kf->F, kf->P, fp, n, n, n); kl_mat_mul_bt(fp, kf->F, fpft, n, n, n); kl_mat_add(fpft, kf->Q, kf->P, n, n);}
/* Shared by both update forms: y, S, K^T = S^-1 H P by Cholesky, then x += K y. * Returns -1 before touching x on failure. K ends up at the workspace offset used below. */static int kf_gain_and_state(kl_kf *kf, const kl_real *z, kl_real *y_out, kl_real *S_out){ int n = kf->n, m = kf->m; kl_real *y = kf->work; kl_real *S = y + m; kl_real *L = S + m * m; kl_real *HP = L + m * m; kl_real *Kt = HP + m * n; kl_real *K = Kt + m * n; kl_real *T = K + n * m + n * n; /* skips A */ kl_real *U = T + n * n;
/* y = z - H x */ kl_mat_mul(kf->H, kf->x, S, m, n, 1); /* S is scratch here */ kl_mat_sub(z, S, y, m, 1);
/* S = H P H^T + R */ kl_mat_mul(kf->H, kf->P, HP, m, n, n); kl_mat_mul_bt(HP, kf->H, L, m, n, m); /* L is scratch until the copy below */ kl_mat_add(L, kf->R, S, m, m);
/* K^T = S^-1 H P, so K never needs an explicit inverse */ kl_mat_copy(S, L, m, m); if (kl_chol(L, m) != 0) return -1; kl_mat_copy(HP, Kt, m, n); kl_chol_solve(L, Kt, m, n); kl_mat_transpose(Kt, K, m, n);
if (y_out) kl_mat_copy(y, y_out, m, 1); if (S_out) kl_mat_copy(S, S_out, m, m);
/* x += K y */ kl_mat_mul(K, y, T, n, m, 1); kl_mat_add(kf->x, T, U, n, 1); kl_mat_copy(U, kf->x, n, 1); return 0;}
int kl_kf_update(kl_kf *kf, const kl_real *z, kl_real *y_out, kl_real *S_out){ int n = kf->n, m = kf->m; if (kf_gain_and_state(kf, z, y_out, S_out) != 0) return -1; kl_real *K = kf->work + m + 2 * m * m + 2 * m * n; kl_real *A = K + n * m; kl_real *T = A + n * n; kl_real *U = T + n * n; kl_real *KR = U + n * n;
/* Joseph form: P = A P A^T + K R K^T, A = I - K H */ kl_mat_mul(K, kf->H, T, n, m, n); kl_mat_identity(U, n); kl_mat_sub(U, T, A, n, n); kl_mat_mul(A, kf->P, T, n, n, n); kl_mat_mul_bt(T, A, U, n, n, n); kl_mat_mul(K, kf->R, KR, n, m, m); kl_mat_mul_bt(KR, K, T, n, m, n); kl_mat_add(U, T, kf->P, n, n); kl_mat_symmetrize(kf->P, n); return 0;}
int kl_kf_update_short(kl_kf *kf, const kl_real *z, kl_real *y_out, kl_real *S_out){ int n = kf->n, m = kf->m; if (kf_gain_and_state(kf, z, y_out, S_out) != 0) return -1; kl_real *K = kf->work + m + 2 * m * m + 2 * m * n; kl_real *A = K + n * m; kl_real *T = A + n * n; kl_real *U = T + n * n;
/* Short form: P = (I - K H) P, no symmetrization */ kl_mat_mul(K, kf->H, T, n, m, n); kl_mat_identity(U, n); kl_mat_sub(U, T, A, n, n); kl_mat_mul(A, kf->P, T, n, n, n); kl_mat_copy(T, kf->P, n, n); return 0;}
/* S = H P H^T + R and K^T = S^-1 H P for the given P; K is n x m. Returns -1 if S is not SPD. */static int riccati_gain(const kl_real *H, const kl_real *R, const kl_real *P, int n, int m, kl_real *S, kl_real *L, kl_real *HP, kl_real *Kt, kl_real *K){ kl_mat_mul(H, P, HP, m, n, n); kl_mat_mul_bt(HP, H, L, m, n, m); kl_mat_add(L, R, S, m, m); kl_mat_copy(S, L, m, m); if (kl_chol(L, m) != 0) return -1; kl_mat_copy(HP, Kt, m, n); kl_chol_solve(L, Kt, m, n); kl_mat_transpose(Kt, K, m, n); return 0;}
int kl_kf_steady_gain(const kl_real *F, const kl_real *H, const kl_real *Q, const kl_real *R, int n, int m, kl_real tol, int max_iter, kl_real *K_out, kl_real *P_out, kl_real *work){ kl_real *P = work; kl_real *T = P + n * n; kl_real *U = T + n * n; kl_real *V = U + n * n; kl_real *S = V + n * n; kl_real *L = S + m * m; kl_real *HP = L + m * m; kl_real *Kt = HP + m * n; kl_real *K = Kt + m * n;
kl_mat_copy(Q, P, n, n); for (int it = 0; it < max_iter; it++) { if (riccati_gain(H, R, P, n, m, S, L, HP, Kt, K) != 0) return -1; /* Pn = F (P - K H P) F^T + Q */ kl_mat_mul(K, HP, T, n, m, n); kl_mat_sub(P, T, U, n, n); kl_mat_mul(F, U, T, n, n, n); kl_mat_mul_bt(T, F, U, n, n, n); kl_mat_add(U, Q, V, n, n);
kl_real dmax = 0, pmax = 0; for (int i = 0; i < n * n; i++) { kl_real d = KL_FABS(V[i] - P[i]), a = KL_FABS(V[i]); dmax = d > dmax ? d : dmax; pmax = a > pmax ? a : pmax; } kl_mat_copy(V, P, n, n); if (dmax <= tol * pmax) { if (riccati_gain(H, R, P, n, m, S, L, HP, Kt, K) != 0) return -1; kl_mat_copy(K, K_out, n, m); if (P_out) kl_mat_copy(P, P_out, n, n); return 0; } } return -1;}C++
C++ 把 Mat 做成带尺寸模板参数的值类型,运算符重载之后,滤波器的代码看起来就是公式:
// x- = F x + B u, P- = F P F^T + Q void predict(const Mat<U, 1, T>& u) { x = F * x + B * u; P = F * P * F.transpose() + Q; }
// For models without a control input (U == 0). void predict() { static_assert(U == 0, "this model has a control input"); x = F * x; P = F * P * F.transpose() + Q; }
// Joseph-form update. Returns false, leaving x and P unchanged, if S is not // positive definite. bool update(const Mat<M, 1, T>& z) { Mat<N, M, T> K; if (!gain(z, K)) return false; const Mat<N, N, T> A = Mat<N, N, T>::identity() - K * H; P = (A * P * A.transpose() + K * R * K.transpose()).symmetrized(); return true; }私有的 gain 是两种更新共用的部分:
private: // Shared part of both updates: y, S, K from a Cholesky solve, then x += K y. // Leaves everything unchanged if S is not positive definite. bool gain(const Mat<M, 1, T>& z, Mat<N, M, T>& K) { const Mat<M, 1, T> y_new = z - H * x; const Mat<M, N, T> HP = H * P; Mat<M, M, T> L = HP * H.transpose() + R; const Mat<M, M, T> S_new = L; if (!cholesky(L)) return false; y = y_new; S = S_new;
// K^T = S^-1 (H P), solved with the Cholesky factor, no explicit inverse K = chol_solve(L, HP).transpose(); x = x + K * y; return true; }F * P * F.transpose() + Q 对应 ,没有一行索引。类型系统在检查维度:H * P 是 Mat<M,N> * Mat<N,N>,HP * H.transpose() 是 Mat<M,N> * Mat<N,M>,结果是 Mat<M,M>,再加 R。运算符返回新值,编译器的返回值优化和内联会消掉大部分拷贝;这个设计比 C 版省心,代价是我没法精确控制临时对象,有性能要求的话得看汇编。
update 和第 3 篇的 update_short 共用私有的 gain:它先在 L 里算 ,再原地 Cholesky,失败时返回 false,此时 x、P、y、S 都还是旧值。cholesky 是 constexpr:Mat 的所有运算都是,所以编译期就能算小矩阵,我没有用到这一点,只是顺手成立。
完整源码:cpp/include/kl/mat.hpp
// Small fixed-size row-major matrices. No heap: storage is a std::array.#pragma once#include <array>#include <cmath>#include <cstddef>
namespace kl {
template <std::size_t R, std::size_t C, class T = double>struct Mat { std::array<T, R * C> a{}; // row-major, zero-initialized
constexpr T& operator()(std::size_t i, std::size_t j) { return a[i * C + j]; } constexpr const T& operator()(std::size_t i, std::size_t j) const { return a[i * C + j]; }
static constexpr Mat zeros() { return Mat{}; }
static constexpr Mat identity() { static_assert(R == C, "identity needs a square matrix"); Mat m{}; for (std::size_t i = 0; i < R; i++) m(i, i) = T(1); return m; }
constexpr Mat<C, R, T> transpose() const { Mat<C, R, T> t{}; for (std::size_t i = 0; i < R; i++) for (std::size_t j = 0; j < C; j++) t(j, i) = (*this)(i, j); return t; }
// (A + A^T) / 2 constexpr Mat symmetrized() const { static_assert(R == C, "symmetrized needs a square matrix"); Mat s{}; for (std::size_t i = 0; i < R; i++) for (std::size_t j = 0; j < C; j++) s(i, j) = T(0.5) * ((*this)(i, j) + (*this)(j, i)); return s; }
constexpr Mat operator+(const Mat& o) const { Mat r{}; for (std::size_t i = 0; i < R * C; i++) r.a[i] = a[i] + o.a[i]; return r; }
constexpr Mat operator-(const Mat& o) const { Mat r{}; for (std::size_t i = 0; i < R * C; i++) r.a[i] = a[i] - o.a[i]; return r; }
constexpr Mat operator*(T s) const { Mat r{}; for (std::size_t i = 0; i < R * C; i++) r.a[i] = a[i] * s; return r; }
friend constexpr Mat operator*(T s, const Mat& m) { return m * s; }
// (R x C) * (C x K) -> (R x K) template <std::size_t K> constexpr Mat<R, K, T> operator*(const Mat<C, K, T>& o) const { Mat<R, K, T> r{}; for (std::size_t i = 0; i < R; i++) for (std::size_t j = 0; j < K; j++) { T s = 0; for (std::size_t k = 0; k < C; k++) s += (*this)(i, k) * o(k, j); r(i, j) = s; } return r; }};
// In-place lower Cholesky, A = L L^T. Only the lower triangle of A is read; on// success it holds L and the strict upper triangle is left untouched.// Returns false (A partially overwritten) if a pivot is <= 0.template <std::size_t N, class T>constexpr bool cholesky(Mat<N, N, T>& A) { for (std::size_t j = 0; j < N; j++) { T d = A(j, j); for (std::size_t k = 0; k < j; k++) d -= A(j, k) * A(j, k); if (!(d > T(0))) return false; // also rejects NaN const T l = std::sqrt(d); A(j, j) = l; for (std::size_t i = j + 1; i < N; i++) { T s = A(i, j); for (std::size_t k = 0; k < j; k++) s -= A(i, k) * A(j, k); A(i, j) = s / l; } } return true;}
// Solves (L L^T) X = B for every column of B by forward then backward substitution.// L is the lower factor from cholesky(); its upper triangle is ignored.template <std::size_t N, std::size_t K, class T>constexpr Mat<N, K, T> chol_solve(const Mat<N, N, T>& L, const Mat<N, K, T>& B) { Mat<N, K, T> X = B; for (std::size_t c = 0; c < K; c++) { for (std::size_t i = 0; i < N; i++) { // L z = b T s = X(i, c); for (std::size_t k = 0; k < i; k++) s -= L(i, k) * X(k, c); X(i, c) = s / L(i, i); } for (std::size_t i = N; i-- > 0;) { // L^T x = z T s = X(i, c); for (std::size_t k = i + 1; k < N; k++) s -= L(k, i) * X(k, c); X(i, c) = s / L(i, i); } } return X;}
} // namespace kl完整源码:cpp/include/kl/kf.hpp(文件里还有第 3 篇才讲的 `update_short` 和稳态增益)
// Generic linear Kalman filter: N states, M measurements, U control inputs (may be 0).#pragma once#include "kl/mat.hpp"
namespace kl {
template <std::size_t N, std::size_t M, std::size_t U, class T = double>class KalmanFilter {public: Mat<N, 1, T> x; Mat<N, N, T> P, F, Q; Mat<N, U, T> B; Mat<M, N, T> H; Mat<M, M, T> R; Mat<M, 1, T> y; // innovation of the last update Mat<M, M, T> S; // its covariance
// x- = F x + B u, P- = F P F^T + Q void predict(const Mat<U, 1, T>& u) { x = F * x + B * u; P = F * P * F.transpose() + Q; }
// For models without a control input (U == 0). void predict() { static_assert(U == 0, "this model has a control input"); x = F * x; P = F * P * F.transpose() + Q; }
// Joseph-form update. Returns false, leaving x and P unchanged, if S is not // positive definite. bool update(const Mat<M, 1, T>& z) { Mat<N, M, T> K; if (!gain(z, K)) return false; const Mat<N, N, T> A = Mat<N, N, T>::identity() - K * H; P = (A * P * A.transpose() + K * R * K.transpose()).symmetrized(); return true; }
// Textbook short form P = (I - K H) P-: cheaper, but neither symmetry nor // positive definiteness is preserved. Same failure behavior as update(). bool update_short(const Mat<M, 1, T>& z) { Mat<N, M, T> K; if (!gain(z, K)) return false; P = (Mat<N, N, T>::identity() - K * H) * P; return true; }
private: // Shared part of both updates: y, S, K from a Cholesky solve, then x += K y. // Leaves everything unchanged if S is not positive definite. bool gain(const Mat<M, 1, T>& z, Mat<N, M, T>& K) { const Mat<M, 1, T> y_new = z - H * x; const Mat<M, N, T> HP = H * P; Mat<M, M, T> L = HP * H.transpose() + R; const Mat<M, M, T> S_new = L; if (!cholesky(L)) return false; y = y_new; S = S_new;
// K^T = S^-1 (H P), solved with the Cholesky factor, no explicit inverse K = chol_solve(L, HP).transpose(); x = x + K * y; return true; }};
// Steady-state gain: iterate the Riccati recursion on the prior covariance until// max|dP| <= tol * max|P|. Returns false if it does not converge or S is not SPD.// K is the gain for the converged prior P.template <std::size_t N, std::size_t M, class T>bool steady_state_gain(const Mat<N, N, T>& F, const Mat<M, N, T>& H, const Mat<N, N, T>& Q, const Mat<M, M, T>& R, Mat<N, M, T>& K, Mat<N, N, T>& P, T tol = T(1e-12), int max_iter = 100000) { auto gain = [&](const Mat<N, N, T>& Pp, Mat<N, M, T>& Kp) { const Mat<M, N, T> HP = H * Pp; Mat<M, M, T> L = HP * H.transpose() + R; if (!cholesky(L)) return false; Kp = chol_solve(L, HP).transpose(); return true; }; auto max_abs = [](const Mat<N, N, T>& m) { T r = 0; for (const T v : m.a) r = std::fmax(r, std::fabs(v)); return r; }; P = Q; bool converged = false; for (int it = 0; it < max_iter && !converged; it++) { if (!gain(P, K)) return false; const Mat<N, N, T> Pn = F * (P - K * H * P) * F.transpose() + Q; converged = max_abs(Pn - P) <= tol * max_abs(Pn); P = Pn; } return converged && gain(P, K);}
} // namespace klRust
/// x- = F x + B u, P- = F P F^T + Q pub fn predict(&mut self, u: &Mat<U, 1>) { self.x = self.f * self.x + self.b * *u; self.p = self.f * self.p * self.f.transpose() + self.q; }
/// Innovation y, covariance S and gain K = (S^-1 H P)^T, shared by both updates. #[allow(clippy::type_complexity)] fn gain(&self, z: &Mat<M, 1>) -> Result<(Mat<M, 1>, Mat<M, M>, Mat<N, M>), CholeskyError> { let y = *z - self.h * self.x; let hp = self.h * self.p; let s = hp * self.h.transpose() + self.r; let l = s.cholesky().ok_or(CholeskyError)?; // K^T = S^-1 (H P), solved without forming S^-1 Ok((y, s, chol_solve(&l, &hp).transpose())) }
/// Joseph-form update. On Cholesky failure the state is left unchanged. pub fn update(&mut self, z: &Mat<M, 1>) -> Result<(), CholeskyError> { let (y, s, k) = self.gain(z)?; self.x = self.x + k * y; let a = Mat::<N, N>::identity() - k * self.h; self.p = (a * self.p * a.transpose() + k * self.r * k.transpose()).symmetrized(); self.y = y; self.s = s; Ok(()) }和 C++ 的结构几乎一样:Mat<R, C> 是 [[Real; C]; R] 的包装,Mul、Add、Sub 通过 trait 实现,const 泛型保证维度对得上。三点差别:
gain里的s.cholesky().ok_or(CholeskyError)?:cholesky返回Option<Mat>,ok_or把None变成错误,?在错误时提前返回。gain只读self、返回元组(y, s, k),update拿到之后才写self.x、self.p,所以失败时状态不变,这是 Rust 的Result风格直接给出的。Mat派生了Copy,所以self.f * self.x不会”移动走”self.f。矩阵是小数组,拷贝就是memcpy。- 无控制输入的模型用
Mat<4, 0>,零长度数组在 const 泛型里是合法的。
完整源码:rust/src/mat.rs
//! Small fixed-size row-major matrices. No heap, `no_std`-compatible.#![allow(clippy::needless_range_loop)]
use crate::real::{Real, sqrt};use core::ops::{Add, Mul, Sub};
#[derive(Clone, Copy, Debug, PartialEq)]pub struct Mat<const R: usize, const C: usize> { pub m: [[Real; C]; R],}
impl<const R: usize, const C: usize> Mat<R, C> { pub const fn zeros() -> Self { Self { m: [[0.0; C]; R] } }
pub fn transpose(&self) -> Mat<C, R> { let mut t = Mat::<C, R>::zeros(); for i in 0..R { for j in 0..C { t.m[j][i] = self.m[i][j]; } } t }}
impl<const N: usize> Mat<N, N> { pub fn identity() -> Self { let mut a = Self::zeros(); for i in 0..N { a.m[i][i] = 1.0; } a }
/// (A + A^T) / 2 pub fn symmetrized(&self) -> Self { let mut s = Self::zeros(); for i in 0..N { for j in 0..N { s.m[i][j] = 0.5 * (self.m[i][j] + self.m[j][i]); } } s }
/// Lower Cholesky factor L with A = L L^T. Only the lower triangle of `self` /// is read; the returned L has zeros above the diagonal. /// Returns `None` if a pivot is not strictly positive. pub fn cholesky(&self) -> Option<Self> { let mut l = Self::zeros(); for j in 0..N { let mut d = self.m[j][j]; for k in 0..j { d -= l.m[j][k] * l.m[j][k]; } if d.is_nan() || d <= 0.0 { return None; } let ljj = sqrt(d); l.m[j][j] = ljj; for i in j + 1..N { let mut s = self.m[i][j]; for k in 0..j { s -= l.m[i][k] * l.m[j][k]; } l.m[i][j] = s / ljj; } } Some(l) }}
/// Solves (L L^T) X = B for X, given the lower Cholesky factor `l`,/// by forward then backward substitution on every column of B.pub fn chol_solve<const N: usize, const K: usize>(l: &Mat<N, N>, b: &Mat<N, K>) -> Mat<N, K> { let mut x = *b; for c in 0..K { for i in 0..N { let mut s = x.m[i][c]; for k in 0..i { s -= l.m[i][k] * x.m[k][c]; } x.m[i][c] = s / l.m[i][i]; } for i in (0..N).rev() { let mut s = x.m[i][c]; for k in i + 1..N { s -= l.m[k][i] * x.m[k][c]; } x.m[i][c] = s / l.m[i][i]; } } x}
impl<const R: usize, const C: usize> Add for Mat<R, C> { type Output = Self; fn add(mut self, o: Self) -> Self { for i in 0..R { for j in 0..C { self.m[i][j] += o.m[i][j]; } } self }}
impl<const R: usize, const C: usize> Sub for Mat<R, C> { type Output = Self; fn sub(mut self, o: Self) -> Self { for i in 0..R { for j in 0..C { self.m[i][j] -= o.m[i][j]; } } self }}
impl<const R: usize, const C: usize> Mul<Real> for Mat<R, C> { type Output = Self; fn mul(mut self, s: Real) -> Self { for row in self.m.iter_mut() { for v in row.iter_mut() { *v *= s; } } self }}
impl<const R: usize, const C: usize, const K: usize> Mul<Mat<C, K>> for Mat<R, C> { type Output = Mat<R, K>; fn mul(self, o: Mat<C, K>) -> Mat<R, K> { let mut c = Mat::<R, K>::zeros(); for i in 0..R { for j in 0..K { let mut s = 0.0; for k in 0..C { s += self.m[i][k] * o.m[k][j]; } c.m[i][j] = s; } } c }}完整源码:rust/src/kf.rs(文件里还有第 3 篇才讲的 `update_short` 和稳态增益)
//! Generic linear Kalman filter: N states, M measurements, U control inputs.#![allow(clippy::needless_range_loop)]
use crate::mat::{Mat, chol_solve};use crate::real::{Real, fabs};
/// The innovation covariance S was not positive definite.#[derive(Debug)]pub struct CholeskyError;
pub struct KalmanFilter<const N: usize, const M: usize, const U: usize> { pub x: Mat<N, 1>, pub p: Mat<N, N>, pub f: Mat<N, N>, pub b: Mat<N, U>, pub h: Mat<M, N>, pub q: Mat<N, N>, pub r: Mat<M, M>, /// Innovation and its covariance from the last successful `update`. pub y: Mat<M, 1>, pub s: Mat<M, M>,}
impl<const N: usize, const M: usize, const U: usize> KalmanFilter<N, M, U> { pub fn new( f: Mat<N, N>, b: Mat<N, U>, h: Mat<M, N>, q: Mat<N, N>, r: Mat<M, M>, x0: Mat<N, 1>, p0: Mat<N, N>, ) -> Self { Self { x: x0, p: p0, f, b, h, q, r, y: Mat::zeros(), s: Mat::zeros(), } }
/// x- = F x + B u, P- = F P F^T + Q pub fn predict(&mut self, u: &Mat<U, 1>) { self.x = self.f * self.x + self.b * *u; self.p = self.f * self.p * self.f.transpose() + self.q; }
/// Innovation y, covariance S and gain K = (S^-1 H P)^T, shared by both updates. #[allow(clippy::type_complexity)] fn gain(&self, z: &Mat<M, 1>) -> Result<(Mat<M, 1>, Mat<M, M>, Mat<N, M>), CholeskyError> { let y = *z - self.h * self.x; let hp = self.h * self.p; let s = hp * self.h.transpose() + self.r; let l = s.cholesky().ok_or(CholeskyError)?; // K^T = S^-1 (H P), solved without forming S^-1 Ok((y, s, chol_solve(&l, &hp).transpose())) }
/// Joseph-form update. On Cholesky failure the state is left unchanged. pub fn update(&mut self, z: &Mat<M, 1>) -> Result<(), CholeskyError> { let (y, s, k) = self.gain(z)?; self.x = self.x + k * y; let a = Mat::<N, N>::identity() - k * self.h; self.p = (a * self.p * a.transpose() + k * self.r * k.transpose()).symmetrized(); self.y = y; self.s = s; Ok(()) }
/// Short-form update P = (I - K H) P-: cheaper, but loses symmetry and /// positive-definiteness when ill-conditioned. Same failure behavior as `update`. pub fn update_short(&mut self, z: &Mat<M, 1>) -> Result<(), CholeskyError> { let (y, s, k) = self.gain(z)?; self.x = self.x + k * y; self.p = (Mat::<N, N>::identity() - k * self.h) * self.p; self.y = y; self.s = s; Ok(()) }}
/// Steady-state gain: iterate the Riccati recursion on the prior covariance until/// max|dP| <= tol * max|P|. Returns (K, converged prior P), or `None` if the/// iteration does not converge or a Cholesky factorization fails.pub fn steady_state_gain<const N: usize, const M: usize>( f: &Mat<N, N>, h: &Mat<M, N>, q: &Mat<N, N>, r: &Mat<M, M>, tol: Real, max_iter: usize,) -> Option<(Mat<N, M>, Mat<N, N>)> { let gain = |p: &Mat<N, N>| -> Option<Mat<N, M>> { let hp = *h * *p; let l = (hp * h.transpose() + *r).cholesky()?; Some(chol_solve(&l, &hp).transpose()) }; let mut p = *q; for _ in 0..max_iter { let k = gain(&p)?; let pn = *f * (p - k * *h * p) * f.transpose() + *q; let (mut dmax, mut pmax): (Real, Real) = (0.0, 0.0); for i in 0..N { for j in 0..N { dmax = dmax.max(fabs(pn.m[i][j] - p.m[i][j])); pmax = pmax.max(fabs(pn.m[i][j])); } } p = pn; if dmax <= tol * pmax { return Some((gain(&p)?, p)); } } None}三个 app(c/apps/ch02.c、cpp/apps/ch02.cpp、rust/src/bin/ch02.rs)除了读数据、搭模型、写 CSV,还在处理数据之前先跑三个自检:Cholesky 因子相乘还原 ,非正定矩阵被拒绝,chol_solve 乘回去还原右端项。任何一个失败进程就以非零码退出。
结果
make -s ch02 的输出(只保留校验与指标部分):
$ make -s ch02ok cv_c.csv: max diff 7.105e-15 <= 1.0e-09ok cv_cpp.csv: max diff 7.105e-15 <= 1.0e-09ok cv_rs.csv: max diff 7.105e-15 <= 1.0e-09ok tilt_bias_c.csv: max diff 2.665e-14 <= 1.0e-09ok tilt_bias_cpp.csv: max diff 2.665e-14 <= 1.0e-09ok tilt_bias_rs.csv: max diff 2.665e-14 <= 1.0e-09
Angle RMSE (deg), 6000 steps, drifting bias 1D filter (no bias state): 2.541 angle+bias filter: 0.348 bias inside +-3 sigma after 10 s: 100.0% of steps final bias: true 0.04525, estimate 0.04347, sigma 0.00243
2D constant-velocity track, 200 steps position RMSE raw measurement: 1.436 m position RMSE Kalman filter: 0.542 m velocity RMSE Kalman filter: 0.616 m/s mean NIS (dof 2, expect ~2): 2.070 mean NIS tilt (dof 1, expect ~1): 0.984这次不再是逐位相同了:最大差值是 量级,因为 Cholesky 里有 sqrt,求和顺序也和 numpy 的 LAPACK 不一样。 离我们定的 容差远得很。
零偏。 第 1 篇的滤波器剩下的 2.541 度,现在变成 0.348 度。下图下半部分是零偏估计:开始时 的带子很宽(初始标准差 0.1 rad/s),不到两秒就收敛到真值附近,之后一直待在带子里。我让脚本断言”10 秒以后,真实零偏落在 以内的步数不少于 95%“,实际是 100.0%。最后一步的估计是 0.04347,真值 0.04525,差 0.0018, 是 0.00243:差不到一个标准差。
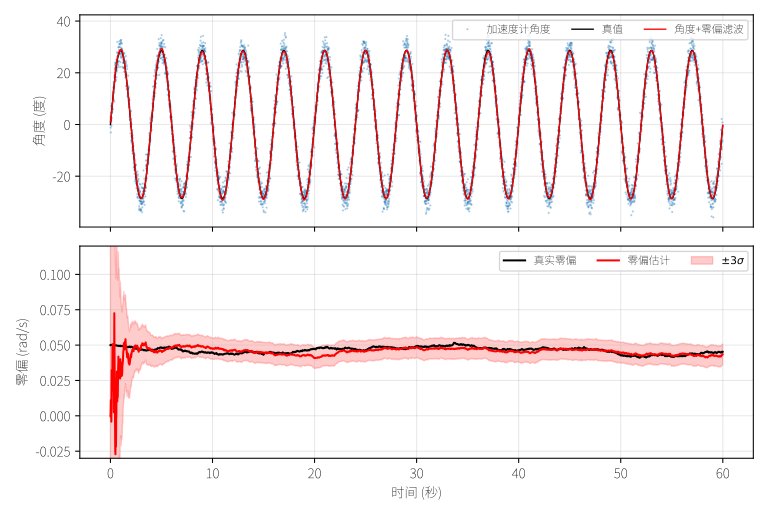
我觉得有意思的一点是:加速度计并不直接测零偏,零偏是靠”陀螺仪积分出来的角度和加速度计角度之间的系统性差距”推出来的,(角度与零偏的协方差)就是在传递这个信息,更新步里 的第二个元素通过它修正零偏。这种”测量 A,修正没测的 B”的能力,就是第 1 篇标量滤波器没有的东西。
匀速模型。 位置 RMSE 从原始测量的 1.436 m 降到 0.542 m,而且滤波器还给出了没有被直接测量的速度,RMSE 0.616 m/s。
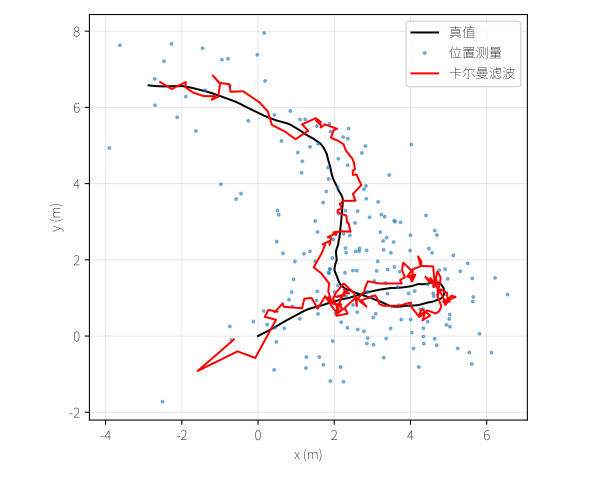
最后两行的平均 NIS 是第 3 篇的预告。NIS 是 ,如果滤波器的模型和噪声都对,它服从自由度等于测量维数的 分布,均值就是测量维数:匀速模型是 2(实测 2.070),倾角模型是 1(实测 0.984)。两个都落在预期附近,第 3 篇会把这件事做得更严格。
下一篇
滤波器能跑,不等于滤波器对。这一篇的数据是我自己用已知的噪声参数生成的,滤波器用的也恰好是这些参数。真实传感器上你不知道 和 ,只能猜。第 3 篇回答三个问题:怎么判断滤波器的 、 猜得对不对(NEES、NIS、新息自相关);什么时候某个状态根本估不出来(可观性);以及上面说的 Joseph 形式到底能救你多少。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!