
 Better Mistakes



音乐
暂未播放
一维卡尔曼滤波:两个高斯相乘
先看一组数。一个单轴倾角,真值是 弧度,陀螺仪积分 20 秒后的均方根误差是 1.097 度,加速度计直接算出来的角度是 2.863 度,把两者交给一个只有几行代码的卡尔曼滤波器,误差降到 0.277 度。比加速度计好 10 倍,比陀螺仪好 4 倍,而且滤波器没有任何”调出来的”魔法数,它的每一个参数都能从传感器的噪声标准差直接算出来。
这个系列要做的事:从这几行出发,一路走到三维姿态(陀螺仪加加速度计加磁力计,四元数状态,估计陀螺零偏)的扩展卡尔曼、误差状态卡尔曼和无迹卡尔曼滤波器。我需要姿态估计去做控制,所以我想把这条路完整地走一遍,每一个公式都自己推,每一段代码都自己写,不依赖 Eigen、nalgebra 这类矩阵库。全程纯软件:传感器是仿真出来的,结论靠软件验证,你不需要任何硬件就能复现每一个数字和每一张图。
这一篇结束时你会有:一份能跑的伴生仓库 kalman-lab,make ch01 通过,生成 out/ch01/ 下六个 CSV(Python、C、C++、Rust 各自的滤波输出)和 figures/ch01/ 下四张图;以及一维卡尔曼滤波的完整推导。
这是第 1 篇,没有前置章节。需要的数学:概率论里的均值、方差和高斯分布,会求导和解一元二次方程就够了。
这个系列怎么读
下面是整个系列的地图:
| 篇 | 标题 | 主要内容 |
|---|---|---|
| 1 | 一维卡尔曼滤波:两个高斯相乘 | 高斯、贝叶斯、预测与更新、稳态增益 |
| 2 | 升到高维:多变量卡尔曼滤波的推导与实现 | 协方差矩阵、Joseph 形式、Cholesky、手写矩阵库 |
| 3 | 调参与诊断:怎么知道滤波器没在骗你 | NEES、NIS、可观性、稳态增益、数值稳定 |
| 4 | 姿态的数学:旋转、四元数与 IMU 仿真器 | SO(3)、四元数、IMU 仿真、互补滤波基线 |
| 5 | 扩展卡尔曼滤波:把四元数塞进 EKF | 线性化、雅可比、EKF 的代价 |
| 6 | 误差状态卡尔曼滤波:四元数的正确打开方式 | 误差状态、切空间、注入与重置 |
| 7 | 无迹卡尔曼滤波,以及四个滤波器同台 | 无迹变换、Mahony/EKF/ESKF/UKF 对比 |
| 8 | 移植之前:float32、定长内存与每步耗时 | float32、UD 分解、无堆内存、耗时 |
四种语言。 每一章的滤波器我都写四遍:Python(numpy,只用来当参考实现和画图)、C(C11,不使用 malloc)、C++(C++20,模板,纯头文件)、Rust(edition 2024,no_std 兼容)。Python 版承担推导和完整讲解;C、C++、Rust 的核心函数我会贴出来,文字只讲它们和 Python 版的区别:内存归谁、尺寸在哪里确定、标量类型怎么切换、语言本身的惯用法。
同一份数据,不要求随机数一致。 所有仿真数据都由 Python 生成,写成 CSV,四种语言读同一份文件。这样四种语言不需要共用随机数发生器,而且这恰好就是上硬件之后的工作流:传感器日志进来,滤波器处理。
真实输出。 文中所有终端输出、数值、图,都来自我在这台机器上跑 make ch01 的结果;不是我现编的。每个浮点数在 CSV 里都写成 17 位有效数字,C、C++、Rust 的输出和 Python 参考的最大差值要在 以内才算通过。
装环境
代码在 kalman-lab,本系列固定在 tutorial-v1 标签。仓库里有一个 flake.nix,nix develop 进去就是我用的全部工具:
git clone https://github.com/bfmhno3/kalman-lab.gitcd kalman-labgit checkout tutorial-v1nix developkalman-lab dev shell: Python 3.13.15, gcc (GCC) 15.3.0, rustc 1.95.0 (59807616e 2026-04-14) (built from a source tarball)没有 Nix 的话,自己装这几样就行:Python 3 加 numpy、matplotlib、scipy;gcc 13 或更新(要支持 C11 和 C++20);用 rustup 装的 Rust stable,外加 clippy。画图时中文标签用的字体通过环境变量 KL_CJK_FONT 指定(flake.nix 已经设好),找不到字体时图的标签自动退回英文。
所有命令都在仓库根目录跑。make ch01 做五件事:用 Python 生成数据并跑参考实现;编译 C、C++、Rust 三个版本;各自读同一份数据并输出;用 python/compare.py 逐列对比;最后打印指标并画图。
一维倾角问题
我们先用最简单的问题建立直觉:一个物体绕一根轴转动,我们想知道它的倾角 。手上有两个传感器:
- 陀螺仪测角速度:, 是白噪声, 是零偏。这一篇先令 。
- 加速度计在静止附近能反推出倾角:,。
两者互补。陀螺仪积分得到的角度很平滑,但每一步的噪声会累积,长时间之后漂走;加速度计没有漂移,但每个样本都很吵。滤波器要做的事,就是把”相信积分”和”相信测量”按各自的可信度混起来。
仿真参数我固定下来(python/kl/sim1d.py):
- 真值 rad,周期 4 秒,幅值约 28.6 度。
- 步长 s,2000 步(20 秒),种子 1。
- rad/s, rad。
数学
高斯分布
一个随机变量 ,均值 ,方差 。高斯分布的概率密度是
高斯分布有两条性质,整个卡尔曼滤波都建立在它们上面:两个高斯相乘(归一化之后)还是高斯,两个独立高斯相加还是高斯。下面分别推。
贝叶斯公式:先验乘似然
设我们对状态 有一个先验信念 ,然后得到一次测量 。贝叶斯公式说
后验正比于”似然乘先验”。分母 不依赖 ,只是个归一化常数,后面可以忽略。
在我们的模型里,测量是 ,所以似然 ,其中 。把它看成 的函数,因为 ,它就是 。设先验是 ,先验乘似然就是两个高斯相乘。
两个高斯相乘(更新)
方括号里是 的二次函数,把它按 的幂展开:
我们希望把它写成 的形式(配方)。展开 ,对照 和 的系数:
解出
两件事一眼就能读出来。精度(方差的倒数)相加:两个信息源合起来,方差一定比任何一个都小。均值是加权平均,谁的方差小,谁的权重大。
换一种写法更接近代码。令 ,则
验证第二式:。
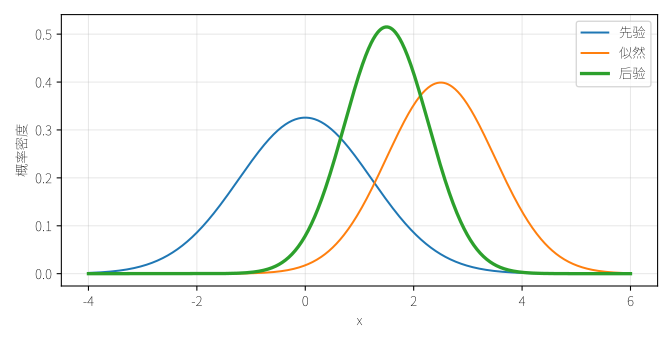
后验比两者都窄,峰位落在两者之间,更靠近更窄的那个。
两个独立高斯相加(预测)
滤波器每走一步,状态要根据运动模型往前推。设上一步的后验是 ,我们根据陀螺仪的读数推进:
这里 是陀螺仪读数,当成已知的控制输入; 是过程噪声,它代表”这一步积分不准多少”,和 独立。独立随机变量之和的均值相加,方差也相加:
(方差相加:,独立时协方差为零。和仍是高斯,因为两个高斯密度的卷积还是高斯,这是标准结论,我这里直接引用。)
怎么取?陀螺仪读数的噪声是 ,每一步角度增量的噪声是 ,所以
一维卡尔曼滤波
把两步合起来。用上标减号表示先验(预测之后、更新之前):
测量更新就是把先验 和似然 相乘,套上一节的公式(,):
叫卡尔曼增益。 叫新息(innovation),它是”测量比预测多出来的那部分信息”。如果 很大(预测不可信),,滤波器几乎完全相信测量;如果 很大(测量不可信),,几乎完全相信预测。
整个滤波器就是上面这几个公式。注意 的递推根本不依赖测量值 ,也不依赖 :协方差和增益可以提前算出来。这一点在高维时会变得很重要。
稳态
如果 和 是常数, 会收敛到一个定值 。从一步到下一步:更新后 (把 代入 ),然后预测加 :
两边乘 :
取正根:
代入 ,,得到 ,。
常增益就是低通滤波器
把常数 代回 并整理:
这是一个指数滑动平均(EMA),只不过被平均的不是测量,而是”按陀螺仪推进之后的预测”。 意味着每一步只把 1% 的权重给加速度计,等效时间常数 秒:短于 1 秒的变化听陀螺仪的,长于 1 秒的偏差听加速度计的。这就是互补滤波器,第 4 篇会把它推广到三维。卡尔曼滤波的价值在于,它不需要你去猜这个截止频率,它是 和 的函数。
Python 实现
仿真器
"""Single-axis tilt simulator for chapter 1."""
from pathlib import Path
import numpy as np
from .io import write_csv
ROOT = Path(__file__).resolve().parents[2]
def simulate_tilt(seed, n=2000, dt=0.01, gyro_sigma=0.05, meas_sigma=0.05, bias=0.0): rng = np.random.default_rng(seed) t = np.arange(n) * dt w = 2 * np.pi * 0.25 theta = 0.5 * np.sin(w * t) omega = 0.5 * w * np.cos(w * t) omega_m = omega + bias + gyro_sigma * rng.standard_normal(n) z = theta + meas_sigma * rng.standard_normal(n) cols = {"t": t, "omega_m": omega_m, "z": z, "theta": theta} path = ROOT / "data" / f"ch01_tilt_b{bias:g}_seed{seed}.csv" write_csv(path, cols) return colsomega 是真值的解析导数 ,陀螺读数是它加零偏加噪声。输出 CSV 的列是 t,omega_m,z,theta,theta 只在评估时用,滤波器看不到。
滤波器
"""Scalar Kalman filter."""
class KF1D: def __init__(self, x0, p0, q, r): self.x = x0 self.p = p0 self.q = q self.r = r self.k = 0.0
def predict(self, u_dt): """x- = x + u*dt, P- = P + q.""" self.x = self.x + u_dt self.p = self.p + self.q
def update(self, z): """K = P-/(P- + r); x = x- + K (z - x-); P = (1 - K) P-.""" self.k = self.p / (self.p + self.r) self.x = self.x + self.k * (z - self.x) self.p = (1.0 - self.k) * self.p和公式一一对应,没有多余的东西。predict 接收的是 u_dt(已经乘过 的角度增量),这样滤波器本身不需要知道步长。update 里先算 k 再覆盖 x,覆盖 p 时用的是 (1 - k) * p,此时 p 还是先验 ,顺序不能换。
run_filter 是把它放进循环的小包装:
def run_filter(omega_m, z, dt, q, r, x0=0.0, p0=1.0): import numpy as np
kf = KF1D(x0, p0, q, r) n = len(z) x, p, k = np.empty(n), np.empty(n), np.empty(n) for i in range(n): kf.predict(omega_m[i] * dt) kf.update(z[i]) x[i], p[i], k[i] = kf.x, kf.p, kf.k return x, p, k初值 (真值在 恰好是 0),(一个很大的不确定度,1 rad,意思是”我不太知道”)。每一步先 predict 再 update。
C、C++、Rust 实现
三个版本的结构完全一样,我把差别列在前面。
- 标量类型。 从这一章起我就把
double/float做成可切换的,这样第 8 篇上 float32 时不用改任何一行滤波器代码。C 用kl_real.h里的typedef,C++ 用模板参数T(默认double),Rust 用real.rs里的Real别名(f32特性开关)。 - 内存。 一维滤波器只有五个标量,是一个小 struct;调用者拥有它,库里没有任何
malloc、new、Vec。 - CSV。 读写 CSV 是主机端的事,放在
c/src/csv.c(用堆)、cpp/include/kl/csv.hpp、rust/src/io.rs(std特性之后)里,库代码不碰它们。
C
typedef struct { kl_real x, p, q, r, k;} kl_kf1d;
void kl_kf1d_predict(kl_kf1d *f, kl_real u_dt){ f->x = f->x + u_dt; f->p = f->p + f->q;}
void kl_kf1d_update(kl_kf1d *f, kl_real z){ f->k = f->p / (f->p + f->r); f->x = f->x + f->k * (z - f->x); f->p = (1 - f->k) * f->p;}C 里没有方法,所以第一个参数显式传 struct 指针,函数名带 kl_kf1d_ 前缀当命名空间。初始化函数 kl_kf1d_init 只是给五个字段赋值。
完整源码:c/include/kl/kl_real.h、c/include/kl/kl_kf1d.h、c/src/kl_kf1d.c
/* Scalar type switch: double by default, float with -DKL_USE_FLOAT. */#ifndef KL_REAL_H#define KL_REAL_H
#include <math.h>
#ifdef KL_USE_FLOATtypedef float kl_real;#define KL_SQRT sqrtf#define KL_SIN sinf#define KL_COS cosf#define KL_ATAN2 atan2f#define KL_ASIN asinf#define KL_FABS fabsf#elsetypedef double kl_real;#define KL_SQRT sqrt#define KL_SIN sin#define KL_COS cos#define KL_ATAN2 atan2#define KL_ASIN asin#define KL_FABS fabs#endif
#endif#ifndef KL_KF1D_H#define KL_KF1D_H
#include "kl/kl_real.h"
typedef struct { kl_real x, p, q, r, k;} kl_kf1d;
void kl_kf1d_init(kl_kf1d *f, kl_real x0, kl_real p0, kl_real q, kl_real r);/* x- = x + u_dt, P- = P + q */void kl_kf1d_predict(kl_kf1d *f, kl_real u_dt);/* K = P-/(P- + r), x = x- + K (z - x-), P = (1 - K) P- */void kl_kf1d_update(kl_kf1d *f, kl_real z);
#endif#include "kl/kl_kf1d.h"
void kl_kf1d_init(kl_kf1d *f, kl_real x0, kl_real p0, kl_real q, kl_real r){ f->x = x0; f->p = p0; f->q = q; f->r = r; f->k = 0;}
void kl_kf1d_predict(kl_kf1d *f, kl_real u_dt){ f->x = f->x + u_dt; f->p = f->p + f->q;}
void kl_kf1d_update(kl_kf1d *f, kl_real z){ f->k = f->p / (f->p + f->r); f->x = f->x + f->k * (z - f->x); f->p = (1 - f->k) * f->p;}C++
template <class T = double>class KF1D {public: T x, p, q, r, k = 0;
KF1D(T x0, T p0, T q, T r) : x(x0), p(p0), q(q), r(r) {}
void predict(T u_dt) { x = x + u_dt; p = p + q; }
void update(T z) { k = p / (p + r); x = x + k * (z - x); p = (1 - k) * p; }};整个类是头文件里的模板,没有任何运行期开销:编译器看得到全部代码,KF1D<float> 和 KF1D<double> 各自生成一份。字段保持 public,因为这个滤波器小到封装只会碍事。
完整源码:cpp/include/kl/kf1d.hpp
#pragma once
namespace kl {
template <class T = double>class KF1D {public: T x, p, q, r, k = 0;
KF1D(T x0, T p0, T q, T r) : x(x0), p(p0), q(q), r(r) {}
// x- = x + u_dt, P- = P + q void predict(T u_dt) { x = x + u_dt; p = p + q; }
// K = P-/(P- + r), x = x- + K (z - x-), P = (1 - K) P- void update(T z) { k = p / (p + r); x = x + k * (z - x); p = (1 - k) * p; }};
} // namespace klRust
pub struct Kf1d { pub x: Real, pub p: Real, q: Real, r: Real, pub k: Real,}
impl Kf1d { pub fn predict(&mut self, u_dt: Real) { self.x += u_dt; self.p += self.q; }
pub fn update(&mut self, z: Real) { self.k = self.p / (self.p + self.r); self.x += self.k * (z - self.x); self.p *= 1.0 - self.k; }}Rust 版把 q 和 r 设成私有,滤波器运行时它们不应该被外部改,状态 x、p、k 则公开可读。&mut self 在类型层面声明”这个方法会改状态”,p *= 1.0 - self.k 用的是上一行刚算出来的新增益,顺序和另外三个版本一致。
完整源码:rust/src/kf1d.rs、rust/src/real.rs
use crate::real::Real;
pub struct Kf1d { pub x: Real, pub p: Real, q: Real, r: Real, pub k: Real,}
impl Kf1d { pub fn new(x0: Real, p0: Real, q: Real, r: Real) -> Self { Self { x: x0, p: p0, q, r, k: 0.0 } }
/// x- = x + u_dt, P- = P + q pub fn predict(&mut self, u_dt: Real) { self.x += u_dt; self.p += self.q; }
/// K = P-/(P- + r), x = x- + K (z - x-), P = (1 - K) P- pub fn update(&mut self, z: Real) { self.k = self.p / (self.p + self.r); self.x += self.k * (z - self.x); self.p *= 1.0 - self.k; }}//! Scalar type switch: `f64` by default, `f32` under the `f32` cargo feature.//! Math goes through `libm` so the library works under `no_std`.
#[cfg(not(feature = "f32"))]pub type Real = f64;#[cfg(feature = "f32")]pub type Real = f32;
#[cfg(not(feature = "f32"))]mod m { pub use libm::{asin, atan2, cos, fabs, sin, sqrt};}#[cfg(feature = "f32")]mod m { pub use libm::{asinf as asin, atan2f as atan2, cosf as cos, fabsf as fabs, sinf as sin, sqrtf as sqrt};}
#[inline]pub fn sqrt(x: Real) -> Real { m::sqrt(x)}#[inline]pub fn sin(x: Real) -> Real { m::sin(x)}#[inline]pub fn cos(x: Real) -> Real { m::cos(x)}#[inline]pub fn atan2(y: Real, x: Real) -> Real { m::atan2(y, x)}#[inline]pub fn asin(x: Real) -> Real { m::asin(x)}#[inline]pub fn fabs(x: Real) -> Real { m::fabs(x)}三个 app(c/apps/ch01.c、cpp/apps/ch01.cpp、rust/src/bin/ch01.rs)读数据、循环 predict/update、写 CSV,没有任何值得讲的东西,我就不贴了。
结果
先看一眼滤波输出。黑线是真值,点是加速度计角度 ,红线是滤波器:
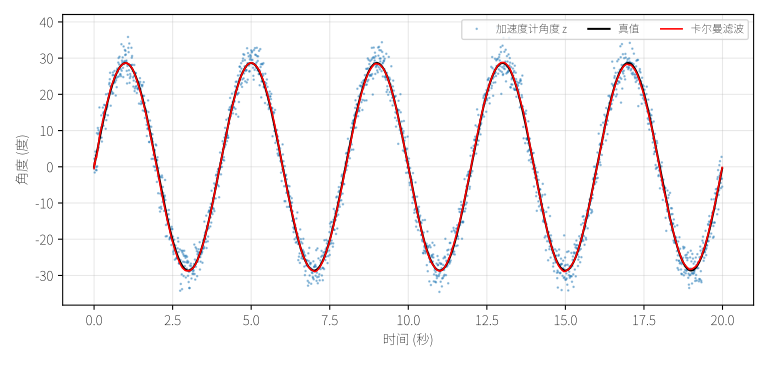
下面是 make -s ch01 的输出(-s 去掉 make 自己的回显,编译日志不在里面):
$ make -s ch01ok tilt_b0.05_c.csv: max diff 0.000e+00 <= 1.0e-09ok tilt_b0.05_cpp.csv: max diff 0.000e+00 <= 1.0e-09ok tilt_b0.05_rs.csv: max diff 0.000e+00 <= 1.0e-09ok tilt_b0_c.csv: max diff 0.000e+00 <= 1.0e-09ok tilt_b0_cpp.csv: max diff 0.000e+00 <= 1.0e-09ok tilt_b0_rs.csv: max diff 0.000e+00 <= 1.0e-09
RMSE (deg), seed 1, 2000 steps bias (rad/s) gyro-only accel-only KF 0 1.097 2.863 0.277 0.05 32.090 2.863 2.662
K_inf analytic = 0.009950, numeric (k=2000) = 0.009950P-_inf analytic = 2.512531e-051-K_inf = 0.990050 (EMA time constant ~ 1.005 s)三种语言和 Python 的最大差值都是 0.000e+00,一个比特都不差。这不奇怪:这个滤波器只有加减乘除,IEEE 754 规定这几个运算的结果必须是正确舍入的,只要编译器不重排运算(-O2 不会,没有 -ffast-math),四种语言算出来的就是同一串二进制。进了第 2 篇的矩阵运算和第 4 篇的 sin/cos 之后就没有这么好的事了,所以才需要 的容差。
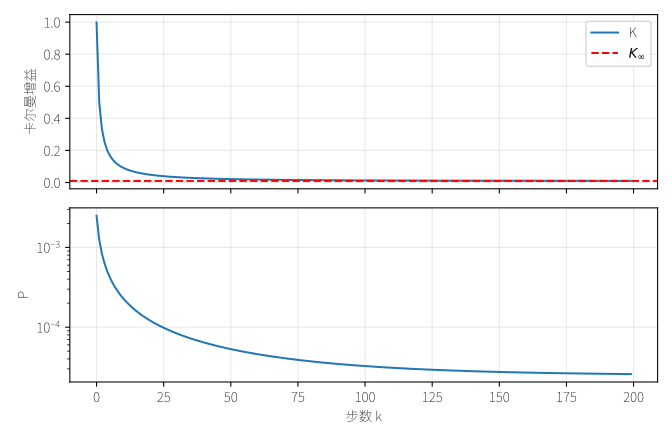
数值解和解析解对上了:2000 步之后的增益是 0.009950,和公式算出的 在六位小数内一致。收敛得很快:
零偏会发生什么。 表里第二行是我故意加了 0.05 rad/s 的陀螺仪零偏之后的结果。陀螺仪单独积分直接飞走:32 度的 RMSE(20 秒内累积 rad,约 57 度的漂移)。滤波器没有飞,因为加速度计一直在拉它,但是 RMSE 从 0.277 度退化到 2.662 度,几乎和加速度计单独用(2.863 度)一样差。我们几乎白忙了一场。
原因可以算出来。令 是稳态下的估计误差,忽略噪声,每一步预测引入 的额外偏差,更新把它缩小到原来的 :
实测最后 1000 步的平均误差是 2.858 度。常数零偏被滤波器当成了一个固定的偏移量:它在系统里是一个没有被建模的状态。要消除它,唯一的办法是把零偏 也放进状态里去估计。这就是第 2 篇要做的事,一个状态变两个状态,标量变矩阵。
是不是真的取对了。 我把 乘以 到 重跑了无零偏的数据:
q sweep (bias 0) q x 0.01 RMSE 0.464 deg, K_inf 0.0010 q x 0.1 RMSE 0.343 deg, K_inf 0.0032 q x 1 RMSE 0.277 deg, K_inf 0.0100 q x 10 RMSE 0.368 deg, K_inf 0.0311 q x 100 RMSE 0.636 deg, K_inf 0.0951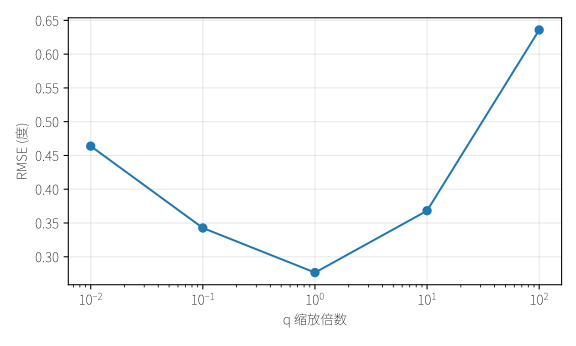
最低点恰好在 ,也就是我们用 算出来的值。偏小,滤波器过于相信陀螺仪,对 的纠正太慢;偏大,对加速度计的噪声太敏感。我不会说”这证明了卡尔曼滤波最优”,只有一个种子,一组参数,但至少它说明:当模型和数据吻合时,不用调参,由噪声标准差直接换算的 就落在最好的位置。怎么判断”模型和数据吻合”,是第 3 篇的主题。
下一篇
一个状态只能描述一个角度。真实的陀螺仪有零偏,零偏会缓慢漂移,这要求状态变成 ,方差变成协方差矩阵,乘法变成矩阵乘法, 变成矩阵求逆(我们会用 Cholesky 分解绕开它)。第 2 篇从多元高斯的条件分布推导出一般形式的卡尔曼滤波,把第 1 篇的公式一次性升级,并把本篇几行的 C 代码换成一个手写的矩阵库。零偏那一行 2.662 度的 RMSE,到时候会降到什么水平,我们直接看数据。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!