
 Better Mistakes



音乐
暂未播放
误差状态卡尔曼滤波:四元数的正确打开方式
先给一个会让人高兴的数:同一份 120 秒的数据,上一篇的 EKF 总姿态误差 RMSE 是 4.719 度,这一篇的误差状态卡尔曼滤波(ESKF)是 0.932 度,磁干扰窗口里的横滚俯仰误差从 3.214 度降到 0.070 度。再给一个让这个数不那么高兴的数:把上一篇的 EKF 加上和 ESKF 一样的一行磁力计模长门控,它自己是 0.804 度,横滚俯仰是 0.068 度。也就是说,这 4.7 降到 0.9 的绝大部分功劳属于那一行 if,不属于误差状态。
我想把这件事说清楚,因为误差状态滤波器确实有它的价值,只是不在这张表上。
这一篇结束时你会有:make ch06 通过,out/ch06/eskf_{nominal,large}_{py,c,cpp,rs}.csv,四张图;C、C++、Rust 各一个 ESKF(kl_eskf、eskf.hpp、eskf.rs)。两个测量雅可比的有限差分检查在每个语言的 app 里先于数据处理运行。蒙特卡洛统计(种子 1 到 50)只在 Python 里算,同第 3 篇的理由。
前置:第 5 篇。理论部分参考 Joan Solà,“Quaternion kinematics for the error-state Kalman filter”(arXiv<1711>.02508,2017),符号基本沿用它。
数学
名义状态与误差状态
EKF 把四元数的 4 个分量直接当成状态,带来了一个多余的自由度(第 5 篇最后看到的 的第四个特征值)。ESKF 换了个做法:
- 名义状态 :我们认为的姿态和零偏,非线性地传播,不带协方差。
- 误差状态 :真值和名义状态的差。姿态误差定义成第 4 篇的右乘形式:,零偏误差 。滤波器的协方差是这个 6 维向量的协方差,。
好处有三:
- 是 3 维旋转向量,没有约束,在原点附近是平坦的,协方差 满秩,没有多余自由度。
- 误差永远很小(滤波器的目标就是让它小),所以线性化在原点附近一阶展开是好的近似;大的运动由名义状态的非线性传播承担。
- 每次更新后,误差被注入名义状态,然后重置为 0:滤波器总是在原点附近线性化。
误差的动力学
设真实角速度 ,名义角速度 。要求 怎么演化。令 ,对时间求导,用 ( 在这里指 ):
(用了 ,纯虚四元数的共轭是它的负。)把 代入,向量部分:
(保留一阶小量, 用在二阶项里。)所以
这里 。这是 Solà 的结果。
离散化。 角速度在一步里取常数 , 的矩阵指数是旋转 对应的矩阵,也就是 ;对 的耦合到一阶是 :
名义状态的预测还是 , 不变。因为每一步更新之后误差都被重置为 0,预测步里误差状态均值始终是 0,只有协方差在动。
测量模型
加速度计。 重力方向的真实机体系读数是 ,。 对应的矩阵作用在 上,一阶是 ,所以
(最后一步是 。)于是 ,,新息 ,,和 EKF 一样,门控也一样()。
磁力计:只更新航向。 第 5 篇的 EKF 把磁力计的整个 3 维向量塞进更新,磁干扰会污染横滚俯仰。这一篇换一个模型:把磁力计测量按名义姿态旋转到世界系,只比较水平面内的航向角。设 ,测得的航向 ,参考场的航向 ,新息 ,折到一个周期内。
求 。真实姿态是 ,磁力计读数 ,。令世界系下的误差旋转 (局部误差转到世界系),,所以 。对航向角求导:,,在标称点 ,(因为 ),链式法则得到
对我们的磁场 ,。
注意第一项:只有”世界系 分量 “不对。我一开始预想的就是只有这一项,有限差分检查给了它一个明确的否定:只取世界 分量,和有限差分的最大误差是 1.19,恰好是 。物理原因是磁场有 50 度的倾角:横滚误差(绕世界 的误差旋转 )会让磁场向量的水平投影转动,在航向读数里造成 的耦合。把这一项放进 之后,两个雅可比的有限差分检查通过:,,都在 的门槛之内。有限差分的做法是”通过注入来扰动”:对 100 个确定性的名义姿态,给姿态右乘 当作”真实姿态”,按真实姿态生成无噪声测量,对新息做中心差分。
这个耦合项在滤波器里的实际作用是:横滚、俯仰的协方差已经被加速度计压得很小,所以卡尔曼增益里这部分权重很小,航向修正主要落在偏航上,这才是”只更新航向”想要的效果。
航向噪声。 磁力计水平分量噪声约 ,水平分量的长度是 ,所以航向噪声 。
磁力计门控。 跳过 的样本。我们的磁干扰是加上 ,磁场模长变成 ,被检测出来是必然的:这个检测器对这种干扰没有盲区。
注入与重置
更新给出 ,注入名义状态:
注入之后误差状态应该清零。但是协方差是在旧的名义姿态的切空间里定义的,名义姿态变了,切空间也跟着转了一个 。Solà 给出重置雅可比 ,。 很小的时候 。我把它实现了,并且测了它的效果:见结果。
初值
名义初值:TRIAD 的 ,;。
Python 实现
"""Error-state (multiplicative) Kalman filter for attitude, after Sola (2017).
Nominal state: q, b. Error state: [dtheta (3), db (3)] with q_true = q (x) exp(dtheta),b_true = b + db. The covariance P is 6x6 and always full rank."""
import numpy as np
from .imu_sim import Gfrom .quat import qexp, qmul, qnormalize, qrot, skew, wrap_pifrom .update import joseph_update
class ESKF: def __init__(self, sigma_g, sigma_bw, sigma_a, sigma_m, m_w, q0, P0, accel_gate=0.5, mag_gate=0.1, reset=True): self.sg, self.sbw, self.sa, self.sm = sigma_g, sigma_bw, sigma_a, sigma_m self.m_w = np.asarray(m_w, dtype=float) self.q = np.asarray(q0, dtype=float).copy() self.b = np.zeros(3) self.P = np.asarray(P0, dtype=float).copy() self.accel_gate, self.mag_gate, self.reset = accel_gate, mag_gate, reset self.last_nis = np.nan
def predict(self, gyro, dt): omega = gyro - self.b dq = qexp(omega * dt) F = np.eye(6) F[:3, :3] = qrot(dq).T F[:3, 3:] = -dt * np.eye(3) Q = np.zeros((6, 6)) Q[:3, :3] = self.sg**2 * dt**2 * np.eye(3) Q[3:, 3:] = self.sbw**2 * dt * np.eye(3) self.q = qmul(self.q, dq) self.P = F @ self.P @ F.T + Q
def _inject(self, dx): dth = dx[:3] self.q = qnormalize(qmul(self.q, qexp(dth))) self.b = self.b + dx[3:] if self.reset: Gm = np.eye(6) Gm[:3, :3] -= skew(0.5 * dth) self.P = Gm @ self.P @ Gm.T
def update_accel(self, accel): """Gravity-direction update. Returns False when gated out.""" norm = np.sqrt(accel @ accel) if self.accel_gate is not None and abs(norm - G) > self.accel_gate: return False h = qrot(self.q).T @ np.array([0.0, 0.0, -1.0]) H = np.zeros((3, 6)) H[:, :3] = skew(h) y = accel / norm - h dx, self.P, S = joseph_update(self.P, H, (self.sa / G) ** 2 * np.eye(3), y) self.last_nis = float(y @ np.linalg.solve(S, y)) self._inject(dx) return True
def heading_jacobian(self): """d heading / d (dtheta) = [mx mz, my mz, -(mx^2+my^2)] / (mx^2+my^2) C(q).""" mx, my, mz = self.m_w mh2 = mx * mx + my * my return np.array([mx * mz / mh2, my * mz / mh2, -1.0]) @ qrot(self.q)
def update_mag_heading(self, mag): """Heading-only magnetometer update. Returns False when gated out.""" norm = np.sqrt(mag @ mag) if self.mag_gate is not None and abs(norm - 1.0) > self.mag_gate: return False mw = qrot(self.q) @ mag y = wrap_pi(np.arctan2(mw[1], mw[0]) - np.arctan2(self.m_w[1], self.m_w[0])) H = np.zeros((1, 6)) H[0, :3] = self.heading_jacobian() r = (self.sm / np.hypot(self.m_w[0], self.m_w[1])) ** 2 dx, self.P, S = joseph_update(self.P, H, np.array([[r]]), np.array([y])) self.last_nis = float(y * y / S[0, 0]) self._inject(dx) return True和第 5 篇的 EKF 比,几处区别:协方差是 6×6;predict 里 F[:3,:3] = qrot(dq).T 就是 ;update_accel 里 skew(h) 是 ;update_mag_heading 里 y 用 wrap_pi 折叠,H 只有一行;两种更新最后都调 _inject。joseph_update 是第 5 篇的共用函数,这里 (加速度计)和 (航向)都能用。
有限差分检查:
def jacobian_checks(): """Finite-difference checks of both measurement Jacobians, perturbing through injection.""" eps = 1e-6 worst_a = worst_m = 0.0 f = make_eskf(np.array([1.0, 0, 0, 0]), P0_NOMINAL) for i in range(100): q = np.array([np.cos(0.3 * i + 0.1), np.sin(0.7 * i), np.cos(1.1 * i), np.sin(1.9 * i + 0.5)]) f.q = q / np.linalg.norm(q) C = qrot(f.q) h = C.T @ np.array([0.0, 0.0, -1.0]) Ha, Hm = skew(h), f.heading_jacobian() Fa, Fm = np.empty((3, 3)), np.empty(3) for j in range(3): e = np.zeros(3) e[j] = eps ys = [] for s in (+1, -1): qt = qmul(f.q, qexp(s * e)) # "true" attitude after injecting +-eps za = qrot(qt).T @ np.array([0.0, 0.0, -1.0]) zm = qrot(qt).T @ MAG_W mw = C @ zm ys.append((za - h, wrap_pi(np.arctan2(mw[1], mw[0]) - np.arctan2(MAG_W[1], MAG_W[0])))) Fa[:, j] = (ys[0][0] - ys[1][0]) / (2 * eps) Fm[j] = (ys[0][1] - ys[1][1]) / (2 * eps) worst_a = max(worst_a, float(np.max(np.abs(Ha - Fa)))) worst_m = max(worst_m, float(np.max(np.abs(Hm - Fm)))) assert worst_a < 1e-6 and worst_m < 1e-6, (worst_a, worst_m) return worst_a, worst_mC、C++、Rust 实现
三种语言的结构完全对应 Python。差别和 EKF 一章类似:C 是定长数组加内联工作区(work[256]),C++ 是模板加 Mat<6,6,T>,Rust 是 Mat<6,6>、Option/let-else。
C
void kl_eskf_predict(kl_eskf *f, const kl_real gyro[3], kl_real dt){ kl_real *F = f->work, *Q = F + 36, *T = Q + 36, *U = T + 36; kl_real omega[3], dq[4], C[9], qn[4]; for (int i = 0; i < 3; i++) omega[i] = (gyro[i] - f->b[i]) * dt; kl_quat_exp(omega, dq); kl_quat_to_dcm(dq, C);
/* F = [[C(dq)^T, -dt I], [0, I]], Q = diag(sg^2 dt^2 I, sbw^2 dt I) */ kl_mat_identity(F, 6); for (int i = 0; i < 36; i++) Q[i] = 0; for (int i = 0; i < 3; i++) { for (int j = 0; j < 3; j++) F[i * 6 + j] = C[j * 3 + i]; F[i * 6 + 3 + i] = -dt; Q[i * 7] = f->sg * f->sg * dt * dt; Q[(i + 3) * 7] = f->sbw * f->sbw * dt; } kl_quat_mul(f->q, dq, qn); kl_mat_copy(qn, f->q, 4, 1); kl_mat_mul(F, f->P, T, 6, 6, 6); kl_mat_mul_bt(T, F, U, 6, 6, 6); kl_mat_add(U, Q, f->P, 6, 6);}
/* Move the error estimate into the nominal state, then reset the error to zero. */static void inject(kl_eskf *f, const kl_real dx[6]){ kl_real *G = f->work, *T = G + 36, *U = T + 36; kl_real dq[4], qn[4]; kl_quat_exp(dx, dq); kl_quat_mul(f->q, dq, qn); kl_quat_normalize(qn); kl_mat_copy(qn, f->q, 4, 1); for (int i = 0; i < 3; i++) f->b[i] += dx[3 + i]; if (f->reset) { /* G = blkdiag(I - [dtheta/2]x, I), P = G P G^T */ kl_real half[3] = {(kl_real)0.5 * dx[0], (kl_real)0.5 * dx[1], (kl_real)0.5 * dx[2]}; kl_real S[9]; kl_skew(half, S); kl_mat_identity(G, 6); for (int i = 0; i < 3; i++) for (int j = 0; j < 3; j++) G[i * 6 + j] -= S[i * 3 + j]; kl_mat_mul(G, f->P, T, 6, 6, 6); kl_mat_mul_bt(T, G, U, 6, 6, 6); kl_mat_copy(U, f->P, 6, 6); }}
int kl_eskf_update_accel(kl_eskf *f, const kl_real accel[3]){ kl_real *H = f->work, *R = H + 18, *jw = R + 9; kl_real norm = KL_SQRT(accel[0] * accel[0] + accel[1] * accel[1] + accel[2] * accel[2]); if (f->accel_gate >= 0 && KL_FABS(norm - (kl_real)KL_GRAVITY) > f->accel_gate) return 0; const kl_real down[3] = {0, 0, -1}; kl_real h[3], S[9], y[3], dx[6]; kl_ekf_att_rot_inv(f->q, down, h); /* C(q)^T [0,0,-1] for unit q */ kl_skew(h, S); /* H = [[h]x | 0] */ for (int i = 0; i < 3; i++) for (int j = 0; j < 6; j++) H[i * 6 + j] = j < 3 ? S[i * 3 + j] : 0; kl_real r = (f->sa / (kl_real)KL_GRAVITY) * (f->sa / (kl_real)KL_GRAVITY); for (int i = 0; i < 3; i++) { y[i] = accel[i] / norm - h[i]; for (int j = 0; j < 3; j++) R[i * 3 + j] = (i == j) ? r : 0; } if (kl_joseph_update(f->P, H, R, y, 6, 3, dx, NULL, jw) != 0) return -1; inject(f, dx); return 1;}
void kl_eskf_heading_jacobian(const kl_eskf *f, kl_real H[3]){ kl_real mx = f->m_w[0], my = f->m_w[1], mz = f->m_w[2], C[9]; kl_real mh2 = mx * mx + my * my; kl_real v[3] = {mx * mz / mh2, my * mz / mh2, -1}; kl_quat_to_dcm(f->q, C); for (int j = 0; j < 3; j++) H[j] = v[0] * C[j] + v[1] * C[3 + j] + v[2] * C[6 + j];}
int kl_eskf_update_mag_heading(kl_eskf *f, const kl_real mag[3]){ kl_real *H = f->work, *R = H + 6, *jw = R + 1; kl_real norm = KL_SQRT(mag[0] * mag[0] + mag[1] * mag[1] + mag[2] * mag[2]); if (f->mag_gate >= 0 && KL_FABS(norm - 1) > f->mag_gate) return 0; kl_real C[9], mw[3], y, dx[6]; kl_quat_to_dcm(f->q, C); kl_mat_mul(C, mag, mw, 3, 3, 1); y = kl_wrap_pi(KL_ATAN2(mw[1], mw[0]) - KL_ATAN2(f->m_w[1], f->m_w[0])); kl_eskf_heading_jacobian(f, H); for (int j = 3; j < 6; j++) H[j] = 0; kl_real mh = KL_SQRT(f->m_w[0] * f->m_w[0] + f->m_w[1] * f->m_w[1]); R[0] = (f->sm / mh) * (f->sm / mh); if (kl_joseph_update(f->P, H, R, &y, 6, 1, dx, NULL, jw) != 0) return -1; inject(f, dx); return 1;}kl_eskf_update_accel 里 H 是 、R 是 ,kl_eskf_update_mag_heading 里 H 是 、R 是 :都调同一个 kl_joseph_update,维度作为参数传。注入函数 inject 里 和临时矩阵共用工作区 f->work(用完 update_* 里的 、 之后才用到,所以不冲突)。
C++
void predict(const Vec3<T>& gyro, T dt) { const Quat<T> dq = Quat<T>::exp((gyro - b) * dt); const Mat<3, 3, T> Ct = dq.dcm().transpose(); Mat<6, 6, T> F = Mat<6, 6, T>::identity(); Mat<6, 6, T> Q{}; for (std::size_t i = 0; i < 3; i++) { for (std::size_t j = 0; j < 3; j++) F(i, j) = Ct(i, j); F(i, 3 + i) = -dt; Q(i, i) = sg * sg * dt * dt; Q(3 + i, 3 + i) = sbw * sbw * dt; } q = q * dq; // not normalized here P = F * P * F.transpose() + Q; }
// Gravity-direction update. Returns false when gated out or when S is not // positive definite (state unchanged in both cases). bool update_accel(const Vec3<T>& accel) { const T norm = std::sqrt(dot(accel, accel)); if (accel_gate >= 0 && std::fabs(norm - T(GRAVITY)) > accel_gate) return false; const Vec3<T> h = q.dcm().transpose() * Vec3<T>{{0, 0, -1}}; Mat<3, 6, T> H{}; const Mat<3, 3, T> Sh = skew(h); for (std::size_t i = 0; i < 3; i++) for (std::size_t j = 0; j < 3; j++) H(i, j) = Sh(i, j); const T r = (sa / T(GRAVITY)) * (sa / T(GRAVITY)); return correct(H, Mat<3, 3, T>::identity() * r, accel * (1 / norm) - h); }
// d heading / d dtheta = [mx mz, my mz, -(mx^2+my^2)] / (mx^2+my^2) C(q). Mat<1, 3, T> heading_jacobian() const { const T mx = m_w(0, 0), my = m_w(1, 0), mz = m_w(2, 0), mh2 = mx * mx + my * my; return Mat<1, 3, T>{{mx * mz / mh2, my * mz / mh2, T(-1)}} * q.dcm(); }
// Heading-only magnetometer update. Returns false when gated out or when S is // not positive definite (state unchanged in both cases). bool update_mag_heading(const Vec3<T>& mag) { const T norm = std::sqrt(dot(mag, mag)); if (mag_gate >= 0 && std::fabs(norm - 1) > mag_gate) return false; const Vec3<T> mw = q.dcm() * mag; const Mat<1, 1, T> y{{wrap_pi(std::atan2(mw(1, 0), mw(0, 0)) - std::atan2(m_w(1, 0), m_w(0, 0)))}}; Mat<1, 6, T> H{}; const Mat<1, 3, T> Hp = heading_jacobian(); for (std::size_t j = 0; j < 3; j++) H(0, j) = Hp(0, j); const T r = sm / std::hypot(m_w(0, 0), m_w(1, 0)); return correct(H, Mat<1, 1, T>{{r * r}}, y); }
private: template <std::size_t M> bool correct(const Mat<M, 6, T>& H, const Mat<M, M, T>& R, const Mat<M, 1, T>& y) { Mat<6, 1, T> dx; if (!joseph_update(P, H, R, y, dx)) return false; inject(dx); return true; }
// q <- q (x) exp(dtheta), b <- b + db, then reset P <- G P G^T. void inject(const Mat<6, 1, T>& dx) { const Vec3<T> dth{{dx(0, 0), dx(1, 0), dx(2, 0)}}; q = (q * Quat<T>::exp(dth)).normalized(); b = b + Vec3<T>{{dx(3, 0), dx(4, 0), dx(5, 0)}}; if (reset) { Mat<6, 6, T> G = Mat<6, 6, T>::identity(); const Mat<3, 3, T> S = skew(dth * T(0.5)); for (std::size_t i = 0; i < 3; i++) for (std::size_t j = 0; j < 3; j++) G(i, j) -= S(i, j); P = G * P * G.transpose(); } }correct 是个模板函数,M 由 H 的行数推断:加速度计 M = 3,航向 M = 1,同一份代码,不同维度,编译器各生成一份。这是 C++ 版比 C 版舒服的地方:不需要在参数里传维度,也不可能传错。
Rust
pub fn predict(&mut self, gyro: [Real; 3], dt: Real) { let w = [ gyro[0] - self.b[0], gyro[1] - self.b[1], gyro[2] - self.b[2], ]; let dq = Quat::exp([w[0] * dt, w[1] * dt, w[2] * dt]); let ct = dq.dcm().transpose(); let mut f = Mat::<6, 6>::identity(); let mut q = Mat::<6, 6>::zeros(); for i in 0..3 { for j in 0..3 { f.m[i][j] = ct.m[i][j]; } f.m[i][3 + i] = -dt; q.m[i][i] = self.sg * self.sg * (dt * dt); q.m[3 + i][3 + i] = self.sbw * self.sbw * dt; } self.q = self.q * dq; self.p = f * self.p * f.transpose() + q; }
/// Fold the error state into the nominal state, then reset the error to zero. fn inject(&mut self, dx: &Mat<6, 1>) { let dth = [dx.m[0][0], dx.m[1][0], dx.m[2][0]]; self.q = (self.q * Quat::exp(dth)).normalized(); for i in 0..3 { self.b[i] += dx.m[3 + i][0]; } if self.reset { let s = skew([0.5 * dth[0], 0.5 * dth[1], 0.5 * dth[2]]); let mut g = Mat::<6, 6>::identity(); for i in 0..3 { for j in 0..3 { g.m[i][j] -= s.m[i][j]; } } self.p = g * self.p * g.transpose(); } }
/// Gravity-direction update. Returns false when gated out or on Cholesky failure. pub fn update_accel(&mut self, accel: [Real; 3]) -> bool { let norm = sqrt(accel[0] * accel[0] + accel[1] * accel[1] + accel[2] * accel[2]); if self.accel_gate >= 0.0 && fabs(norm - G) > self.accel_gate { return false; } // h = C(q)^T [0, 0, -1] let c = self.q.dcm(); let h = [-c.m[2][0], -c.m[2][1], -c.m[2][2]]; let mut hm = Mat::<3, 6>::zeros(); let s = skew(h); for i in 0..3 { hm.m[i][..3].copy_from_slice(&s.m[i]); } let y = Mat { m: [ [accel[0] / norm - h[0]], [accel[1] / norm - h[1]], [accel[2] / norm - h[2]], ], }; let r = Mat::<3, 3>::identity() * ((self.sa / G) * (self.sa / G)); let Some((dx, _)) = joseph_update(&mut self.p, &hm, &r, &y) else { return false; }; self.inject(&dx); true }
/// d heading / d dtheta = [mx mz, my mz, -(mx^2 + my^2)] / (mx^2 + my^2) C(q). pub fn heading_jacobian(&self) -> [Real; 3] { let [mx, my, mz] = self.m_w; let mh2 = mx * mx + my * my; let row = [mx * mz / mh2, my * mz / mh2, -1.0]; let c = self.q.dcm(); let mut j = [0.0; 3]; for (k, jk) in j.iter_mut().enumerate() { *jk = row[0] * c.m[0][k] + row[1] * c.m[1][k] + row[2] * c.m[2][k]; } j }
/// Heading-only magnetometer update. Returns false when gated out or on Cholesky failure. pub fn update_mag_heading(&mut self, mag: [Real; 3]) -> bool { let norm = sqrt(mag[0] * mag[0] + mag[1] * mag[1] + mag[2] * mag[2]); if self.mag_gate >= 0.0 && fabs(norm - 1.0) > self.mag_gate { return false; } // Rotate the measurement to the world frame and compare headings. let c = self.q.dcm(); let mw = |i: usize| c.m[i][0] * mag[0] + c.m[i][1] * mag[1] + c.m[i][2] * mag[2]; let y = wrap_pi(atan2(mw(1), mw(0)) - atan2(self.m_w[1], self.m_w[0])); let mut h = Mat::<1, 6>::zeros(); h.m[0][..3].copy_from_slice(&self.heading_jacobian()); let mh = sqrt(self.m_w[0] * self.m_w[0] + self.m_w[1] * self.m_w[1]); let r = Mat { m: [[(self.sm / mh) * (self.sm / mh)]], }; let Some((dx, _)) = joseph_update(&mut self.p, &h, &r, &Mat { m: [[y]] }) else { return false; }; self.inject(&dx); true }update_mag_heading 里 mw 是个闭包,只在需要的时候计算世界系航向的两个分量,没有给一个完整向量起名字。
完整源码:c/include/kl/kl_eskf.h、c/src/kl_eskf.c
/* Error-state (multiplicative) Kalman filter for attitude, after Sola (2017). * Nominal state: q, b. Error state: [dtheta (3), db (3)] with q_true = q (x) exp(dtheta), * b_true = b + db. P is 6x6 and always full rank. Quaternion conventions: see kl_quat.h. * All storage is inline; nothing is allocated. */#ifndef KL_ESKF_H#define KL_ESKF_H
#include "kl/kl_real.h"
typedef struct { kl_real q[4], b[3], P[36]; kl_real sg, sbw, sa, sm; /* gyro, bias random walk, accel, mag noise */ kl_real m_w[3]; kl_real accel_gate, mag_gate; /* negative disables the gate */ int reset; /* apply the reset Jacobian after injection */ kl_real work[256];} kl_eskf;
/* p0_diag: initial diagonal of P (6). The bias starts at zero. */void kl_eskf_init(kl_eskf *f, const kl_real q0[4], const kl_real p0_diag[6], kl_real sigma_g, kl_real sigma_bw, kl_real sigma_a, kl_real sigma_m, const kl_real m_w[3], kl_real accel_gate, kl_real mag_gate, int reset);void kl_eskf_predict(kl_eskf *f, const kl_real gyro[3], kl_real dt);/* Return 1 if applied, 0 if gated out, -1 on Cholesky failure (state unchanged). */int kl_eskf_update_accel(kl_eskf *f, const kl_real accel[3]);/* d heading / d dtheta = [mx mz, my mz, -(mx^2+my^2)] / (mx^2+my^2) C(q) */void kl_eskf_heading_jacobian(const kl_eskf *f, kl_real H[3]);/* Heading-only magnetometer update; same return convention. */int kl_eskf_update_mag_heading(kl_eskf *f, const kl_real mag[3]);/* Wrap an angle to [-pi, pi). */kl_real kl_wrap_pi(kl_real a);
#endif#include "kl/kl_eskf.h"
#include <stddef.h>
#include "kl/kl_ekf_att.h"#include "kl/kl_mat.h"#include "kl/kl_quat.h"#include "kl/kl_update.h"
#define PI ((kl_real)3.14159265358979323846)
#ifdef KL_USE_FLOAT#define KL_FMOD fmodf /* fmod would drag soft-double code into a Cortex-M4F build */#else#define KL_FMOD fmod#endif
kl_real kl_wrap_pi(kl_real a){ kl_real r = KL_FMOD(a + PI, 2 * PI); if (r < 0) r += 2 * PI; return r - PI;}
void kl_eskf_init(kl_eskf *f, const kl_real q0[4], const kl_real p0_diag[6], kl_real sigma_g, kl_real sigma_bw, kl_real sigma_a, kl_real sigma_m, const kl_real m_w[3], kl_real accel_gate, kl_real mag_gate, int reset){ kl_mat_copy(q0, f->q, 4, 1); kl_mat_copy(m_w, f->m_w, 3, 1); for (int i = 0; i < 3; i++) f->b[i] = 0; for (int i = 0; i < 36; i++) f->P[i] = 0; for (int i = 0; i < 6; i++) f->P[i * 7] = p0_diag[i]; f->sg = sigma_g; f->sbw = sigma_bw; f->sa = sigma_a; f->sm = sigma_m; f->accel_gate = accel_gate; f->mag_gate = mag_gate; f->reset = reset;}
void kl_eskf_predict(kl_eskf *f, const kl_real gyro[3], kl_real dt){ kl_real *F = f->work, *Q = F + 36, *T = Q + 36, *U = T + 36; kl_real omega[3], dq[4], C[9], qn[4]; for (int i = 0; i < 3; i++) omega[i] = (gyro[i] - f->b[i]) * dt; kl_quat_exp(omega, dq); kl_quat_to_dcm(dq, C);
/* F = [[C(dq)^T, -dt I], [0, I]], Q = diag(sg^2 dt^2 I, sbw^2 dt I) */ kl_mat_identity(F, 6); for (int i = 0; i < 36; i++) Q[i] = 0; for (int i = 0; i < 3; i++) { for (int j = 0; j < 3; j++) F[i * 6 + j] = C[j * 3 + i]; F[i * 6 + 3 + i] = -dt; Q[i * 7] = f->sg * f->sg * dt * dt; Q[(i + 3) * 7] = f->sbw * f->sbw * dt; } kl_quat_mul(f->q, dq, qn); kl_mat_copy(qn, f->q, 4, 1); kl_mat_mul(F, f->P, T, 6, 6, 6); kl_mat_mul_bt(T, F, U, 6, 6, 6); kl_mat_add(U, Q, f->P, 6, 6);}
/* Move the error estimate into the nominal state, then reset the error to zero. */static void inject(kl_eskf *f, const kl_real dx[6]){ kl_real *G = f->work, *T = G + 36, *U = T + 36; kl_real dq[4], qn[4]; kl_quat_exp(dx, dq); kl_quat_mul(f->q, dq, qn); kl_quat_normalize(qn); kl_mat_copy(qn, f->q, 4, 1); for (int i = 0; i < 3; i++) f->b[i] += dx[3 + i]; if (f->reset) { /* G = blkdiag(I - [dtheta/2]x, I), P = G P G^T */ kl_real half[3] = {(kl_real)0.5 * dx[0], (kl_real)0.5 * dx[1], (kl_real)0.5 * dx[2]}; kl_real S[9]; kl_skew(half, S); kl_mat_identity(G, 6); for (int i = 0; i < 3; i++) for (int j = 0; j < 3; j++) G[i * 6 + j] -= S[i * 3 + j]; kl_mat_mul(G, f->P, T, 6, 6, 6); kl_mat_mul_bt(T, G, U, 6, 6, 6); kl_mat_copy(U, f->P, 6, 6); }}
int kl_eskf_update_accel(kl_eskf *f, const kl_real accel[3]){ kl_real *H = f->work, *R = H + 18, *jw = R + 9; kl_real norm = KL_SQRT(accel[0] * accel[0] + accel[1] * accel[1] + accel[2] * accel[2]); if (f->accel_gate >= 0 && KL_FABS(norm - (kl_real)KL_GRAVITY) > f->accel_gate) return 0; const kl_real down[3] = {0, 0, -1}; kl_real h[3], S[9], y[3], dx[6]; kl_ekf_att_rot_inv(f->q, down, h); /* C(q)^T [0,0,-1] for unit q */ kl_skew(h, S); /* H = [[h]x | 0] */ for (int i = 0; i < 3; i++) for (int j = 0; j < 6; j++) H[i * 6 + j] = j < 3 ? S[i * 3 + j] : 0; kl_real r = (f->sa / (kl_real)KL_GRAVITY) * (f->sa / (kl_real)KL_GRAVITY); for (int i = 0; i < 3; i++) { y[i] = accel[i] / norm - h[i]; for (int j = 0; j < 3; j++) R[i * 3 + j] = (i == j) ? r : 0; } if (kl_joseph_update(f->P, H, R, y, 6, 3, dx, NULL, jw) != 0) return -1; inject(f, dx); return 1;}
void kl_eskf_heading_jacobian(const kl_eskf *f, kl_real H[3]){ kl_real mx = f->m_w[0], my = f->m_w[1], mz = f->m_w[2], C[9]; kl_real mh2 = mx * mx + my * my; kl_real v[3] = {mx * mz / mh2, my * mz / mh2, -1}; kl_quat_to_dcm(f->q, C); for (int j = 0; j < 3; j++) H[j] = v[0] * C[j] + v[1] * C[3 + j] + v[2] * C[6 + j];}
int kl_eskf_update_mag_heading(kl_eskf *f, const kl_real mag[3]){ kl_real *H = f->work, *R = H + 6, *jw = R + 1; kl_real norm = KL_SQRT(mag[0] * mag[0] + mag[1] * mag[1] + mag[2] * mag[2]); if (f->mag_gate >= 0 && KL_FABS(norm - 1) > f->mag_gate) return 0; kl_real C[9], mw[3], y, dx[6]; kl_quat_to_dcm(f->q, C); kl_mat_mul(C, mag, mw, 3, 3, 1); y = kl_wrap_pi(KL_ATAN2(mw[1], mw[0]) - KL_ATAN2(f->m_w[1], f->m_w[0])); kl_eskf_heading_jacobian(f, H); for (int j = 3; j < 6; j++) H[j] = 0; kl_real mh = KL_SQRT(f->m_w[0] * f->m_w[0] + f->m_w[1] * f->m_w[1]); R[0] = (f->sm / mh) * (f->sm / mh); if (kl_joseph_update(f->P, H, R, &y, 6, 1, dx, NULL, jw) != 0) return -1; inject(f, dx); return 1;}完整源码:cpp/include/kl/eskf.hpp
// Error-state (multiplicative) Kalman filter for attitude, after Sola (2017).// Nominal state: q, b. Error state: [dtheta (3), db (3)] with// q_true = q (x) exp(dtheta), b_true = b + db. P is 6x6 and always full rank.#pragma once#include "kl/ekf_attitude.hpp"
namespace kl {
// Wraps an angle to [-pi, pi).template <class T>T wrap_pi(T a) { const T two_pi = T(2 * 3.14159265358979323846); T m = std::fmod(a + T(3.14159265358979323846), two_pi); if (m < 0) m += two_pi; return m - T(3.14159265358979323846);}
template <class T = double>class ESKF {public: Quat<T> q; Vec3<T> b{}; Mat<6, 6, T> P{}; T sg, sbw, sa, sm; Vec3<T> m_w; T accel_gate, mag_gate; // negative disables the gate bool reset;
ESKF(T sigma_g, T sigma_bw, T sigma_a, T sigma_m, const Vec3<T>& m_w, const Quat<T>& q0, const Mat<6, 6, T>& P0, T accel_gate = T(0.5), T mag_gate = T(0.1), bool reset = true) : q(q0), P(P0), sg(sigma_g), sbw(sigma_bw), sa(sigma_a), sm(sigma_m), m_w(m_w), accel_gate(accel_gate), mag_gate(mag_gate), reset(reset) {}
void predict(const Vec3<T>& gyro, T dt) { const Quat<T> dq = Quat<T>::exp((gyro - b) * dt); const Mat<3, 3, T> Ct = dq.dcm().transpose(); Mat<6, 6, T> F = Mat<6, 6, T>::identity(); Mat<6, 6, T> Q{}; for (std::size_t i = 0; i < 3; i++) { for (std::size_t j = 0; j < 3; j++) F(i, j) = Ct(i, j); F(i, 3 + i) = -dt; Q(i, i) = sg * sg * dt * dt; Q(3 + i, 3 + i) = sbw * sbw * dt; } q = q * dq; // not normalized here P = F * P * F.transpose() + Q; }
// Gravity-direction update. Returns false when gated out or when S is not // positive definite (state unchanged in both cases). bool update_accel(const Vec3<T>& accel) { const T norm = std::sqrt(dot(accel, accel)); if (accel_gate >= 0 && std::fabs(norm - T(GRAVITY)) > accel_gate) return false; const Vec3<T> h = q.dcm().transpose() * Vec3<T>{{0, 0, -1}}; Mat<3, 6, T> H{}; const Mat<3, 3, T> Sh = skew(h); for (std::size_t i = 0; i < 3; i++) for (std::size_t j = 0; j < 3; j++) H(i, j) = Sh(i, j); const T r = (sa / T(GRAVITY)) * (sa / T(GRAVITY)); return correct(H, Mat<3, 3, T>::identity() * r, accel * (1 / norm) - h); }
// d heading / d dtheta = [mx mz, my mz, -(mx^2+my^2)] / (mx^2+my^2) C(q). Mat<1, 3, T> heading_jacobian() const { const T mx = m_w(0, 0), my = m_w(1, 0), mz = m_w(2, 0), mh2 = mx * mx + my * my; return Mat<1, 3, T>{{mx * mz / mh2, my * mz / mh2, T(-1)}} * q.dcm(); }
// Heading-only magnetometer update. Returns false when gated out or when S is // not positive definite (state unchanged in both cases). bool update_mag_heading(const Vec3<T>& mag) { const T norm = std::sqrt(dot(mag, mag)); if (mag_gate >= 0 && std::fabs(norm - 1) > mag_gate) return false; const Vec3<T> mw = q.dcm() * mag; const Mat<1, 1, T> y{{wrap_pi(std::atan2(mw(1, 0), mw(0, 0)) - std::atan2(m_w(1, 0), m_w(0, 0)))}}; Mat<1, 6, T> H{}; const Mat<1, 3, T> Hp = heading_jacobian(); for (std::size_t j = 0; j < 3; j++) H(0, j) = Hp(0, j); const T r = sm / std::hypot(m_w(0, 0), m_w(1, 0)); return correct(H, Mat<1, 1, T>{{r * r}}, y); }
private: template <std::size_t M> bool correct(const Mat<M, 6, T>& H, const Mat<M, M, T>& R, const Mat<M, 1, T>& y) { Mat<6, 1, T> dx; if (!joseph_update(P, H, R, y, dx)) return false; inject(dx); return true; }
// q <- q (x) exp(dtheta), b <- b + db, then reset P <- G P G^T. void inject(const Mat<6, 1, T>& dx) { const Vec3<T> dth{{dx(0, 0), dx(1, 0), dx(2, 0)}}; q = (q * Quat<T>::exp(dth)).normalized(); b = b + Vec3<T>{{dx(3, 0), dx(4, 0), dx(5, 0)}}; if (reset) { Mat<6, 6, T> G = Mat<6, 6, T>::identity(); const Mat<3, 3, T> S = skew(dth * T(0.5)); for (std::size_t i = 0; i < 3; i++) for (std::size_t j = 0; j < 3; j++) G(i, j) -= S(i, j); P = G * P * G.transpose(); } }};
} // namespace kl完整源码:rust/src/eskf.rs
//! Error-state (multiplicative) Kalman filter for attitude, after Sola (2017).//!//! Nominal state q, b. Error state [dtheta (3), db (3)] with//! q_true = q (x) exp(dtheta), b_true = b + db. P is 6x6 and stays full rank.
use crate::ekf_att::G;use crate::mat::Mat;use crate::quat::{Quat, skew};use crate::real::{Real, atan2, fabs, sqrt};use crate::update::joseph_update;
const PI: Real = core::f64::consts::PI as Real;
/// Wrap an angle to [-pi, pi).pub fn wrap_pi(a: Real) -> Real { let mut r = (a + PI) % (2.0 * PI); if r < 0.0 { r += 2.0 * PI; } r - PI}
pub struct Eskf { pub q: Quat, pub b: [Real; 3], pub p: Mat<6, 6>, pub sg: Real, pub sbw: Real, pub sa: Real, pub sm: Real, pub m_w: [Real; 3], /// Gates on | |f| - g | (m/s^2) and | |m| - 1 |; negative disables gating. pub accel_gate: Real, pub mag_gate: Real, /// Apply the reset Jacobian P <- G P G^T after each injection. pub reset: bool,}
impl Eskf { #[allow(clippy::too_many_arguments)] pub fn new( q0: Quat, p0_diag: [Real; 6], sigma_g: Real, sigma_bw: Real, sigma_a: Real, sigma_m: Real, m_w: [Real; 3], accel_gate: Real, mag_gate: Real, reset: bool, ) -> Self { let mut p = Mat::zeros(); for (i, d) in p0_diag.iter().enumerate() { p.m[i][i] = *d; } Self { q: q0, b: [0.0; 3], p, sg: sigma_g, sbw: sigma_bw, sa: sigma_a, sm: sigma_m, m_w, accel_gate, mag_gate, reset, } }
pub fn predict(&mut self, gyro: [Real; 3], dt: Real) { let w = [ gyro[0] - self.b[0], gyro[1] - self.b[1], gyro[2] - self.b[2], ]; let dq = Quat::exp([w[0] * dt, w[1] * dt, w[2] * dt]); let ct = dq.dcm().transpose(); let mut f = Mat::<6, 6>::identity(); let mut q = Mat::<6, 6>::zeros(); for i in 0..3 { for j in 0..3 { f.m[i][j] = ct.m[i][j]; } f.m[i][3 + i] = -dt; q.m[i][i] = self.sg * self.sg * (dt * dt); q.m[3 + i][3 + i] = self.sbw * self.sbw * dt; } self.q = self.q * dq; self.p = f * self.p * f.transpose() + q; }
/// Fold the error state into the nominal state, then reset the error to zero. fn inject(&mut self, dx: &Mat<6, 1>) { let dth = [dx.m[0][0], dx.m[1][0], dx.m[2][0]]; self.q = (self.q * Quat::exp(dth)).normalized(); for i in 0..3 { self.b[i] += dx.m[3 + i][0]; } if self.reset { let s = skew([0.5 * dth[0], 0.5 * dth[1], 0.5 * dth[2]]); let mut g = Mat::<6, 6>::identity(); for i in 0..3 { for j in 0..3 { g.m[i][j] -= s.m[i][j]; } } self.p = g * self.p * g.transpose(); } }
/// Gravity-direction update. Returns false when gated out or on Cholesky failure. pub fn update_accel(&mut self, accel: [Real; 3]) -> bool { let norm = sqrt(accel[0] * accel[0] + accel[1] * accel[1] + accel[2] * accel[2]); if self.accel_gate >= 0.0 && fabs(norm - G) > self.accel_gate { return false; } // h = C(q)^T [0, 0, -1] let c = self.q.dcm(); let h = [-c.m[2][0], -c.m[2][1], -c.m[2][2]]; let mut hm = Mat::<3, 6>::zeros(); let s = skew(h); for i in 0..3 { hm.m[i][..3].copy_from_slice(&s.m[i]); } let y = Mat { m: [ [accel[0] / norm - h[0]], [accel[1] / norm - h[1]], [accel[2] / norm - h[2]], ], }; let r = Mat::<3, 3>::identity() * ((self.sa / G) * (self.sa / G)); let Some((dx, _)) = joseph_update(&mut self.p, &hm, &r, &y) else { return false; }; self.inject(&dx); true }
/// d heading / d dtheta = [mx mz, my mz, -(mx^2 + my^2)] / (mx^2 + my^2) C(q). pub fn heading_jacobian(&self) -> [Real; 3] { let [mx, my, mz] = self.m_w; let mh2 = mx * mx + my * my; let row = [mx * mz / mh2, my * mz / mh2, -1.0]; let c = self.q.dcm(); let mut j = [0.0; 3]; for (k, jk) in j.iter_mut().enumerate() { *jk = row[0] * c.m[0][k] + row[1] * c.m[1][k] + row[2] * c.m[2][k]; } j }
/// Heading-only magnetometer update. Returns false when gated out or on Cholesky failure. pub fn update_mag_heading(&mut self, mag: [Real; 3]) -> bool { let norm = sqrt(mag[0] * mag[0] + mag[1] * mag[1] + mag[2] * mag[2]); if self.mag_gate >= 0.0 && fabs(norm - 1.0) > self.mag_gate { return false; } // Rotate the measurement to the world frame and compare headings. let c = self.q.dcm(); let mw = |i: usize| c.m[i][0] * mag[0] + c.m[i][1] * mag[1] + c.m[i][2] * mag[2]; let y = wrap_pi(atan2(mw(1), mw(0)) - atan2(self.m_w[1], self.m_w[0])); let mut h = Mat::<1, 6>::zeros(); h.m[0][..3].copy_from_slice(&self.heading_jacobian()); let mh = sqrt(self.m_w[0] * self.m_w[0] + self.m_w[1] * self.m_w[1]); let r = Mat { m: [[(self.sm / mh) * (self.sm / mh)]], }; let Some((dx, _)) = joseph_update(&mut self.p, &h, &r, &Mat { m: [[y]] }) else { return false; }; self.inject(&dx); true }}三个 app(c/apps/ch06.c、cpp/apps/ch06.cpp、rust/src/bin/ch06.rs)先做上面的有限差分检查,再处理两个初始条件:正常(TRIAD)和大误差(TRIAD 绕世界 轴转 90 度,)。
结果
$ make -s ch06H checks: max|H_accel - fd| = 3.04e-10, max|H_heading - fd| = 4.73e-10H checks: max|H_accel - fd| = 3.04e-10, max|H_heading - fd| = 4.73e-10jacobian check: max|H_acc - fd| = 3.041e-10, max|H_mag - fd| = 4.729e-10Jacobian checks: max|H_acc - fd| = 3.04e-10, max|H_mag - fd| = 4.73e-10ok eskf_large_c.csv: max diff 7.216e-16 <= 1.0e-09ok eskf_large_cpp.csv: max diff 9.992e-16 <= 1.0e-09ok eskf_large_rs.csv: max diff 1.187e-15 <= 1.0e-09ok eskf_nominal_c.csv: max diff 7.494e-16 <= 1.0e-09ok eskf_nominal_cpp.csv: max diff 8.882e-16 <= 1.0e-09ok eskf_nominal_rs.csv: max diff 7.442e-16 <= 1.0e-09(其余输出在下面的各小节里引用)三种语言的有限差分检查打印同样的最大误差,滤波输出和 Python 的最大差异都是 量级。
对 EKF:功劳该记在谁头上
先是表格里的前三行:
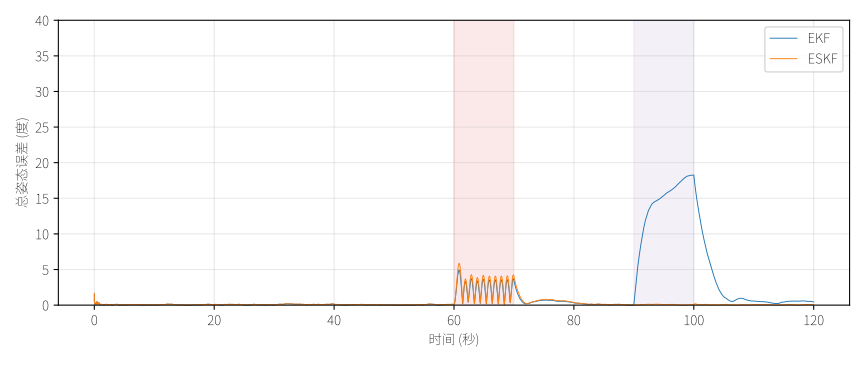
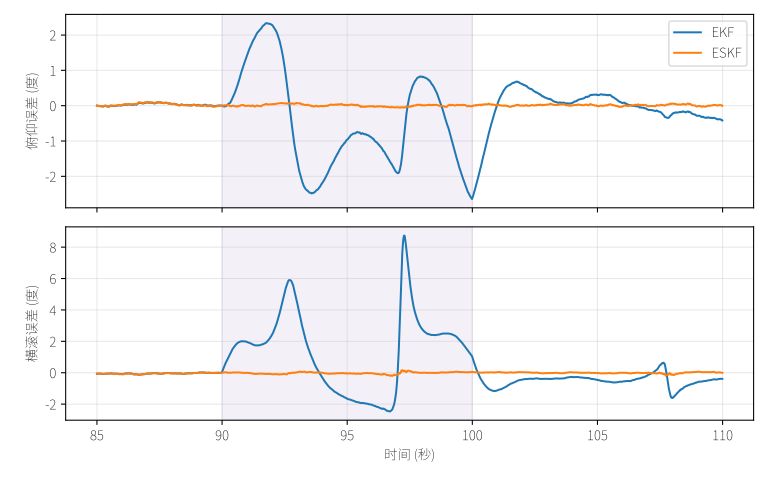
method yaw pitch roll totalekf 4.504 0.684 1.127 4.719ekf+gate 0.524 0.506 0.746 0.804eskf 0.608 0.591 0.870 0.932ekf+gate 是第 5 篇的 EKF,只加了一行:磁力计样本模长偏离 1 超过 0.1 就不更新。它比 ESKF 还略好(0.804 对 0.932 度)。磁干扰窗口内的横滚俯仰也一样:EKF 不设门是 3.214 度,加门是 0.068 度,ESKF 是 0.070 度。这一整段 1000 个样本全部被门挡住(磁干扰期间模长约 1.25),对 EKF 和 ESKF 一视同仁。
结论:磁干扰段的巨大改善来自”不用坏数据”,不来自误差状态也不来自航向更新。 反过来,这个对照也说明了航向更新没有害处:它在干净数据上不比三维向量更新差(平静段 EKF 0.086、ESKF 0.088 度)。ESKF 在线加速度段比 EKF 差一点(3.054 对 2.640 度),我没有深究原因。
ESKF 的好处在哪
在这份数据上我能找到的好处有这些:
- 满秩协方差。 没有多余自由度,没有”沿 方向”的幽灵特征值。状态少一维,协方差矩阵 个元素,每步的矩阵运算也就少一些,第 8 篇会量化。
- 每一项的物理意义清楚。 误差是 3 维旋转向量; 的形式简单,比 EKF 里 的对四元数的雅可比好检查好调试。
- 一致性。 平静段的 NEES 落在界内(见下)。
大初始误差:和我预期的不一样
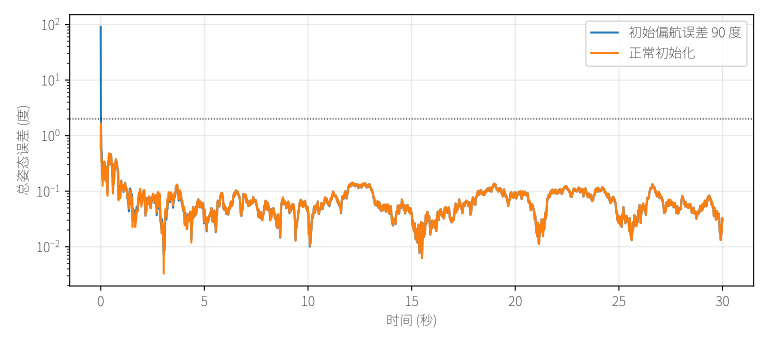
large initial error, ESKF: initial error 90.4 deg; first time the error stays below 2 deg for 5 s: 0.02 s (nominal init: 0.00 s) 90 deg yaw : initial 90.4 deg | ESKF converged at 0.02 s, EKF at 1.18 s (error at 10 s: ESKF 0.04, EKF 0.05 deg) 120 deg about world [1,1,0] : initial 120.3 deg | ESKF converged at 0.86 s, EKF at 0.01 s (error at 10 s: ESKF 0.18, EKF 0.04 deg)我原本预期”EKF 在大误差下线性化会失效,ESKF 更稳”。数据说不是。90 度的偏航误差,ESKF 在 0.02 秒内就收敛了(第一个样本之后误差降到 2 度以内并保持),EKF 要 1.18 秒。道理是这个误差恰好是绕世界竖直轴的纯旋转,加速度计更新先把横滚俯仰锁死( 在这两个方向塌缩),剩下的不确定方向就是纯偏航,航向测量对偏航误差是精确线性的,一次更新就修正了。换成一个 120 度、绕世界 的误差(横滚俯仰偏航都错),结果反转了:ESKF 要 0.86 秒,EKF 0.01 秒,10 秒时误差也是 EKF 略好(0.04 对 0.18 度)。EKF 的优势我猜是它的磁力计更新用的是整个 3 维向量,一次就同时给出了横滚俯仰偏航的信息;ESKF 的航向更新只给一个标量,得靠加速度计更新和航向更新交替几轮才把三个方向都拉回来。
所以:这份数据上没有证据表明 ESKF 在大初始误差下比 EKF 更好。 我不知道其他类型的初始误差(或更苛刻的噪声)下会怎样,这个结论只对上面两种初始误差成立。
重置雅可比
reset Jacobian: total RMSE with 0.93200 deg, without 0.93160 deg relative change of the P diagonal: max over the run 5.20e-02, max for t >= 5 s 5.20e-02重置雅可比 对精度的影响是 0.0004 度,可以忽略。对协方差的影响就不能说是微乎其微了,两次运行(带重置和不带重置)的 对角元之间,最大的相对差异是 5.2%,出现在 61.75 秒,也就是线加速度扰动里,加速度计的错误数据让估计出现了较大的跳变, 大, 离 就远。其余大部分时刻这个相对差异在 到 量级(1 秒时 0.13%,50 秒时 0.015%,100 秒时 0.027%)。我保留 reset=True,因为它在大注入的时候有影响,小注入时没有副作用。
一致性:蒙特卡洛 NEES
Monte Carlo, seeds 1..50, 6-dof NEES bounds [5.078, 6.997] mean NEES over the whole run: 895.576; fraction of steps inside the bounds: 67.2% calm period [20,60): mean NEES 6.048, inside 96.0% excluding [60,80) (accel disturbance and its aftermath): mean NEES 9.616, inside 80.6% accel disturbance [60,70): mean NEES 9399.926; mag disturbance [90,100): 7.179 total error RMS over 50 runs: 0.929 deg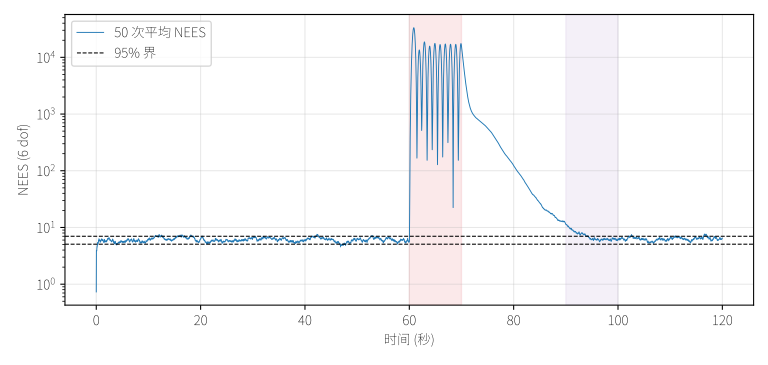
全程只有 67.2% 的步落在界内,低于我给自己设的 80%。但是平静段 是 96.0%,平均 NEES 6.048,几乎正好是 6(自由度)。滤波器的噪声参数在没有干扰时是准的。失败的部分是线加速度扰动:它没有被门控挡住(第 5 篇讲过原因),也不在滤波器的模型里,加速度计把水平加速度当成了重力方向的偏转,NEES 在那 10 秒里是 9400。
常规的补救办法是重新调滤波器的 、。我试了,但这不是对症的药(python3 python/ch06_eskf.py tune,大约 5 分钟,不在 make ch06 里):
$ python3 python/ch06_eskf.py tune6-dof NEES bounds [5.078, 6.997]; fraction of steps inside the bounds, 50 runsfilter noise mean NEES whole run excl [60,80) calm [20,60)as simulated 895.58 67.2% 80.6% 96.0%sigma_g x2 1099.03 6.9% 8.3% 0.0%sigma_bw x5 1334.00 2.7% 2.3% 0.0%sigma_a x3 60.80 10.7% 12.7% 6.2%sigma_a x10 6.86 8.3% 8.6% 2.9%把陀螺噪声放大 2 倍或者把零偏随机游走放大 5 倍,平静段的落界比例从 96.0% 掉到 0.0%,滤波器变得保守;把加速度计噪声放大 10 倍,整体平均 NEES 回到 6.86,看上去”正常”了,但落界比例只有 8.3%:它在平静段变得过于保守,在扰动段还是不够。这个不一致是模型缺失造成的(没有线加速度这个状态),不是参数错了;调参只能在平静段和扰动段之间做交换。 我保持噪声参数等于仿真的真实值,不调。这也解释了为什么没有一个 能同时满足两种工况,真正的办法是给滤波器一个线加速度的模型,或者一个对它不敏感的门控,这超出了这个系列的范围。
下一篇
EKF 和 ESKF 都靠线性化。下一篇是无迹卡尔曼滤波(UKF):不求雅可比,用一小撮”sigma 点”过一遍非线性函数再统计,它能不能在这里比线性化更好?答案要用一个 6 维误差状态、12 个 sigma 点的 UKF 去验证。然后把 Mahony、EKF、ESKF、UKF 四个滤波器放在同一张表里,50 个种子,同台比较。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!