
 Better Mistakes



音乐
暂未播放
调参与诊断:怎么知道滤波器没在骗你
上一篇的角度加零偏滤波器,我把过程噪声 缩小到 倍重新跑了一遍。角度 RMSE 从 0.329 度变成 0.657 度,慢了一倍,但它没有崩溃,没有报错,曲线看上去还是一条像样的正弦。真正出卖这个滤波器的是另一个数:50 次蒙特卡洛平均下来的 NEES(归一化估计误差平方)应该是 2,调对的滤波器是 1.993, 缩小的那个是 95.667。它在说”我的误差只有 个标准差”,实际误差是它自己报告的 7 倍。
这一篇讲怎么在滤波器”看上去能用”的时候识破它。
这一篇结束时你会有:make ch03 通过,out/ch03/ 下有 8 组输出(五种调参、稳态增益、两种协方差更新形式下的病态例子),figures/ch03/ 下有四张图;kl_kf_update_short / update_short 和稳态增益函数在 C、C++、Rust 中各一份;一份 python/kl/metrics.py(RMSE、NEES、NIS、 界、自相关)。
前置:第 2 篇。
数学
新息序列:零均值、白、协方差已知
滤波器每一步的新息(innovation)是 ,它的协方差是 ,这是上一篇已经算过的。如果模型是对的,新息有三条性质:
- 零均值:。
- 协方差等于滤波器自己报告的 。
- 不同时刻不相关:,(“白”)。
第三条的理由:,其中 是先验误差, 是测量噪声。最优估计满足正交性原理:估计误差和过去所有测量正交。而 ()是 与更早测量的线性组合,所以 和 正交; 与过去独立。于是 。直觉:新息是”新信息”,如果它还能被过去的新息预测,说明滤波器没有榨干过去的信息。
反过来,这三条性质正好是可以拿来检验的东西,因为新息是你手里真正有的量,不需要真值。
NIS 与 NEES
把新息按它的协方差归一化:
时, 是 维标准正态,所以 服从自由度为 (测量维数)的 分布,均值 ,方差 。这叫 NIS(normalized innovation squared)。
同理,如果有真值 (仿真里有,硬件上通常没有),估计误差 应该服从 ,
这叫 NEES(normalized estimation error squared), 是状态维数,均值 。
NEES 能看见 NIS 看不见的东西,但它需要真值。 这是仿真的最大价值:我们可以在仿真里检验滤波器的 说的话是不是真的,然后把调好的参数带到没有真值的硬件上。
蒙特卡洛界
单个 抖动很大。取 次独立仿真在同一时刻的平均 , 是 个独立 之和,服从 。所以平均值的 95% 双侧界是
这里 是 分布的 分位数。我们的情形是 ,(角度和零偏),界是 。
一个微妙之处:就算滤波器完美,每一步的平均 NEES 也有 5% 的概率落在界外。而且相邻时间步的 NEES 高度相关,所以”落在界外”成段出现。所以检验的判据不是”一步都不能出界”,而是”绝大多数步在界内,且平均值接近 “。我用的判据是至少 90% 的步在界内。
单次运行也可以检验 NIS: 步的 NIS 之和服从 (假设步间独立,这是新息的白性给的)。但是它没有 NEES 灵敏,下面的结果里会看到。
新息自相关
如果新息是白的,它的归一化自相关
在 时应该接近 0,样本足够多时每个 近似服从 ,所以 95% 的界是 。有色的新息(比如 很大)说明模型漏掉了某种动态:滤波器还在”偷懒”,没有把可预测的部分用完。
可观性
线性定常系统 , 的可观性矩阵是
当且仅当初始状态可以由有限个测量唯一确定。理由:,把前 个测量叠起来就是 ,凯莱-哈密顿定理保证再多的测量也不会提供新的线性无关方程。如果秩小于 ,有一个方向的初始状态对测量没有任何影响,滤波器对那个方向的不确定度永远不会收缩,而且因为过程噪声还在往里加,它会增长。
匀速模型 ,如果测的是位置, 满秩 4。如果测的是速度:, 每一块都一样, 的秩只有 2。位置永远估不出来(速度告诉你位置变化多快,不告诉你位置在哪),而且位置的方差随时间线性增长。
稳态增益
当 都是常数时, 的递推(Riccati 递推)
不依赖任何测量值,对可检测的系统会收敛到一个定值 (离散代数 Riccati 方程,DARE 的解),对应的增益 也是常数。我的做法是直接迭代这个递推直到 。这个增益可以离线算好,运行时把滤波器退化成 ,不再维护协方差,每步少几十次乘法。代价是丢掉了滤波开始时的瞬态。
数值:Joseph 形式与短形式
上一篇说 Joseph 形式在任何 下都保持对称半正定,短形式 不保证。这是个理论上的区别。我想亲眼看它在什么情况下变成现实问题,于是构造了一个病态例子:,测量噪声方差 (标准差 rad)。第一次更新时 里的量级差了 : 要被收缩到 ,浮点数的 16 位有效数字刚好够,几乎没有余量。
Python 实现
指标
"""Consistency metrics: RMSE, NEES, NIS, chi-square bounds, autocorrelation."""
import numpy as npfrom scipy.linalg import cho_factor, cho_solvefrom scipy.stats import chi2
def rmse(e): e = np.asarray(e) return float(np.sqrt(np.mean(e**2)))
def nees(e, P): """e' P^-1 e for one step.""" return float(e @ cho_solve(cho_factor(P, lower=True), e))
def nis(y, S): return float(y @ cho_solve(cho_factor(np.atleast_2d(S), lower=True), y))
def chi2_bounds(dof, runs, alpha=0.05): """Two-sided (1-alpha) bounds for the mean of `runs` independent chi2(dof) values.""" lo = chi2.ppf(alpha / 2, runs * dof) / runs hi = chi2.ppf(1 - alpha / 2, runs * dof) / runs return float(lo), float(hi)
def autocorr(x, max_lag): """Normalized autocorrelation of a 1-D sequence for lags 0..max_lag.""" x = np.asarray(x, dtype=float) - np.mean(x) var = np.dot(x, x) return np.array([np.dot(x[: len(x) - k], x[k:]) / var for k in range(max_lag + 1)])chi2_bounds 就是上面的公式,scipy.stats.chi2.ppf 是分位数函数。nees 和 nis 一样用 Cholesky 求解而不是求逆。autocorr 对每个滞后 做一次点积,,够用。
稳态增益与短形式
# ---- chapter 3 additions (append-only) ----
def _update_short(self, z): """Textbook short form P = (I - K H) P-: cheaper, but not symmetry/PSD safe.""" return self.update(z, joseph=False)
KalmanFilter.update_short = _update_short
def steady_state_gain(F, H, Q, R, tol=1e-12, max_iter=100000): """Iterate the Riccati recursion on the prior covariance until max|dP| <= tol * max|P|. Returns (K, P_prior) at convergence.""" F, H, Q, R = (np.asarray(a, dtype=float) for a in (F, H, Q, R)) P = Q.copy() for _ in range(max_iter): S = H @ P @ H.T + R K = np.linalg.solve(S, H @ P).T Pn = F @ (P - K @ H @ P) @ F.T + Q done = np.max(np.abs(Pn - P)) <= tol * np.max(np.abs(Pn)) P = Pn if done: break else: raise RuntimeError("steady_state_gain did not converge") S = H @ P @ H.T + R K = np.linalg.solve(S, H @ P).T return K, Pupdate_short 只是 update(z, joseph=False) 的别名,因为上一篇的 update 里已经留了这个分支:
if joseph: self.P = A @ self.P @ A.T + K @ self.R @ K.T self.P = 0.5 * (self.P + self.P.T)else: self.P = A @ self.Psteady_state_gain 从 起步迭代。它在 np.linalg.solve 里解线性方程,不是 Cholesky,因为离线计算不需要那么讲究。
五种配置,五十次蒙特卡洛
配置是五组”滤波器相信的 和 “(数据始终用真实噪声生成):正确、、、、。每次运行的代码和第 2 篇一样,只是把 Q、R 乘了系数。蒙特卡洛一次运行:
def mc_one(args): seed, qs, rs = args[:3] gyro_avg = args[3] if len(args) > 3 else True d = simulate_tilt_bias(seed, write=False, gyro_avg=gyro_avg) o = run_tilt(d, qs, rs) e0, e1 = o["theta"] - d["theta"], o["bias"] - d["bias"] det = o["P00"] * o["P11"] - o["P01"] ** 2 ne = (o["P11"] * e0**2 - 2 * o["P01"] * e0 * e1 + o["P00"] * e1**2) / det return e0**2, ne, o["nis"]NEES 用 的解析逆直接写成向量化形式(det 在分母),因为这里一次要处理 6000 步。仿真种子 1 到 50,用 ProcessPoolExecutor 并行跑。
先说一个我踩的坑。 我第一次跑这个实验,调对的滤波器平均 NEES 是 2.233,只有 86.1% 的步落在 95% 界内,没有达到我设的 90%。滤波器没问题,我查了很久。原因是仿真器:第 1、2 篇里,我让陀螺仪读数等于角速度在采样时刻的瞬时值 ,而滤波器的离散模型是 ,隐含的是”整个区间内的平均角速度”。差别是 rad 每步,听上去很小,但它是有方向的、随 摆动的系统误差,零偏状态试图解释它,结果是估计误差系统性地比 宣称的大一点点:NEES 偏高 10% 到 15%。把陀螺读数改成区间平均速率 之后(真实的积分式陀螺输出的就是这个),NEES 回到 1.993。这个修改已经在第 2 篇的仿真器里(gyro_avg=True),旧版本的 86.1% 我保留在 make ch03 的输出里,当作一次对照。
这是我想强调的一点:NEES 不仅检验滤波器,也检验你的仿真器和滤波器模型是否”说同一种语言”。一个 10% 的偏差,RMSE 上几乎看不出来,NEES 一下就抓住了。
病态例子
病态实验在 Python 里还有一份 float32 版本,因为 float64 下我找不到差别(下面会看到)。它用 numpy 的 float32 数组写了一遍标量测量更新:
def run_dtype(d, dtype, joseph): """Scalar-measurement update of the ill-conditioned case in an arbitrary numpy dtype.""" F, B, H, Q, R = (a.astype(dtype) for a in tilt_bias_model(DT, SG, SBW, ILL_SV)) x = np.zeros(2, dtype); P = ILL_P0.astype(dtype); I = np.eye(2, dtype=dtype) n = len(d["t"]); me = np.empty(n); asym = np.empty(n); nonpd = 0 for i in range(n): x = F @ x + B[:, 0] * dtype(d["omega_m"][i]) P = F @ P @ F.T + Q y = dtype(d["z"][i]) - H @ x S = (H @ P @ H.T + R)[0, 0] K = (P @ H.T)[:, 0] / S x = x + K * y[0] A = I - np.outer(K, H[0]) if joseph: P = A @ P @ A.T + np.outer(K, K) * R[0, 0] P = dtype(0.5) * (P + P.T) else: P = A @ P me[i] = min_eig_sym(P[0,0], P[0,1], P[1,0], P[1,1]); asym[i] = abs(P[0,1]-P[1,0]) return me, asymC、C++、Rust 实现
这一篇给三种语言各加两样东西:协方差短形式更新,和稳态增益。第 2 篇的 update 已经把”算 、、、“拆成共用部分,所以短形式只是共用部分之后换一个协方差公式。
C
int kl_kf_update_short(kl_kf *kf, const kl_real *z, kl_real *y_out, kl_real *S_out){ int n = kf->n, m = kf->m; if (kf_gain_and_state(kf, z, y_out, S_out) != 0) return -1; kl_real *K = kf->work + m + 2 * m * m + 2 * m * n; kl_real *A = K + n * m; kl_real *T = A + n * n; kl_real *U = T + n * n;
/* Short form: P = (I - K H) P, no symmetrization */ kl_mat_mul(K, kf->H, T, n, m, n); kl_mat_identity(U, n); kl_mat_sub(U, T, A, n, n); kl_mat_mul(A, kf->P, T, n, n, n); kl_mat_copy(T, kf->P, n, n); return 0;}稳态增益函数要一块自己的工作区,长度 KL_STEADY_WORK_LEN(n, m),同样由调用者提供:
/* S = H P H^T + R and K^T = S^-1 H P for the given P; K is n x m. Returns -1 if S is not SPD. */static int riccati_gain(const kl_real *H, const kl_real *R, const kl_real *P, int n, int m, kl_real *S, kl_real *L, kl_real *HP, kl_real *Kt, kl_real *K){ kl_mat_mul(H, P, HP, m, n, n); kl_mat_mul_bt(HP, H, L, m, n, m); kl_mat_add(L, R, S, m, m); kl_mat_copy(S, L, m, m); if (kl_chol(L, m) != 0) return -1; kl_mat_copy(HP, Kt, m, n); kl_chol_solve(L, Kt, m, n); kl_mat_transpose(Kt, K, m, n); return 0;}
int kl_kf_steady_gain(const kl_real *F, const kl_real *H, const kl_real *Q, const kl_real *R, int n, int m, kl_real tol, int max_iter, kl_real *K_out, kl_real *P_out, kl_real *work){ kl_real *P = work; kl_real *T = P + n * n; kl_real *U = T + n * n; kl_real *V = U + n * n; kl_real *S = V + n * n; kl_real *L = S + m * m; kl_real *HP = L + m * m; kl_real *Kt = HP + m * n; kl_real *K = Kt + m * n;
kl_mat_copy(Q, P, n, n); for (int it = 0; it < max_iter; it++) { if (riccati_gain(H, R, P, n, m, S, L, HP, Kt, K) != 0) return -1; /* Pn = F (P - K H P) F^T + Q */ kl_mat_mul(K, HP, T, n, m, n); kl_mat_sub(P, T, U, n, n); kl_mat_mul(F, U, T, n, n, n); kl_mat_mul_bt(T, F, U, n, n, n); kl_mat_add(U, Q, V, n, n);
kl_real dmax = 0, pmax = 0; for (int i = 0; i < n * n; i++) { kl_real d = KL_FABS(V[i] - P[i]), a = KL_FABS(V[i]); dmax = d > dmax ? d : dmax; pmax = a > pmax ? a : pmax; } kl_mat_copy(V, P, n, n); if (dmax <= tol * pmax) { if (riccati_gain(H, R, P, n, m, S, L, HP, Kt, K) != 0) return -1; kl_mat_copy(K, K_out, n, m); if (P_out) kl_mat_copy(P, P_out, n, n); return 0; } } return -1;}riccati_gain 重复了 kf_gain_and_state 里”、Cholesky、“那几行,因为这里没有状态向量也没有测量值,共用起来反而别扭。我宁愿重复十行,也不想搞一个参数多到看不懂的公共函数。
C++
// Textbook short form P = (I - K H) P-: cheaper, but neither symmetry nor // positive definiteness is preserved. Same failure behavior as update(). bool update_short(const Mat<M, 1, T>& z) { Mat<N, M, T> K; if (!gain(z, K)) return false; P = (Mat<N, N, T>::identity() - K * H) * P; return true; }// Steady-state gain: iterate the Riccati recursion on the prior covariance until// max|dP| <= tol * max|P|. Returns false if it does not converge or S is not SPD.// K is the gain for the converged prior P.template <std::size_t N, std::size_t M, class T>bool steady_state_gain(const Mat<N, N, T>& F, const Mat<M, N, T>& H, const Mat<N, N, T>& Q, const Mat<M, M, T>& R, Mat<N, M, T>& K, Mat<N, N, T>& P, T tol = T(1e-12), int max_iter = 100000) { auto gain = [&](const Mat<N, N, T>& Pp, Mat<N, M, T>& Kp) { const Mat<M, N, T> HP = H * Pp; Mat<M, M, T> L = HP * H.transpose() + R; if (!cholesky(L)) return false; Kp = chol_solve(L, HP).transpose(); return true; }; auto max_abs = [](const Mat<N, N, T>& m) { T r = 0; for (const T v : m.a) r = std::fmax(r, std::fabs(v)); return r; }; P = Q; bool converged = false; for (int it = 0; it < max_iter && !converged; it++) { if (!gain(P, K)) return false; const Mat<N, N, T> Pn = F * (P - K * H * P) * F.transpose() + Q; converged = max_abs(Pn - P) <= tol * max_abs(Pn); P = Pn; } return converged && gain(P, K);}用 lambda 把”算增益”局部化,捕获 H、R。std::fmax 取最大绝对值(max_abs)。函数返回 bool,参数是输出引用 K、P,这是 C++ 里没有 Result 时的常见写法。
Rust
/// Short-form update P = (I - K H) P-: cheaper, but loses symmetry and /// positive-definiteness when ill-conditioned. Same failure behavior as `update`. pub fn update_short(&mut self, z: &Mat<M, 1>) -> Result<(), CholeskyError> { let (y, s, k) = self.gain(z)?; self.x = self.x + k * y; self.p = (Mat::<N, N>::identity() - k * self.h) * self.p; self.y = y; self.s = s; Ok(()) }/// Steady-state gain: iterate the Riccati recursion on the prior covariance until/// max|dP| <= tol * max|P|. Returns (K, converged prior P), or `None` if the/// iteration does not converge or a Cholesky factorization fails.pub fn steady_state_gain<const N: usize, const M: usize>( f: &Mat<N, N>, h: &Mat<M, N>, q: &Mat<N, N>, r: &Mat<M, M>, tol: Real, max_iter: usize,) -> Option<(Mat<N, M>, Mat<N, N>)> { let gain = |p: &Mat<N, N>| -> Option<Mat<N, M>> { let hp = *h * *p; let l = (hp * h.transpose() + *r).cholesky()?; Some(chol_solve(&l, &hp).transpose()) }; let mut p = *q; for _ in 0..max_iter { let k = gain(&p)?; let pn = *f * (p - k * *h * p) * f.transpose() + *q; let (mut dmax, mut pmax): (Real, Real) = (0.0, 0.0); for i in 0..N { for j in 0..N { dmax = dmax.max(fabs(pn.m[i][j] - p.m[i][j])); pmax = pmax.max(fabs(pn.m[i][j])); } } p = pn; if dmax <= tol * pmax { return Some((gain(&p)?, p)); } } None}闭包 gain 返回 Option,里面的 ? 在 Cholesky 失败时提前返回 None,外层的 let k = gain(&p)?; 又把 None 传出去。整个函数没有一个 unwrap,也没有 panic。返回类型 Option<(Mat<N, M>, Mat<N, N>)> 把”没收敛”和”S 不正定”统一成一个 None,调用者不需要区分。
三个 app(c/apps/ch03.c、cpp/apps/ch03.cpp、rust/src/bin/ch03.rs)对种子 1 的数据依次跑五种配置、稳态增益滤波器和两个病态例子,写出 out/ch03/<case>_<lang>.csv。Cholesky 失败时,app 保持状态不变并把 NIS 写成 nan;compare.py 把两边同为 nan 当作相等。这一条路径这次没有被触发。
五十次蒙特卡洛的统计只在 Python 里算。C、C++、Rust 已经在种子 1 上和 Python 逐列对上,同一份算法在其他种子上不会有两样,所以统计结论是可以迁移的。
结果
下面是 make -s ch03 的输出。先是逐位对比:
$ make -s ch03(24 行里节选)ok illcond_joseph_c.csv: max diff 7.473e-09 <= 1.0e-07ok illcond_joseph_cpp.csv: max diff 7.473e-09 <= 1.0e-07ok illcond_joseph_rs.csv: max diff 7.473e-09 <= 1.0e-07ok illcond_short_c.csv: max diff 4.583e-13 <= 1.0e-07ok illcond_short_cpp.csv: max diff 4.601e-13 <= 1.0e-07ok illcond_short_rs.csv: max diff 4.601e-13 <= 1.0e-07ok steady_c.csv: max diff 1.110e-16 <= 1.0e-09ok steady_cpp.csv: max diff 1.110e-16 <= 1.0e-09ok steady_rs.csv: max diff 1.110e-16 <= 1.0e-09ok tune_tuned_c.csv: max diff 2.487e-14 <= 1.0e-09ok tune_tuned_cpp.csv: max diff 2.665e-14 <= 1.0e-09ok tune_tuned_rs.csv: max diff 2.665e-14 <= 1.0e-09病态例子(illcond_*)的容差我放宽到了 ,其他仍是 。因为这个例子的条件数约 , 量级的舍入差异(numpy 里的 BLAS 和我手写的循环求和顺序不同)被放大到 :最大差异 ,出现在 NIS 这一列;bias 和 P11 的最大差异分别是 和 ,其余列在 以下。C 和 C++、Rust 之间的最大差异只有 ,所以不是某个实现的 bug,而是这个问题本身对舍入的敏感度。
谁在骗你
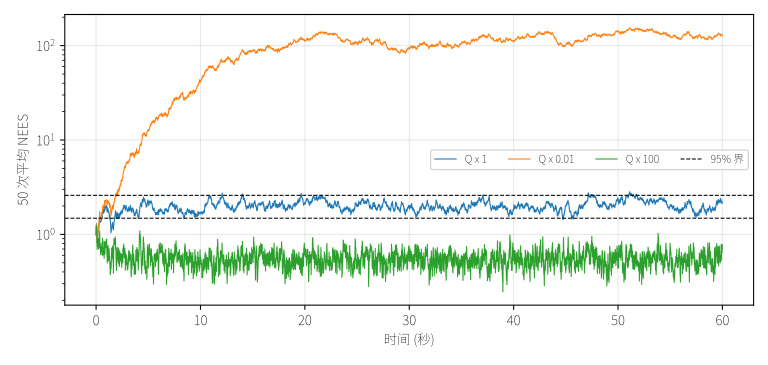
NEES 95% bounds for mean of 50 runs, dof 2: [1.484, 2.591]config angle RMSE (deg) mean NEES in bounds mean NIStuned 0.329 1.993 96.9% 1.000q001 0.657 95.667 2.5% 1.047q100 0.658 0.555 0.0% 0.950r01 0.412 6.960 0.0% 9.854r10 0.412 1.283 22.9% 0.101tuned, sim with instantaneous gyro rate: mean NEES 2.233, in bounds 86.1%这张表是本篇的核心,几点观察:
- 调对的滤波器:NEES 1.993(理论值 2),96.9% 的步落在 95% 界内,NIS 1.000(理论值 1)。
- (过于相信模型):NEES 95.667。RMSE 变成两倍,更重要的是滤波器严重过自信。NIS 只有 1.047,几乎看不出问题。
- (过于怀疑模型):NEES 0.555,保守。NIS 0.950,同样不显眼。RMSE 0.658 度,也是两倍。
- 和 :NIS 9.854 和 0.101,一目了然:测量噪声设错了,新息就是它的直接证人,量级和 的错误倍数一致。有趣的是 RMSE 在两个方向上都是 0.412,对称地变差。
所以: 设错了,NIS 立刻告诉你; 设错了,NIS 几乎沉默,NEES 和新息自相关才会开口。 原因不难想:新息的大小主要由测量噪声和先验不确定度的比值决定, 错了只通过先验协方差间接影响它。
没有真值的时候:新息自相关
NEES 要真值,真实硬件上你没有。自相关不需要:
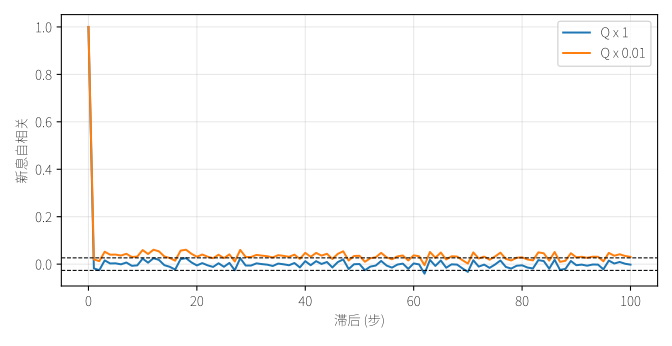
innovation autocorr tuned: 2/100 lags outside +-0.026, lag1 = -0.018innovation autocorr q001: 72/100 lags outside +-0.026, lag1 = 0.020调对的滤波器 100 个滞后里只有 2 个落在 之外(期望 5 个左右, 个样本,这里取跳过 500 步的瞬态之后); 的滤波器有 72 个。这就是硬件上能用的诊断:把新息记下来,画一张自相关图。
可观性
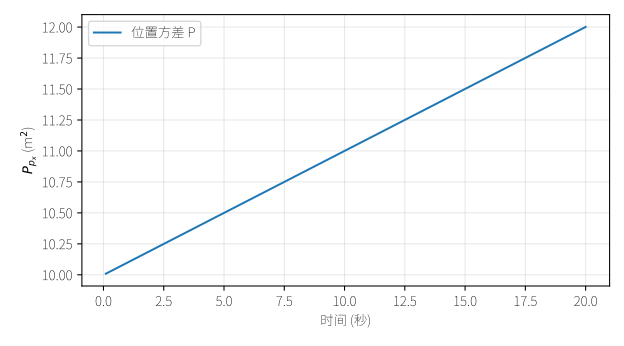
observability rank, CV model, position measurement: 4 of 4observability rank, CV model, velocity-only measurement: 2 of 4velocity-only: P_px at k=50: 10.50, k=100: 11.00, k=200: 12.00 m^2; P_vx settles at 0.0951只测速度时, 的秩是 2,位置方差从初始的 10 起,每步稳定增加 0.01 m²,不会收敛,速度方差则稳定在 0.0951。滤波器没有崩溃、不会报错,它只是诚实地说”我不知道位置”,而且越来越不知道。
稳态增益
K_inf = [0.011762, -0.001988]angle RMSE over 60 s: time-varying 0.3479 deg, steady-state gain 0.6476 deg, difference 0.29964 degangle RMSE for t >= 20 s: time-varying 0.3078 deg, steady-state gain 0.3108 deg60 秒整段看,固定增益滤波器差了 0.30 度,因为它一开始没有大增益来快速收敛零偏估计(零偏的初始误差是 0.05 rad/s)。去掉前 20 秒的瞬态,两者是 0.3078 和 0.3108 度,差 0.003 度。如果你的系统启动后有一段时间可以等,固定增益是个好交易:省掉整个协方差递推,精度几乎一样。
短形式 Joseph 形式之争:我没能让短形式崩溃
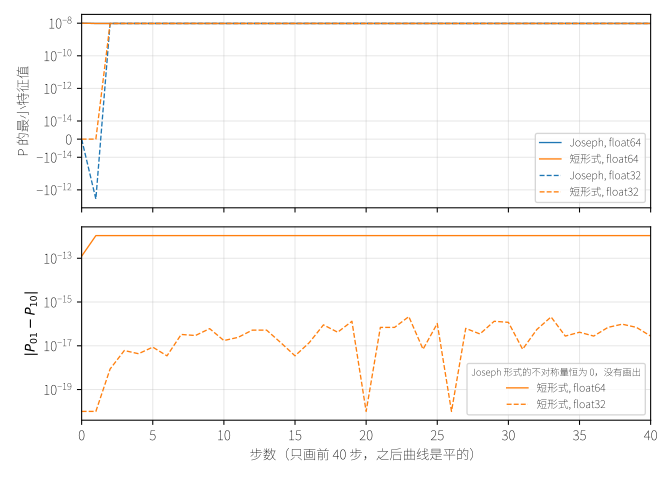
Ill-conditioned case: P0 = 1e6 I, r = 1e-8, 1000 steps (float64) joseph: min eig over run = 9.629e-09, max |P01-P10| = 0.000e+00, steps with min eig < 0: 0, failed updates: 0 short : min eig over run = 9.629e-09, max |P01-P10| = 1.082e-12, steps with min eig < 0: 0, failed updates: 0
Same case, Python-only float32 (C/C++/Rust float32 comes in chapter 8) joseph: min eig over run = -3.638e-12, max |P01-P10| = 0.000e+00, steps with min eig < 0: 1 short : min eig over run = 0.000e+00, max |P01-P10| = 4.552e-15, steps with min eig < 0: 0我预想的是短形式在这个例子里会出问题。实际:float64 下两种形式都活得很好,最小特征值一样(,都是对的),区别只有对称性:短形式的 到了 量级,Joseph 形式加了显式对称化,精确为 0。float32 下,Joseph 形式有一步最小特征值是 (相对 的初始量级,这是 float32 能表示的底噪),短形式反而是 0。
所以这个例子没有把两者分出高下,我也不想夸大。我能说的只有:短形式在 float64 下已经丢掉了对称性(),而且没有机制把它找回来;Joseph 形式的优势是”不依赖 是否精确最优”这个保证,不是这个特定例子里的实测差距。第 8 篇上 float32 和 UD 分解的时候会再试一次,而且结论会推翻这一节的”float32 下 Joseph 形式只有一步不对”:那里的 Python 是直接做除法求增益,换成 C、C++、Rust 里用的 Cholesky 风格()之后,同一个例子在 float32 下几乎每一步都崩溃。我猜这里的 Python 版是因为那一步的中间量恰好是整数,舍入碰巧没有损失,是运气,不是稳健。
下一篇
线性滤波器的准备到此为止:推导、实现、四种语言逐位一致、诊断工具齐全。下一篇开始进入真正的主题,姿态。我们要做的是:一个三轴陀螺加三轴加速度计加三轴磁力计的 IMU 仿真器,描述姿态的数学(旋转矩阵、欧拉角和它的万向锁、四元数、指数映射),以及一个不是卡尔曼滤波的基线:Mahony 互补滤波器,它是第 1 篇结尾那个”常增益就是低通滤波”的三维版本。后面三个卡尔曼滤波器(EKF、ESKF、UKF)都要和它比。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!