
 Better Mistakes



音乐
暂未播放
无迹卡尔曼滤波,以及四个滤波器同台
先看一个玩具问题。把极坐标 变成直角坐标 ,,。用一百万个样本算出来, 的均值是 0.8827。线性化给的答案是 1.0000,差了 0.117;无迹变换只用 5 个点,给的答案是 0.8801,差了 0.003。这就是这一篇的主角,它连一个雅可比也没求。
然后是更扫兴的部分:把它放进姿态滤波器之后,在 50 个种子的蒙特卡洛里,UKF 的总姿态误差是 0.929 度,和上一篇的 ESKF 的 0.929 度在三位小数里没有区别。我会把这件事说清楚,也会说它在哪里确实赢了。
这一篇结束时你会有:make ch07 通过(它跑得比较久,大概 6 分钟,大部分时间花在 50 个种子的四滤波器蒙特卡洛上),out/ch07/ukf_{nominal,large}_{py,c,cpp,rs}.csv,三张图;C、C++、Rust 各一个误差状态 UKF(kl_ukf_att、ukf.hpp、ukf.rs)。每个语言的 app 先做一个 sigma 点的自检。
前置:第 6 篇(误差状态、注入与重置、航向更新、门控)。
数学
为什么传点而不是传函数
EKF 的做法是把非线性函数 换成它的一阶泰勒展开,再传播高斯分布。无迹变换(unscented transform,UT)反过来:保留真正的非线性函数,用一小撮精心选择的点来代表高斯分布,把点一个个过一遍 ,再用输出点的加权统计量近似输出分布的均值和协方差。
设 , 维。选 个 sigma 点 ,权重 (均值用)和 (协方差用)。对称选法:, 矩阵 的第 列,使得
其中 用 Cholesky 因子:,。
为什么它能抓到二阶项
把 在 处展开到二阶:
是雅可比, 是第 个输出分量的海森矩阵, 是单位向量。真实的输出均值( 对称,奇次项为零):
线性化给 ,漏掉了第二项。UT 的均值是
权重和为 1,一次项因对称选点而为零,二次项用 得到 。于是 UT 的均值和真实均值在二阶项上相同。协方差的一阶项 也被精确抓住。四阶以后的项会有误差,参数 就是用来在高斯情形下补偿四阶矩的。
玩具问题里, 的二阶项是 ,对应线性化和真实均值的差(实测 0.1173,差别来自更高阶)。
缩放参数
标准的缩放 UT 有三个参数 ,:
我取 ,,,于是 :,,其余 12 个点权重都是 ,全部是正数。常见的另一种选择是 ,让 sigma 点贴近均值(局部性好)。但它的代价是 , 极小,中心点权重变成 ,其他点权重是 :几十万量级的正负权重相消,在 float32 里精度会丢得很难看。 的代价是 sigma 点离均值 远,对于很强的非线性,这个”非局部”采样会有问题。折衷之下,我为了第 8 篇的 float32 选了 。
加性噪声 UKF
状态 ,过程 ,测量 ,噪声加性。
预测: 从 生成 sigma 点 ;;
更新: 从 重新生成 sigma 点;;
最后一个等式:。检验: 是线性的 时,,,,UKF 恰好还原成第 2 篇的线性卡尔曼滤波。
四元数的均值
怎么对旋转取”均值”?对四元数的四个分量直接取加权平均,不能:结果不是单位四元数,而且 与 是同一个旋转, 和 的平均是零。解法就是第 6 篇的做法:在名义姿态的切空间里工作。
- 生成 sigma 点:用 6 维误差向量 的 sigma 点,每个点对应一个姿态 。
- 传播:每个点各自过一遍陀螺模型,。
- 取参考:把传播后的中心点 当参考,每个点相对参考的偏差 (就是第 4 篇的
att_error),这些偏差是普通向量,可以加权平均、求协方差。 - 回到流形:。
测量更新同样:用名义姿态周围的 sigma 点,对每个点算第 6 篇的加速度计模型(重力方向向量)和航向模型,其余是标准 UKF。注入、重置、门控、噪声参数与第 6 篇完全一样。
一个航向的小处理。 航向是个角度,有折叠问题。在 90 度初始误差下 sigma 点会分散到 rad(超过 ),朴素地对折叠后的角度加权平均会出错。我让每个点的航向相对中心点的航向取差(折到 ),再加权平均,最后加回中心点的航向。
玩具问题的实现
玩具问题只在 Python 里。
def toy(): """Polar to Cartesian: true moments (Monte Carlo) vs linearization vs unscented transform.""" from kl.plotting import L, save import matplotlib.pyplot as plt
mu = np.array([1.0, np.pi / 2]) S = np.diag([0.02**2, 0.5**2]) f = lambda rt: np.column_stack([rt[:, 0] * np.cos(rt[:, 1]), rt[:, 0] * np.sin(rt[:, 1])]) # noqa: E731 rng = np.random.default_rng(1) smp = rng.multivariate_normal(mu, S, 1_000_000) ys = f(smp) m_mc, c_mc = ys.mean(axis=0), np.cov(ys.T) J = np.array([[np.cos(mu[1]), -mu[0] * np.sin(mu[1])], [np.sin(mu[1]), mu[0] * np.cos(mu[1])]]) m_lin, c_lin = f(mu[None])[0], J @ S @ J.T X, Wm, Wc = sigma_points(S) m_ut, c_ut = unscented_transform(f(mu + X), Wm, Wc) print("Polar to Cartesian: r ~ N(1, 0.02^2), theta ~ N(pi/2, 0.5^2)") print(f"{'':16s} {'mean x':>9s} {'mean y':>9s} {'var x':>10s} {'var y':>10s} {'cov xy':>10s}") for name, m, c in (("Monte Carlo 1e6", m_mc, c_mc), ("linearization", m_lin, c_lin), ("unscented", m_ut, c_ut)): print(f"{name:16s} {m[0]:9.4f} {m[1]:9.4f} {c[0, 0]:10.5f} {c[1, 1]:10.5f} {c[0, 1]:10.5f}")sigma_points 和 unscented_transform 是后面姿态 UKF 共用的两个函数。
Python 实现
"""Unscented transform and an error-state unscented Kalman filter for attitude."""
import numpy as np
from .imu_sim import Gfrom .quat import SMALL, qrot, skew, wrap_pifrom .update import joseph_update # noqa: F401 (kept for symmetry with the other filters)
def sigma_points(P, alpha=1.0, beta=2.0, kappa=0.0): """Scaled sigma points around zero for N(0, P): returns (X, Wm, Wc).
X has 2n+1 rows: the centre, then +-columns of chol((n + lambda) P). """ n = P.shape[0] lam = alpha**2 * (n + kappa) - n L = np.linalg.cholesky((n + lam) * P) X = np.vstack([np.zeros(n), L.T, -L.T]) Wm = np.full(2 * n + 1, 0.5 / (n + lam)) Wc = Wm.copy() Wm[0] = lam / (n + lam) Wc[0] = Wm[0] + (1.0 - alpha**2 + beta) return X, Wm, Wc
def unscented_transform(Y, Wm, Wc, noise=None): """Weighted mean and covariance of transformed sigma points Y (rows).""" mean = Wm @ Y dev = Y - mean cov = (Wc[:, None] * dev).T @ dev return mean, cov if noise is None else cov + noise
# ---- row-wise quaternion helpers (same formulas as kl.quat) ----
def qexp_rows(V): th = np.sqrt(np.sum(V * V, axis=1)) small = th < SMALL ths = np.where(small, 1.0, th) w = np.where(small, 1.0 - th * th / 8.0, np.cos(0.5 * th)) s = np.where(small, 0.5, np.sin(0.5 * th) / ths) return np.column_stack([w, s[:, None] * V])
def qmul_rows(a, b): a, b = np.broadcast_arrays(np.atleast_2d(a), np.atleast_2d(b)) aw, ax, ay, az = a.T bw, bx, by, bz = b.T return np.column_stack([ aw * bw - ax * bx - ay * by - az * bz, aw * bx + ax * bw + ay * bz - az * by, aw * by - ax * bz + ay * bw + az * bx, aw * bz + ax * by - ay * bx + az * bw, ])
def qlog_rows(Q): Q = np.where((Q[:, 0] < 0)[:, None], -Q, Q) u = Q[:, 1:] n = np.sqrt(np.sum(u * u, axis=1)) small = n < SMALL ns = np.where(small, 1.0, n) k = np.where(small, 2.0 / Q[:, 0], 2.0 * np.arctan2(n, Q[:, 0]) / ns) return k[:, None] * u
def rot_inv_rows(Q, v): """C(q_i)^T v for every row (unit q_i): (w^2 - u.u) v + 2 (u.v) u - 2 w (u x v).""" w, u = Q[:, :1], Q[:, 1:] return (w * w - np.sum(u * u, axis=1, keepdims=True)) * v + 2 * (u @ v)[:, None] * u - 2 * w * np.cross(u, v)
class AttitudeUKF: """Error-state UKF: same 6-dim error as the ESKF, additive noise, scaled unscented transform."""
def __init__(self, sigma_g, sigma_bw, sigma_a, sigma_m, m_w, q0, P0, accel_gate=0.5, mag_gate=0.1, reset=True, alpha=1.0, beta=2.0, kappa=0.0): self.sg, self.sbw, self.sa, self.sm = sigma_g, sigma_bw, sigma_a, sigma_m self.m_w = np.asarray(m_w, dtype=float) self.q = np.asarray(q0, dtype=float).copy() self.b = np.zeros(3) self.P = np.asarray(P0, dtype=float).copy() self.accel_gate, self.mag_gate, self.reset = accel_gate, mag_gate, reset self.ut = (alpha, beta, kappa) self.last_nis = np.nan
def predict(self, gyro, dt): X, Wm, Wc = sigma_points(self.P, *self.ut) qi = qmul_rows(self.q, qexp_rows(X[:, :3])) bi = self.b + X[:, 3:] qi = qmul_rows(qi, qexp_rows((gyro - bi) * dt)) # each point through the gyro model q_ref = qi[0] # the propagated centre point D = np.column_stack([qlog_rows(qmul_rows(q_ref * np.array([1, -1, -1, -1]), qi)), bi - self.b]) mean, cov = unscented_transform(D, Wm, Wc) Q = np.diag([self.sg**2 * dt**2] * 3 + [self.sbw**2 * dt] * 3) self.q = qmul_rows(q_ref, qexp_rows(mean[None, :3]))[0] self.b = self.b + mean[3:] self.P = cov + Q
def _inject(self, dx): from .quat import qexp, qmul, qnormalize
dth = dx[:3] self.q = qnormalize(qmul(self.q, qexp(dth))) self.b = self.b + dx[3:] if self.reset: Gm = np.eye(6) Gm[:3, :3] -= skew(0.5 * dth) self.P = Gm @ self.P @ Gm.T
def _correct(self, X, Wm, Wc, Z, y, R): """Standard UKF measurement update given model outputs Z at the sigma points.""" zbar = Wm @ Z dz = Z - zbar S = (Wc[:, None] * dz).T @ dz + R Pxz = (Wc[:, None] * X).T @ dz L = np.linalg.cholesky(S) K = np.linalg.solve(L.T, np.linalg.solve(L, Pxz.T)).T dx = K @ y P_new = self.P - K @ S @ K.T self.P = 0.5 * (P_new + P_new.T) self.last_nis = float(y @ np.linalg.solve(S, y)) self._inject(dx)
def update_accel(self, accel): norm = np.sqrt(accel @ accel) if self.accel_gate is not None and abs(norm - G) > self.accel_gate: return False X, Wm, Wc = sigma_points(self.P, *self.ut) qi = qmul_rows(self.q, qexp_rows(X[:, :3])) Z = rot_inv_rows(qi, np.array([0.0, 0.0, -1.0])) y = accel / norm - Wm @ Z self._correct(X, Wm, Wc, Z, y, (self.sa / G) ** 2 * np.eye(3)) return True
def update_mag_heading(self, mag): norm = np.sqrt(mag @ mag) if self.mag_gate is not None and abs(norm - 1.0) > self.mag_gate: return False X, Wm, Wc = sigma_points(self.P, *self.ut) qi = qmul_rows(self.q, qexp_rows(X[:, :3])) C = qrot(self.q) mw = rot_inv_rows(qi, self.m_w) @ C.T # C(q) C(q_i)^T m_w for every point psi_h = np.arctan2(self.m_w[1], self.m_w[0]) Z0 = wrap_pi(np.arctan2(mw[:, 1], mw[:, 0]) - psi_h) Zrel = wrap_pi(Z0 - Z0[0])[:, None] # heading relative to the centre point: no wrap trouble zbar = Z0[0] + Wm @ Zrel[:, 0] m_meas = C @ mag y = np.array([wrap_pi(wrap_pi(np.arctan2(m_meas[1], m_meas[0]) - psi_h) - zbar)]) r = (self.sm / np.hypot(self.m_w[0], self.m_w[1])) ** 2 self._correct(X, Wm, Wc, Zrel, y, np.array([[r]])) return Truesigma_points 返回 的点(每行一个)和两组权重。后面四个 *_rows 函数是第 4 篇四元数函数的逐行批量版本,公式一模一样,只是对 13 个点一次算完,因为 Python 里循环 13 次太慢。AttitudeUKF.predict 是上一节”四元数的均值”的四个步骤。_correct 是标准 UKF 更新,update_accel 和 update_mag_heading 只负责给出模型输出 Z 和新息 y。
C、C++、Rust 实现
三种语言的结构和 Python 一致。区别:
- C: sigma 点()、四元数数组、权重都是
kl_ukf_att结构体里的定长数组,没有malloc。kl_ukf_sigma_points公开出来,因为 app 的自检要直接调它。 - C++:
SigmaPoints<N, T>是个小模板结构体,权重在compute里算出来;参数 是constexpr成员,编译期常量。 - Rust:
sigma_points(&P)返回Option<[[Real; 6]; 13]>,Cholesky 失败是None,权重函数unscented_weights()单独暴露。
C++
// Sigma points of N(0, P): the centre, then +-columns of chol((n + lambda) P).template <std::size_t N, class T = double>struct SigmaPoints { static constexpr std::size_t COUNT = 2 * N + 1; static constexpr T ALPHA = 1, BETA = 2, KAPPA = 0; static constexpr T LAMBDA = ALPHA * ALPHA * (N + KAPPA) - N;
Mat<COUNT, N, T> X; // one point per row std::array<T, COUNT> Wm, Wc;
// Returns false if P is not positive definite. bool compute(const Mat<N, N, T>& P) { Mat<N, N, T> L = P * (N + LAMBDA); if (!cholesky(L)) return false; X = {}; for (std::size_t j = 0; j < N; j++) for (std::size_t k = j; k < N; k++) { // L is lower triangular X(1 + j, k) = L(k, j); X(1 + N + j, k) = -L(k, j); } Wm.fill(T(0.5) / (N + LAMBDA)); Wc = Wm; Wm[0] = LAMBDA / (N + LAMBDA); Wc[0] = Wm[0] + (1 - ALPHA * ALPHA + BETA); return true; }}; // Returns false, leaving the state unchanged, if P is not positive definite. bool predict(const Vec3<T>& gyro, T dt) { SigmaPoints<N, T> sp; if (!sp.compute(P)) return false; std::array<Quat<T>, K> qi; std::array<Vec3<T>, K> bi; for (std::size_t i = 0; i < K; i++) { qi[i] = q * Quat<T>::exp(rows3(sp.X, i, 0)); bi[i] = b + rows3(sp.X, i, 3); qi[i] = qi[i] * Quat<T>::exp((gyro - bi[i]) * dt); // each point through the gyro model } const Quat<T> q_ref = qi[0]; // the propagated centre point Mat<K, 6, T> D; for (std::size_t i = 0; i < K; i++) { const Vec3<T> th = (q_ref.conj() * qi[i]).log(), db = bi[i] - b; for (std::size_t j = 0; j < 3; j++) { D(i, j) = th(j, 0); D(i, 3 + j) = db(j, 0); } } Mat<1, 6, T> mean{}; for (std::size_t i = 0; i < K; i++) for (std::size_t j = 0; j < 6; j++) mean(0, j) += sp.Wm[i] * D(i, j); Mat<6, 6, T> cov{}; for (std::size_t i = 0; i < K; i++) for (std::size_t r = 0; r < 6; r++) for (std::size_t c = 0; c < 6; c++) cov(r, c) += sp.Wc[i] * (D(i, r) - mean(0, r)) * (D(i, c) - mean(0, c)); for (std::size_t i = 0; i < 3; i++) { cov(i, i) += sg * sg * dt * dt; cov(3 + i, 3 + i) += sbw * sbw * dt; } q = q_ref * Quat<T>::exp(Vec3<T>{{mean(0, 0), mean(0, 1), mean(0, 2)}}); // not normalized here b = b + Vec3<T>{{mean(0, 3), mean(0, 4), mean(0, 5)}}; P = cov; return true; } // Heading-only magnetometer update. Returns false when gated out or on Cholesky failure. bool update_mag_heading(const Vec3<T>& mag) { const T norm = std::sqrt(dot(mag, mag)); if (mag_gate >= 0 && std::fabs(norm - 1) > mag_gate) return false; SigmaPoints<N, T> sp; if (!sp.compute(P)) return false; const Mat<3, 3, T> C = q.dcm(); const T psi_h = std::atan2(m_w(1, 0), m_w(0, 0)); std::array<T, K> z0; for (std::size_t i = 0; i < K; i++) { const Vec3<T> mw = C * rot_inv(q * Quat<T>::exp(rows3(sp.X, i, 0)), m_w); z0[i] = wrap_pi(std::atan2(mw(1, 0), mw(0, 0)) - psi_h); } Mat<K, 1, T> Zrel; // heading relative to the centre point: no wrap trouble T zbar = 0; for (std::size_t i = 0; i < K; i++) { Zrel(i, 0) = wrap_pi(z0[i] - z0[0]); zbar += sp.Wm[i] * Zrel(i, 0); } zbar += z0[0]; const Vec3<T> m_meas = C * mag; const Mat<1, 1, T> y{{wrap_pi(wrap_pi(std::atan2(m_meas(1, 0), m_meas(0, 0)) - psi_h) - zbar)}}; const T r = sm / std::hypot(m_w(0, 0), m_w(1, 0)); return correct(sp, Zrel, y, Mat<1, 1, T>{{r * r}}); }
private: template <std::size_t R, std::size_t C> static Vec3<T> rows3(const Mat<R, C, T>& X, std::size_t i, std::size_t c0) { return Vec3<T>{{X(i, c0), X(i, c0 + 1), X(i, c0 + 2)}}; }
// Standard UKF measurement update given the model outputs Z at the sigma points. // y is the innovation, already formed by the caller. template <std::size_t M> bool correct(const SigmaPoints<N, T>& sp, const Mat<K, M, T>& Z, const Mat<M, 1, T>& y, const Mat<M, M, T>& R) { Mat<1, M, T> zbar{}; for (std::size_t i = 0; i < K; i++) for (std::size_t j = 0; j < M; j++) zbar(0, j) += sp.Wm[i] * Z(i, j); Mat<M, M, T> S = R; Mat<N, M, T> Pxz{}; for (std::size_t i = 0; i < K; i++) for (std::size_t r = 0; r < M; r++) { const T dr = Z(i, r) - zbar(0, r); for (std::size_t c = 0; c < M; c++) S(r, c) += sp.Wc[i] * dr * (Z(i, c) - zbar(0, c)); for (std::size_t k = 0; k < N; k++) Pxz(k, r) += sp.Wc[i] * sp.X(i, k) * dr; } Mat<M, M, T> L = S; if (!cholesky(L)) return false; const Mat<N, M, T> Kg = chol_solve(L, Pxz.transpose()).transpose(); const Mat<N, 1, T> dx = Kg * y; P = (P - Kg * S * Kg.transpose()).symmetrized(); inject(dx); return true; }predict 里 q_ref.conj() * qi[i] 再 .log() 就是 ,是第 4 篇的四元数运算直接复用。correct 是个模板函数,M 由 Z 的列数推断:加速度计 ,航向 ,同一份代码。
C
int kl_ukf_att_predict(kl_ukf_att *f, const kl_real gyro[3], kl_real dt){ kl_real *bi = f->work, *D = bi + 3 * NP, *cov = D + N * NP; kl_real mean[N], dev[N], q_ref[4], qc[4], t[4], dq[4], qn[4]; if (kl_ukf_sigma_points(f->P, f->X, f->Wm, f->Wc) != 0) return -1; point_attitudes(f); /* each point through the gyro model */ for (int i = 0; i < NP; i++) { kl_real w[3]; for (int k = 0; k < 3; k++) { bi[i * 3 + k] = f->b[k] + f->X[i * N + 3 + k]; w[k] = (gyro[k] - bi[i * 3 + k]) * dt; } kl_quat_exp(w, dq); kl_quat_mul(&f->qi[i * 4], dq, t); kl_mat_copy(t, &f->qi[i * 4], 4, 1); } /* deviations from the propagated centre point */ kl_mat_copy(f->qi, q_ref, 4, 1); kl_quat_conj(q_ref, qc); for (int i = 0; i < NP; i++) { kl_quat_mul(qc, &f->qi[i * 4], t); kl_quat_log(t, &D[i * N]); for (int k = 0; k < 3; k++) D[i * N + 3 + k] = bi[i * 3 + k] - f->b[k]; } for (int k = 0; k < N; k++) mean[k] = 0; for (int i = 0; i < NP; i++) for (int k = 0; k < N; k++) mean[k] += f->Wm[i] * D[i * N + k]; for (int i = 0; i < N * N; i++) cov[i] = 0; for (int i = 0; i < NP; i++) { for (int k = 0; k < N; k++) dev[k] = D[i * N + k] - mean[k]; for (int a = 0; a < N; a++) for (int c = 0; c < N; c++) cov[a * N + c] += f->Wc[i] * dev[a] * dev[c]; } kl_quat_exp(mean, dq); kl_quat_mul(q_ref, dq, qn); kl_mat_copy(qn, f->q, 4, 1); for (int k = 0; k < 3; k++) { f->b[k] += mean[3 + k]; cov[k * 7] += f->sg * f->sg * dt * dt; cov[(k + 3) * 7] += f->sbw * f->sbw * dt; } kl_mat_copy(cov, f->P, N, N); return 0;}
/* Move the error estimate into the nominal state, then reset the error to zero. */static int correct(kl_ukf_att *f, int m, const kl_real *y, const kl_real *R){ kl_real *dz = f->work, *S = dz + NP * m, *Pxz = S + m * m, *Kt = Pxz + N * m; kl_real *K = Kt + m * N, *KS = K + N * m, *KSKt = KS + N * m; kl_real zbar[3], dx[N]; for (int k = 0; k < m; k++) zbar[k] = 0; for (int i = 0; i < NP; i++) for (int k = 0; k < m; k++) zbar[k] += f->Wm[i] * f->Z[i * m + k]; for (int i = 0; i < m * m; i++) S[i] = R[i]; for (int i = 0; i < N * m; i++) Pxz[i] = 0; for (int i = 0; i < NP; i++) { for (int k = 0; k < m; k++) dz[i * m + k] = f->Z[i * m + k] - zbar[k]; for (int a = 0; a < m; a++) for (int c = 0; c < m; c++) S[a * m + c] += f->Wc[i] * dz[i * m + a] * dz[i * m + c]; for (int a = 0; a < N; a++) for (int c = 0; c < m; c++) Pxz[a * m + c] += f->Wc[i] * f->X[i * N + a] * dz[i * m + c]; } /* K^T = S^-1 Pxz^T by Cholesky; the factor goes in KS, which is free until below */ kl_mat_copy(S, KS, m, m); if (kl_chol(KS, m) != 0) return -1; kl_mat_transpose(Pxz, Kt, N, m); kl_chol_solve(KS, Kt, m, N); kl_mat_transpose(Kt, K, m, N); kl_mat_mul(K, y, dx, N, m, 1); kl_mat_mul(K, S, KS, N, m, m); kl_mat_mul_bt(KS, K, KSKt, N, m, N); kl_mat_sub(f->P, KSKt, f->P, N, N); kl_mat_symmetrize(f->P, N); inject(f, dx); return 1;}C 版里 inject 是文件内静态函数的又一份拷贝,没有和 ESKF 的共用:ESKF 的 inject 是 static,我没有为了去重去改前一章已经定稿的文件。三个语言的 UKF 都各自有一份几行的 inject。
Rust
pub fn predict(&mut self, gyro: [Real; 3], dt: Real) -> bool { let Some(x) = sigma_points(&self.p) else { return false; }; let (wm, wc) = weights(); let mut qi = self.point_attitudes(&x); let mut bi = [[0.0; 3]; NP]; for i in 0..NP { for k in 0..3 { bi[i][k] = self.b[k] + x[i][3 + k]; } let w = [ (gyro[0] - bi[i][0]) * dt, (gyro[1] - bi[i][1]) * dt, (gyro[2] - bi[i][2]) * dt, ]; qi[i] = qi[i] * Quat::exp(w); } // Deviations from the propagated centre point, in its tangent space. let q_ref = qi[0]; let mut d = [[0.0; N]; NP]; for i in 0..NP { let th = (q_ref.conj() * qi[i]).log(); d[i][..3].copy_from_slice(&th); for k in 0..3 { d[i][3 + k] = bi[i][k] - self.b[k]; } } let mut mean = [0.0; N]; for i in 0..NP { for k in 0..N { mean[k] += wm[i] * d[i][k]; } } let mut cov = Mat::<N, N>::zeros(); for i in 0..NP { for r in 0..N { for c in 0..N { cov.m[r][c] += wc[i] * (d[i][r] - mean[r]) * (d[i][c] - mean[c]); } } } for k in 0..3 { cov.m[k][k] += self.sg * self.sg * (dt * dt); cov.m[3 + k][3 + k] += self.sbw * self.sbw * dt; } self.q = q_ref * Quat::exp([mean[0], mean[1], mean[2]]); for k in 0..3 { self.b[k] += mean[3 + k]; } self.p = cov; true } fn correct<const M: usize>( &mut self, x: &Points, z: &[[Real; M]; NP], y: &Mat<M, 1>, r: &Mat<M, M>, ) -> bool { let (wm, wc) = weights(); let mut zbar = [0.0; M]; for i in 0..NP { for k in 0..M { zbar[k] += wm[i] * z[i][k]; } } let mut s = *r; let mut pxz = Mat::<N, M>::zeros(); for i in 0..NP { for a in 0..M { for b in 0..M { s.m[a][b] += wc[i] * (z[i][a] - zbar[a]) * (z[i][b] - zbar[b]); } for a2 in 0..N { pxz.m[a2][a] += wc[i] * x[i][a2] * (z[i][a] - zbar[a]); } } } let Some(l) = s.cholesky() else { return false; }; let k = chol_solve(&l, &pxz.transpose()).transpose(); let dx = k * *y; self.p = (self.p - k * s * k.transpose()).symmetrized(); self.inject(&dx); true }
/// Gravity-direction update. False when gated out or on Cholesky failure.完整源码:c/include/kl/kl_ukf_att.h、c/src/kl_ukf_att.c
/* Error-state unscented Kalman filter for attitude: same 6-dim error [dtheta, db] as the ESKF, * additive noise, scaled unscented transform with alpha = 1, beta = 2, kappa = 0 * (lambda = 0, so Wm[0] = 0, Wc[0] = 2 and every other weight is 1/12). * Quaternion conventions: see kl_quat.h. All storage is inline; nothing is allocated. */#ifndef KL_UKF_ATT_H#define KL_UKF_ATT_H
#include "kl/kl_real.h"
#define KL_UKF_N 6#define KL_UKF_NPTS (2 * KL_UKF_N + 1)
/* Sigma points of N(0, P): X (13 x 6, row-major) is the centre (zero) followed by * +-columns of chol((n + lambda) P); Wm and Wc are the mean and covariance weights. * Returns -1 if P is not positive definite. */int kl_ukf_sigma_points(const kl_real P[36], kl_real X[78], kl_real Wm[13], kl_real Wc[13]);
typedef struct { kl_real q[4], b[3], P[36]; kl_real sg, sbw, sa, sm; /* gyro, bias random walk, accel, mag noise */ kl_real m_w[3]; kl_real accel_gate, mag_gate; /* negative disables the gate */ int reset; /* apply the reset Jacobian after injection */ kl_real X[78], Wm[13], Wc[13], qi[52], Z[39]; /* sigma points, weights, attitudes, outputs */ kl_real work[256];} kl_ukf_att;
/* p0_diag: initial diagonal of P (6). The bias starts at zero. */void kl_ukf_att_init(kl_ukf_att *f, const kl_real q0[4], const kl_real p0_diag[6], kl_real sigma_g, kl_real sigma_bw, kl_real sigma_a, kl_real sigma_m, const kl_real m_w[3], kl_real accel_gate, kl_real mag_gate, int reset);/* Returns 0 on success, -1 if P is not positive definite (state unchanged). */int kl_ukf_att_predict(kl_ukf_att *f, const kl_real gyro[3], kl_real dt);/* Return 1 if applied, 0 if gated out, -1 on Cholesky failure (state unchanged). */int kl_ukf_att_update_accel(kl_ukf_att *f, const kl_real accel[3]);int kl_ukf_att_update_mag_heading(kl_ukf_att *f, const kl_real mag[3]);
#endif#include "kl/kl_ukf_att.h"
#include <stddef.h>
#include "kl/kl_ekf_att.h"#include "kl/kl_eskf.h"#include "kl/kl_mat.h"#include "kl/kl_quat.h"
#define N KL_UKF_N#define NP KL_UKF_NPTS#define ALPHA ((kl_real)1)#define BETA ((kl_real)2)#define KAPPA ((kl_real)0)
int kl_ukf_sigma_points(const kl_real P[36], kl_real X[78], kl_real Wm[13], kl_real Wc[13]){ const kl_real lam = ALPHA * ALPHA * (N + KAPPA) - N; kl_real L[N * N]; kl_mat_scale(P, N + lam, L, N, N); if (kl_chol(L, N) != 0) return -1; for (int j = 0; j < N; j++) X[j] = 0; for (int j = 0; j < N; j++) for (int i = 0; i < N; i++) { X[(1 + j) * N + i] = L[i * N + j]; X[(1 + N + j) * N + i] = -L[i * N + j]; } for (int i = 0; i < NP; i++) Wm[i] = Wc[i] = (kl_real)0.5 / (N + lam); Wm[0] = lam / (N + lam); Wc[0] = Wm[0] + (1 - ALPHA * ALPHA + BETA); return 0;}
void kl_ukf_att_init(kl_ukf_att *f, const kl_real q0[4], const kl_real p0_diag[6], kl_real sigma_g, kl_real sigma_bw, kl_real sigma_a, kl_real sigma_m, const kl_real m_w[3], kl_real accel_gate, kl_real mag_gate, int reset){ kl_mat_copy(q0, f->q, 4, 1); kl_mat_copy(m_w, f->m_w, 3, 1); for (int i = 0; i < 3; i++) f->b[i] = 0; for (int i = 0; i < 36; i++) f->P[i] = 0; for (int i = 0; i < N; i++) f->P[i * 7] = p0_diag[i]; f->sg = sigma_g; f->sbw = sigma_bw; f->sa = sigma_a; f->sm = sigma_m; f->accel_gate = accel_gate; f->mag_gate = mag_gate; f->reset = reset;}
/* qi[i] = q (x) exp(X[i, :3]) for every sigma point */static void point_attitudes(kl_ukf_att *f){ for (int i = 0; i < NP; i++) { kl_real dq[4]; kl_quat_exp(&f->X[i * N], dq); kl_quat_mul(f->q, dq, &f->qi[i * 4]); }}
int kl_ukf_att_predict(kl_ukf_att *f, const kl_real gyro[3], kl_real dt){ kl_real *bi = f->work, *D = bi + 3 * NP, *cov = D + N * NP; kl_real mean[N], dev[N], q_ref[4], qc[4], t[4], dq[4], qn[4]; if (kl_ukf_sigma_points(f->P, f->X, f->Wm, f->Wc) != 0) return -1; point_attitudes(f); /* each point through the gyro model */ for (int i = 0; i < NP; i++) { kl_real w[3]; for (int k = 0; k < 3; k++) { bi[i * 3 + k] = f->b[k] + f->X[i * N + 3 + k]; w[k] = (gyro[k] - bi[i * 3 + k]) * dt; } kl_quat_exp(w, dq); kl_quat_mul(&f->qi[i * 4], dq, t); kl_mat_copy(t, &f->qi[i * 4], 4, 1); } /* deviations from the propagated centre point */ kl_mat_copy(f->qi, q_ref, 4, 1); kl_quat_conj(q_ref, qc); for (int i = 0; i < NP; i++) { kl_quat_mul(qc, &f->qi[i * 4], t); kl_quat_log(t, &D[i * N]); for (int k = 0; k < 3; k++) D[i * N + 3 + k] = bi[i * 3 + k] - f->b[k]; } for (int k = 0; k < N; k++) mean[k] = 0; for (int i = 0; i < NP; i++) for (int k = 0; k < N; k++) mean[k] += f->Wm[i] * D[i * N + k]; for (int i = 0; i < N * N; i++) cov[i] = 0; for (int i = 0; i < NP; i++) { for (int k = 0; k < N; k++) dev[k] = D[i * N + k] - mean[k]; for (int a = 0; a < N; a++) for (int c = 0; c < N; c++) cov[a * N + c] += f->Wc[i] * dev[a] * dev[c]; } kl_quat_exp(mean, dq); kl_quat_mul(q_ref, dq, qn); kl_mat_copy(qn, f->q, 4, 1); for (int k = 0; k < 3; k++) { f->b[k] += mean[3 + k]; cov[k * 7] += f->sg * f->sg * dt * dt; cov[(k + 3) * 7] += f->sbw * f->sbw * dt; } kl_mat_copy(cov, f->P, N, N); return 0;}
/* Move the error estimate into the nominal state, then reset the error to zero. */static void inject(kl_ukf_att *f, const kl_real dx[6]){ kl_real *G = f->work, *T = G + 36, *U = T + 36; kl_real dq[4], qn[4]; kl_quat_exp(dx, dq); kl_quat_mul(f->q, dq, qn); kl_quat_normalize(qn); kl_mat_copy(qn, f->q, 4, 1); for (int i = 0; i < 3; i++) f->b[i] += dx[3 + i]; if (f->reset) { kl_real half[3] = {(kl_real)0.5 * dx[0], (kl_real)0.5 * dx[1], (kl_real)0.5 * dx[2]}; kl_real S[9]; kl_skew(half, S); kl_mat_identity(G, 6); for (int i = 0; i < 3; i++) for (int j = 0; j < 3; j++) G[i * 6 + j] -= S[i * 3 + j]; kl_mat_mul(G, f->P, T, 6, 6, 6); kl_mat_mul_bt(T, G, U, 6, 6, 6); kl_mat_copy(U, f->P, 6, 6); }}
/* Standard UKF measurement update given the model outputs Z (13 x m) at the sigma points X. */static int correct(kl_ukf_att *f, int m, const kl_real *y, const kl_real *R){ kl_real *dz = f->work, *S = dz + NP * m, *Pxz = S + m * m, *Kt = Pxz + N * m; kl_real *K = Kt + m * N, *KS = K + N * m, *KSKt = KS + N * m; kl_real zbar[3], dx[N]; for (int k = 0; k < m; k++) zbar[k] = 0; for (int i = 0; i < NP; i++) for (int k = 0; k < m; k++) zbar[k] += f->Wm[i] * f->Z[i * m + k]; for (int i = 0; i < m * m; i++) S[i] = R[i]; for (int i = 0; i < N * m; i++) Pxz[i] = 0; for (int i = 0; i < NP; i++) { for (int k = 0; k < m; k++) dz[i * m + k] = f->Z[i * m + k] - zbar[k]; for (int a = 0; a < m; a++) for (int c = 0; c < m; c++) S[a * m + c] += f->Wc[i] * dz[i * m + a] * dz[i * m + c]; for (int a = 0; a < N; a++) for (int c = 0; c < m; c++) Pxz[a * m + c] += f->Wc[i] * f->X[i * N + a] * dz[i * m + c]; } /* K^T = S^-1 Pxz^T by Cholesky; the factor goes in KS, which is free until below */ kl_mat_copy(S, KS, m, m); if (kl_chol(KS, m) != 0) return -1; kl_mat_transpose(Pxz, Kt, N, m); kl_chol_solve(KS, Kt, m, N); kl_mat_transpose(Kt, K, m, N); kl_mat_mul(K, y, dx, N, m, 1); kl_mat_mul(K, S, KS, N, m, m); kl_mat_mul_bt(KS, K, KSKt, N, m, N); kl_mat_sub(f->P, KSKt, f->P, N, N); kl_mat_symmetrize(f->P, N); inject(f, dx); return 1;}
int kl_ukf_att_update_accel(kl_ukf_att *f, const kl_real accel[3]){ kl_real norm = KL_SQRT(accel[0] * accel[0] + accel[1] * accel[1] + accel[2] * accel[2]); if (f->accel_gate >= 0 && KL_FABS(norm - (kl_real)KL_GRAVITY) > f->accel_gate) return 0; const kl_real down[3] = {0, 0, -1}; kl_real y[3], R[9], zbar[3] = {0, 0, 0}; if (kl_ukf_sigma_points(f->P, f->X, f->Wm, f->Wc) != 0) return -1; point_attitudes(f); for (int i = 0; i < NP; i++) { kl_ekf_att_rot_inv(&f->qi[i * 4], down, &f->Z[i * 3]); for (int k = 0; k < 3; k++) zbar[k] += f->Wm[i] * f->Z[i * 3 + k]; } kl_real r = (f->sa / (kl_real)KL_GRAVITY) * (f->sa / (kl_real)KL_GRAVITY); for (int i = 0; i < 3; i++) { y[i] = accel[i] / norm - zbar[i]; for (int j = 0; j < 3; j++) R[i * 3 + j] = (i == j) ? r : 0; } return correct(f, 3, y, R);}
int kl_ukf_att_update_mag_heading(kl_ukf_att *f, const kl_real mag[3]){ kl_real norm = KL_SQRT(mag[0] * mag[0] + mag[1] * mag[1] + mag[2] * mag[2]); if (f->mag_gate >= 0 && KL_FABS(norm - 1) > f->mag_gate) return 0; kl_real C[9], h[3], mw[3], z0[NP], zbar, y, R; if (kl_ukf_sigma_points(f->P, f->X, f->Wm, f->Wc) != 0) return -1; point_attitudes(f); kl_quat_to_dcm(f->q, C); const kl_real psi_h = KL_ATAN2(f->m_w[1], f->m_w[0]); for (int i = 0; i < NP; i++) { kl_ekf_att_rot_inv(&f->qi[i * 4], f->m_w, h); /* C(q) C(q_i)^T m_w */ kl_mat_mul(C, h, mw, 3, 3, 1); z0[i] = kl_wrap_pi(KL_ATAN2(mw[1], mw[0]) - psi_h); } /* heading relative to the centre point: no wrap trouble */ zbar = 0; for (int i = 0; i < NP; i++) { f->Z[i] = kl_wrap_pi(z0[i] - z0[0]); zbar += f->Wm[i] * f->Z[i]; } zbar += z0[0]; kl_mat_mul(C, mag, mw, 3, 3, 1); y = kl_wrap_pi(kl_wrap_pi(KL_ATAN2(mw[1], mw[0]) - psi_h) - zbar); R = (f->sm / KL_SQRT(f->m_w[0] * f->m_w[0] + f->m_w[1] * f->m_w[1])); R = R * R; return correct(f, 1, &y, &R);}完整源码:cpp/include/kl/ukf.hpp
完整源码:rust/src/ukf.rs
//! Error-state unscented Kalman filter for attitude: the same 6-dim error as the//! ESKF (dtheta, db), additive noise, scaled unscented transform.#![allow(clippy::needless_range_loop)]
use crate::ekf_att::{G, rot_inv};use crate::eskf::wrap_pi;use crate::mat::{Mat, chol_solve};use crate::quat::{Quat, skew};use crate::real::{Real, atan2, fabs, sqrt};
const N: usize = 6;const NP: usize = 2 * N + 1;/// Scaled UT with alpha = 1, beta = 2, kappa = 0: lambda = 0, so the centre/// point has mean weight 0 and the other 2n points share the weight 1/(2n).const LAMBDA: Real = 0.0;const BETA: Real = 2.0;const ALPHA2: Real = 1.0;
pub type Points = [[Real; N]; NP];
fn weights() -> ([Real; NP], [Real; NP]) { let n = N as Real; let mut wm = [0.5 / (n + LAMBDA); NP]; let mut wc = wm; wm[0] = LAMBDA / (n + LAMBDA); wc[0] = wm[0] + (1.0 - ALPHA2 + BETA); (wm, wc)}
/// Sigma points around zero for N(0, P): the centre, then +-columns of/// chol((n + lambda) P). Returns `None` if P is not positive definite.pub fn sigma_points(p: &Mat<N, N>) -> Option<Points> { let l = (*p * (N as Real + LAMBDA)).cholesky()?; let mut x = [[0.0; N]; NP]; for j in 0..N { for i in 0..N { x[1 + j][i] = l.m[i][j]; x[1 + N + j][i] = -l.m[i][j]; } } Some(x)}
fn dot(a: [Real; 3], b: [Real; 3]) -> Real { a[0] * b[0] + a[1] * b[1] + a[2] * b[2]}
pub struct AttitudeUkf { pub q: Quat, pub b: [Real; 3], pub p: Mat<N, N>, sg: Real, sbw: Real, sa: Real, sm: Real, m_w: [Real; 3], /// Gates on | |f| - g | (m/s^2) and | |m| - 1 |; negative disables gating. accel_gate: Real, mag_gate: Real, reset: bool,}
impl AttitudeUkf { #[allow(clippy::too_many_arguments)] pub fn new( q0: Quat, p0_diag: [Real; N], sigma_g: Real, sigma_bw: Real, sigma_a: Real, sigma_m: Real, m_w: [Real; 3], accel_gate: Real, mag_gate: Real, reset: bool, ) -> Self { let mut p = Mat::zeros(); for (i, d) in p0_diag.iter().enumerate() { p.m[i][i] = *d; } Self { q: q0, b: [0.0; 3], p, sg: sigma_g, sbw: sigma_bw, sa: sigma_a, sm: sigma_m, m_w, accel_gate, mag_gate, reset, } }
/// Sigma-point attitudes q (x) exp(dtheta_i). fn point_attitudes(&self, x: &Points) -> [Quat; NP] { x.map(|r| self.q * Quat::exp([r[0], r[1], r[2]])) }
/// Propagate every sigma point through the gyro model. False (state /// unchanged) if P is not positive definite. pub fn predict(&mut self, gyro: [Real; 3], dt: Real) -> bool { let Some(x) = sigma_points(&self.p) else { return false; }; let (wm, wc) = weights(); let mut qi = self.point_attitudes(&x); let mut bi = [[0.0; 3]; NP]; for i in 0..NP { for k in 0..3 { bi[i][k] = self.b[k] + x[i][3 + k]; } let w = [ (gyro[0] - bi[i][0]) * dt, (gyro[1] - bi[i][1]) * dt, (gyro[2] - bi[i][2]) * dt, ]; qi[i] = qi[i] * Quat::exp(w); } // Deviations from the propagated centre point, in its tangent space. let q_ref = qi[0]; let mut d = [[0.0; N]; NP]; for i in 0..NP { let th = (q_ref.conj() * qi[i]).log(); d[i][..3].copy_from_slice(&th); for k in 0..3 { d[i][3 + k] = bi[i][k] - self.b[k]; } } let mut mean = [0.0; N]; for i in 0..NP { for k in 0..N { mean[k] += wm[i] * d[i][k]; } } let mut cov = Mat::<N, N>::zeros(); for i in 0..NP { for r in 0..N { for c in 0..N { cov.m[r][c] += wc[i] * (d[i][r] - mean[r]) * (d[i][c] - mean[c]); } } } for k in 0..3 { cov.m[k][k] += self.sg * self.sg * (dt * dt); cov.m[3 + k][3 + k] += self.sbw * self.sbw * dt; } self.q = q_ref * Quat::exp([mean[0], mean[1], mean[2]]); for k in 0..3 { self.b[k] += mean[3 + k]; } self.p = cov; true }
fn inject(&mut self, dx: &Mat<N, 1>) { let dth = [dx.m[0][0], dx.m[1][0], dx.m[2][0]]; self.q = (self.q * Quat::exp(dth)).normalized(); for i in 0..3 { self.b[i] += dx.m[3 + i][0]; } if self.reset { let s = skew([0.5 * dth[0], 0.5 * dth[1], 0.5 * dth[2]]); let mut g = Mat::<N, N>::identity(); for i in 0..3 { for j in 0..3 { g.m[i][j] -= s.m[i][j]; } } self.p = g * self.p * g.transpose(); } }
/// Standard UKF correction given model outputs `z` at the sigma points `x`. /// False (state unchanged) if S is not positive definite. fn correct<const M: usize>( &mut self, x: &Points, z: &[[Real; M]; NP], y: &Mat<M, 1>, r: &Mat<M, M>, ) -> bool { let (wm, wc) = weights(); let mut zbar = [0.0; M]; for i in 0..NP { for k in 0..M { zbar[k] += wm[i] * z[i][k]; } } let mut s = *r; let mut pxz = Mat::<N, M>::zeros(); for i in 0..NP { for a in 0..M { for b in 0..M { s.m[a][b] += wc[i] * (z[i][a] - zbar[a]) * (z[i][b] - zbar[b]); } for a2 in 0..N { pxz.m[a2][a] += wc[i] * x[i][a2] * (z[i][a] - zbar[a]); } } } let Some(l) = s.cholesky() else { return false; }; let k = chol_solve(&l, &pxz.transpose()).transpose(); let dx = k * *y; self.p = (self.p - k * s * k.transpose()).symmetrized(); self.inject(&dx); true }
/// Gravity-direction update. False when gated out or on Cholesky failure. pub fn update_accel(&mut self, accel: [Real; 3]) -> bool { let norm = sqrt(dot(accel, accel)); if self.accel_gate >= 0.0 && fabs(norm - G) > self.accel_gate { return false; } let Some(x) = sigma_points(&self.p) else { return false; }; let (wm, _) = weights(); let qi = self.point_attitudes(&x); let z = qi.map(|q| rot_inv(q, [0.0, 0.0, -1.0])); let mut y = Mat::<3, 1> { m: [[accel[0] / norm], [accel[1] / norm], [accel[2] / norm]], }; for i in 0..NP { for k in 0..3 { y.m[k][0] -= wm[i] * z[i][k]; } } let r = Mat::<3, 3>::identity() * ((self.sa / G) * (self.sa / G)); self.correct(&x, &z, &y, &r) }
/// Heading-only magnetometer update. False when gated out or on Cholesky failure. pub fn update_mag_heading(&mut self, mag: [Real; 3]) -> bool { let norm = sqrt(dot(mag, mag)); if self.mag_gate >= 0.0 && fabs(norm - 1.0) > self.mag_gate { return false; } let Some(x) = sigma_points(&self.p) else { return false; }; let (wm, _) = weights(); let qi = self.point_attitudes(&x); let c = self.q.dcm(); let rot = |v: [Real; 3]| -> [Real; 3] { [dot(c.m[0], v), dot(c.m[1], v), dot(c.m[2], v)] }; let psi_h = atan2(self.m_w[1], self.m_w[0]); let z0 = qi.map(|q| { let mw = rot(rot_inv(q, self.m_w)); wrap_pi(atan2(mw[1], mw[0]) - psi_h) }); // Headings relative to the centre point: no wrap trouble near +-pi. let zrel = z0.map(|v| [wrap_pi(v - z0[0])]); let mut zbar = z0[0]; for i in 0..NP { zbar += wm[i] * zrel[i][0]; } let mm = rot(mag); let y = wrap_pi(wrap_pi(atan2(mm[1], mm[0]) - psi_h) - zbar); let mh = sqrt(self.m_w[0] * self.m_w[0] + self.m_w[1] * self.m_w[1]); let r = Mat { m: [[(self.sm / mh) * (self.sm / mh)]], }; self.correct(&x, &zrel, &Mat { m: [[y]] }, &r) }}
/// Weights, exposed for the self-check.pub fn unscented_weights() -> ([Real; NP], [Real; NP]) { weights()}三个 app(c/apps/ch07.c、cpp/apps/ch07.cpp、rust/src/bin/ch07.rs)先做 sigma 点自检:对 ,、 都要在 内成立(float 构建是 )。然后处理第 6 篇的两个初始条件,写 out/ch07/ukf_{nominal,large}_<lang>.csv。
结果
$ make -s ch07sigma point check: worst error 8.882e-16ch07 self-check passed (worst 8.88e-16)ok ukf_large_c.csv: max diff 1.037e-13 <= 1.0e-09ok ukf_large_cpp.csv: max diff 7.694e-14 <= 1.0e-09ok ukf_large_rs.csv: max diff 7.622e-14 <= 1.0e-09ok ukf_nominal_c.csv: max diff 8.227e-14 <= 1.0e-09ok ukf_nominal_cpp.csv: max diff 6.395e-14 <= 1.0e-09ok ukf_nominal_rs.csv: max diff 6.761e-14 <= 1.0e-09Python 参考的 UKF 和三种语言的输出最大差异在 量级(比第 6 篇 ESKF 的 大了两个数量级):13 个点的加权求和和 Cholesky 里累积的舍入多了。
玩具问题
Polar to Cartesian: r ~ N(1, 0.02^2), theta ~ N(pi/2, 0.5^2) mean x mean y var x var y cov xyMonte Carlo 1e6 -0.0006 0.8827 0.19641 0.02486 0.00017linearization 0.0000 1.0000 0.25000 0.00040 -0.00000unscented 0.0000 0.8801 0.21101 0.04351 -0.00000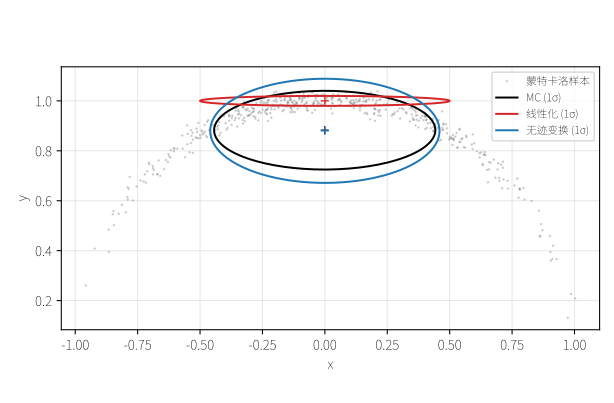
均值:蒙特卡洛 ,线性化 ,UT 。UT 抓到了二阶项,这是上面推导的实证。方差: 方向真实是 0.02486,线性化给了 0.00040,小了 62 倍;UT 给了 0.04351,偏大 1.75 倍。所以 UT 不是”更准”,它是”没有系统性漏掉一个量级”:它的方差偏大,在滤波里偏保守,这个方向相对安全。图里蓝色椭圆比黑色大,红色椭圆扁成了一条线。
四个滤波器同台
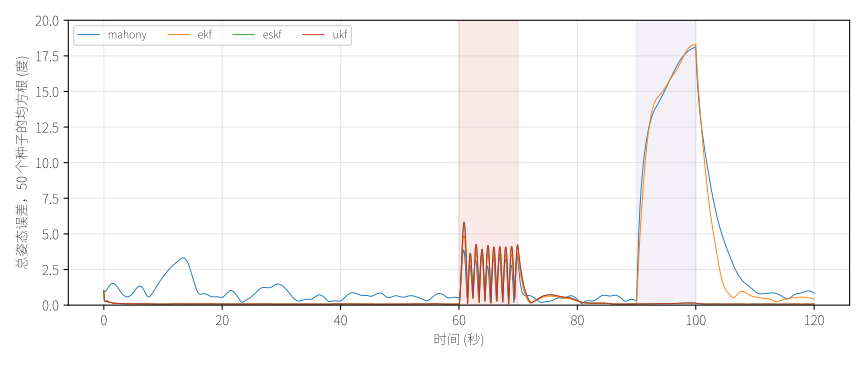
Four filters, seeds 1..50, 120 s each (deg RMS pooled over seeds and time)method yaw pitch roll total calm tot mean NEES calm NEES in boundsmahony 4.391 1.488 2.243 4.880 0.733 - - -ekf 4.504 0.685 1.120 4.721 0.074 9557.93 6.048 96.5%eskf 0.599 0.592 0.866 0.929 0.075 895.58 6.048 96.0%ukf 0.599 0.592 0.866 0.929 0.075 895.47 6.048 96.0%(NEES 6 dof, mean of 50 runs; 95% bounds [5.078, 6.997]; 'in bounds' = fraction of calm [20,60) steps)读这张表的几个地方:
- UKF 与 ESKF 在三位小数内没有区别:总误差 0.929 对 0.929,平静段 0.075 对 0.075,NEES 895.47 对 895.58,落界比例都是 96.0%。这个问题里,误差是度级甚至零点几度的小量,线性化几乎是精确的,UT 没有可以补的东西。它花了 13 倍的传播和 26 次 求值(下面的清单),换来的是和 ESKF 一样的结果。
- EKF 的整段 RMSE 和平均 NEES 是 4.721 度和 9558,被磁干扰拖累;平静段()的总误差是 0.074 度,和 ESKF、UKF 的 0.075 没有区别,NEES 都是 6.048。这三者在没有干扰时,等价于同一个滤波器的三种写法。
- Mahony 的平静段误差 0.733 度,是卡尔曼三兄弟的 10 倍:卡尔曼滤波器的好处主要体现在这里,增益自己算。
- 没有哪个滤波器的整段数字好看,因为线加速度窗口(60 到 70 秒)对所有人都是未建模的扰动。
模型评估次数(每个滤波步):
- Mahony:2 个预测方向,没有协方差。
- EKF:1 次传播,2 次 求值加 2 个解析的 雅可比, 协方差。
- ESKF:1 次传播,2 次 求值加 2 个解析雅可比, 协方差。
- UKF:13 次传播( 个 sigma 点), 次 求值,没有雅可比, 协方差。
每步的耗时放到第 8 篇一起测。
大初始误差:UKF 赢了
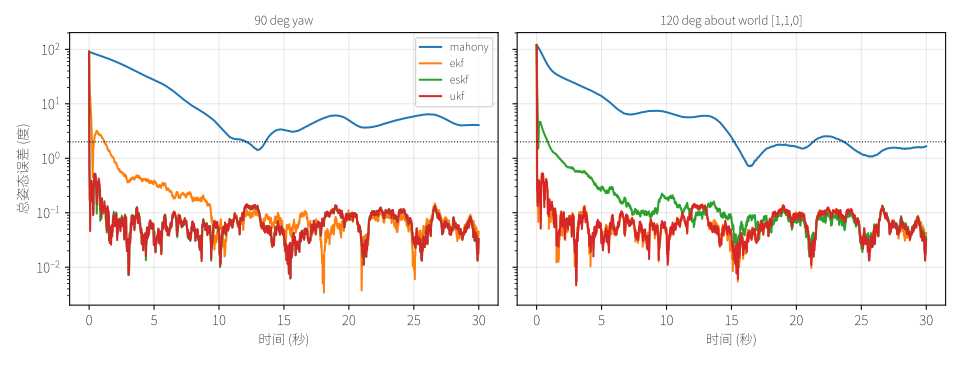
Large initial error, seed 1: time until the total error stays below 2 deg for 5 s (error at 10 s) 90 deg yaw | mahony 43.28 s (3.96) | ekf 1.18 s (0.05) | eskf 0.02 s (0.04) | ukf 0.01 s (0.04) 120 deg about world [1,1,0] | mahony 15.21 s (7.00) | ekf 0.01 s (0.04) | eskf 0.86 s (0.18) | ukf 0.04 s (0.04)括号里是 10 秒时的误差(度)。第 6 篇我用的两个大误差初始条件:
- 90 度偏航误差:UKF 0.01 秒,ESKF 0.02 秒,EKF 1.18 秒,Mahony 43.28 秒。
- 120 度、绕世界 :UKF 0.04 秒,EKF 0.01 秒,ESKF 0.86 秒,Mahony 15.21 秒。
只有 UKF 在两种情形里都在几十毫秒内收敛:EKF 和 ESKF 各有一个情形慢了一个数量级。它不是赢了精度,是赢了鲁棒性。我猜道理是 sigma 点把大范围的不确定度( 弧度的散布)真的当成了非线性函数的输入,而 EKF 和 ESKF 只在一个点上线性化;但我没有做更多的实验来证实这个解释,所以这只是一个猜测。Mahony 在两种情形里都需要十几到几十秒,我猜是因为它的增益 是固定的,对大误差来说是个慢滤波。
粒子滤波,只给个路标
UKF 用 13 个点表示一个高斯。如果后验分布明显不是高斯(比如多峰),点数再多也没用,需要粒子滤波:用成百上千个带权样本直接表示任意分布,靠重采样避免权重退化。它的代价是每步要传播几百到几千个粒子,不适合我们这个 100 Hz 的姿态估计。我没有实现它。要读的话,Arulampalam 等人的 “A tutorial on particle filters for online nonlinear/non-Gaussian Bayesian tracking”(IEEE TSP 2002)是一份很清晰的入门,Doucet、de Freitas、Gordon 编的 Sequential Monte Carlo Methods in Practice(2001)是更完整的参考。UKF 的原始论文是 Julier 和 Uhlmann 的 “A new extension of the Kalman filter to nonlinear systems”(1997),缩放参数的版本来自 Wan 和 van der Merwe 的 “The unscented Kalman filter for nonlinear estimation”(2000)。
下一篇
三个卡尔曼滤波器在这个问题上,精度几乎没有区别,真正的区别是:每步花多少算力,数字格式(float32)能不能撑住,内存是不是固定。下一篇是整个系列的最后一篇,我们把这些全部量一量:在 float32 下把 KF、ESKF、UKF 跑一遍,看和 double 参考差多少;实现 UD 分解,看协方差的数值健康;打印每个滤波器结构体的字节数;检验库里没有堆分配;把 C 的滤波器编译到 Cortex-M4 上看代码大小;测每步的耗时,包括 Python 慢多少。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!