
 Better Mistakes



音乐
暂未播放
整定:Ziegler–Nichols、继电器自整定与 SIMC
手调 PID 最常见的一招是:Ki、Kd 先放着,把 Kp 一点点加大,直到电机开始啸叫,再退回去一半左右。这个手艺有名字,它是 Ziegler 和 Nichols 1942 年发表的“临界增益法”的手动版,“一半左右”大致对应他们的 。这一篇我把“凭手感”拆成三个可以写成函数的步骤:测一条阶跃响应,拟合一个一阶加延迟模型;或者让继电器替我把回路推到临界振荡,读出 和 ;再用 Ziegler–Nichols 或 Skogestad 的 SIMC 规则算增益。 对象是第 5 篇的两个:一个带电流环和 2 拍指令延迟的摩擦轮,一个教科书里的 。结果比我预想的难看:阶跃法在摩擦轮上给出了一组线性回路不稳定的增益,继电器法在摩擦轮上读出的 比真值小 2.7 倍,而这个偏小的值恰好给出了最安全的一组增益。
这一篇结束时你会有:make ch06 通过,out/ch06/ 下 56 个 CSV(两个对象各 7 个算例:step、relay、ident、tuning,以及 eval_<plant>_{zn_step,zn_ultimate,simc},每个 Python、C、C++、Rust 各一份),figures/ch06/ 下 5 张图;以及阶跃拟合、描述函数、Ziegler–Nichols 和 SIMC 的推导。
新增模块:Python 是 pidlab/tuning.py(fopdt_fit、Relay、relay_analyse、zn_step、zn_ultimate、simc_pi),另外在 pidlab/plants.py 里加了 Flywheel 和 Benchmark4;C 是 pl/tuning.h 和 tuning.c(plants.h、plants.c 里加了 pl_flywheel、pl_benchmark4);C++ 是 pidlab/tuning.h(plants.h 里加了 Flywheel<T>、Benchmark4<T>);Rust 是 tuning.rs(plants.rs 里加了 Flywheel、Benchmark4)。评估用的是第 5 篇的 Pid,没有新的控制器代码。
前置:第 5 篇。需要的数学:一阶系统的阶跃响应,第 3 篇的 Bode 图和灵敏度峰值 ,一点点傅里叶级数。
这一篇的代码都很短,我把它们和对应的推导放在一起,哪一步的数学落成哪几行代码,一眼能看到。完整文件在仓库里,文末的检查点给了链接。
从对象到规则
两个对象
摩擦轮是这一篇新加的第一个对象,装在转子侧:
是折算成电流的负载(A),指令 先过 2 拍(2 ms)的传输延迟,再进电流环。参数是 kg·m²、、 ms,全是我取的。 N·m/A:0.3 来自第 1 篇引用的 M3508 P19 手册,3591/187 是我记得的 P19 减速比,这个比值我没有从手册里核实,当作假设。所以直流增益 rad/s 每安培,机械时间常数 s,而电流环加延迟加起来只有 3 ms:一个典型的“滞后主导”对象, 大约 667。
四阶对象 是整定论文里常见的基准,它有 4 个重合的极点,没有延迟,但慢极点串起来的效果很像延迟。它的采样周期 ms,无限幅。
两个新对象放在 pidlab/plants.py。摩擦轮把 2 拍延迟留给仿真的 DelayLine(和第 2 篇起的 DialPosition 一样,延迟属于回路不属于 ODE),所以类里只有两个状态 和两路输入 :
@dataclassclass Flywheel: # ... kt: float = 0.3 / (3591.0 / 187.0) j: float = 4e-4 b: float = 2e-4 tau_c: float = 0.001 u_max: float = 20.0
n = 2 m = 2 delay = 2
def deriv(self, x, u): return [ (self.kt * (x[1] - u[1]) - self.b * x[0]) / self.j, (u[0] - x[1]) / self.tau_c, ]四阶对象是四个串联的一阶滞后,负载 从输入端减去:
@dataclassclass Benchmark4: # ... tau: float = 1.0
n = 4 m = 2
def deriv(self, x, u): return [ (u[0] - u[1] - x[0]) / self.tau, (x[0] - x[1]) / self.tau, (x[1] - x[2]) / self.tau, (x[2] - x[3]) / self.tau, ]一阶加延迟模型
整定规则几乎都吃同一种模型,FOPDT(first-order plus dead time):
是静态增益, 是时间常数, 是等效延迟。给输入一个阶跃 ,输出的归一化响应 ( 是最终变化量)在 之后是
只有 和 两个未知数,读两个点就够了。我取 28.3% 和 63.2%: 时 ; 时 。记这两个时刻为 和 ,则
这个拟合的便宜之处是它对噪声不敏感(只用了两个点),代价是它把“1.5”和“0.283、0.632”这些取整的常数都当成精确的。 当 比 大几百倍的时候,取整误差会把 吃掉:精确的常数是 0.9997 和 0.6670×1.5 = 1.0005, 的误差是 ,对 s 就是 1.7 ms。我先写在这里,后面的摩擦轮会撞上它。
写成代码,这个拟合就是 pidlab/tuning.py 里的 fopdt_fit。它先用线性插值找两个交叉时间,再套上面的三个式子:
def _cross(z: Sequence[float], level: float, ts: float) -> float: # ... for i in range(1, len(z)): if z[i] >= level: frac = (level - z[i - 1]) / (z[i] - z[i - 1]) return (i - 1 + frac) * ts return math.nandef fopdt_fit(u: Sequence[float], y: Sequence[float], ts: float) -> Fopdt: # ... k0 = next((i for i, ui in enumerate(u) if ui != u[0]), -1) if k0 < 0: raise ValueError("no step in u") du = u[k0] - u[0] y0 = y[k0] dy = y[-1] - y0 if dy == 0.0: raise ValueError("y did not move") z = [(y[i] - y0) / dy for i in range(k0, len(y))] t28 = _cross(z, T28, ts) t63 = _cross(z, T63, ts) tau = 1.5 * (t63 - t28) theta = t63 - tau if not (tau > 0.0 and theta > 0.0): raise ValueError("no usable first-order-plus-delay fit") return Fopdt(dy / du, tau, theta)插值是必须的。 采样周期是 1 ms 和 10 ms,、 不会正好落在采样点上,不插值会引入最多一个采样周期的误差,对摩擦轮的 (1.39 ms)这个误差就是 70%。另外,fopdt_fit 要求记录已经稳定:终值直接取最后一个采样点,不外推。我的摩擦轮阶跃记录 20 s, s,是 10 倍时间常数;四阶对象记录 40 s,足够。
Ziegler–Nichols 两套规则
两套规则都输出 PID 的参数,我统一换成并联形式 ,其中 、。
阶跃法(reaction curve): 用 FOPDT 的三个参数。
据我所知原文是用“反应速率” 和延迟 写的,,两种写法相同。这条规则为什么长这样?拿一个滞后主导的对象,,开环近似成积分器加延迟 。,所以回路增益在 处穿过 1。在这个频率上,延迟贡献 rad ,积分器 ,PID 的相位是 ,合计 ,相位裕度大约 32°。我另外跑了一个一次性的脚本核对(没有放进仓库): 时 32.3°,500 时 31.5°。32° 的相位裕度意味着阶跃响应很振荡,据我所知这是故意的:原文追求的是扰动响应每个周期衰减到四分之一,不是平滑。Skogestad 的论文也把 Ziegler–Nichols 的设定叫做 “rather aggressive”。
临界法(ultimate cycle): 只用 P 控制把回路推到等幅振荡,读出此时的增益 和周期 :
是奈奎斯特曲线穿过 时 的倒数,。 意味着只用了 4.4 dB 的增益裕度,再扣掉 PI 加 D 在这一频率附近的相位影响,就是一个不太宽裕的回路。
两套规则都是几行算术,输出统一的 Gains(kp, ki, kd),所以后面可以直接喂给第 5 篇的 PidConfig:
def zn_step(m: Fopdt) -> Gains: kp = 1.2 * m.tau / (m.k * m.theta) return Gains(kp, kp / (2.0 * m.theta), kp * (0.5 * m.theta))
def zn_ultimate(ku: float, pu: float) -> Gains: kp = 0.6 * ku return Gains(kp, kp / (pu / 2.0), kp * (pu / 8.0))继电器和描述函数
手动加 Kp 到振荡有两个毛病:要有人盯着,而且真的会把电机推到振荡的边缘。Åström 和 Hägglund 1984 年的方案是用继电器代替手:控制器输出 或 ,误差变号就翻转,回路自己会找到一个极限环,极限环的幅值和周期里带着 和 。这跟推秋千一样:你不需要知道秋千的固有频率,只要每次在它过最低点的时候推一把,它自己会稳定在它的固有频率上。
设继电器输入 ,输出是幅值 的方波(先令滞环 )。方波的基波分量用傅里叶系数算:
项由对称性为 0。描述函数把继电器当成一个幅值相关的增益,只保留基波:
回路是继电器 加线性对象 的负反馈。持续振荡要求基波绕回来后自洽(谐波平衡):,即
右边是负实轴上的一点,所以 就是 穿过 的频率 ,;幅值条件 给出
近似的前提是对象是低通的, 里的三次、五次谐波可以忽略。 四阶对象有四个极点,这个假设成立得很好,后面的图里 看起来是干净的正弦。
现实里继电器有滞环 (也是为了不被噪声反复触发):误差上升过 才翻到 ,下降过 才翻到 。方波因此相对输入滞后一个角度 ,基波的幅值仍然是 ,但在原来的相位上多了 的滞后。展开:基波是 ,所以
(精确的复数形式里实部是 ,虚部是 ,模长是 。)谐波平衡变成
相位是 。有滞环的继电器测的不是 那一点,而是 往回一点的位置,这个位置比 低, 更大,所以读出来的 比真正的 小。后面摩擦轮的实验会用上这个结论。
代码分两块。继电器本身是一个带状态的小类,初始状态是 ,只在 时翻转, 和 是构造参数:
class Relay: # ... def update(self, e: float) -> float: if self.state > 0 and e < -self.eps: self.state = -1 elif self.state < 0 and e > self.eps: self.state = 1 return self.state * self.d然后是事后分析一份记录的 relay_analyse。“上升沿”定义成 u 从非正变成正的那一个采样点,时间用 穿过 的线性插值;周期取最后三个周期的平均,幅值 取最后一个周期里 峰峰值的一半:
def relay_analyse( r: Sequence[float], y: Sequence[float], u: Sequence[float], ts: float, eps: float, d: float,) -> RelayResult: # ... ups = [] for k in range(1, len(u)): if u[k] > 0.0 and u[k - 1] <= 0.0: e0 = r[k - 1] - y[k - 1] e1 = r[k] - y[k] ups.append((k, (k - 1 + (eps - e0) / (e1 - e0)) * ts)) if len(ups) < 4: raise ValueError("fewer than four upward switches") pu = (ups[-1][1] - ups[-4][1]) / 3.0 seg = y[ups[-2][0] : ups[-1][0]] a = (max(seg) - min(seg)) / 2.0 return RelayResult(4.0 * d / (math.pi * a), pu, a)这个函数不进控制回路,所以没有状态机,也不需要就地更新,只是读一份已经记录好的数据。
SIMC
SIMC(Skogestad IMC)是从另一个方向想问题:先指定想要的闭环响应,再反推控制器。对 FOPDT 对象 ,指定设定值到输出的闭环响应保留不可避免的延迟,其余是一阶:
是唯一的整定参数。从 解出控制器 ,,代入得
这是个史密斯预估器的形状,没法直接放进 PID。用一阶泰勒 ,分母变成 :
这是 PI,积分时间等于对象的时间常数:积分项把对象的极点消掉。对设定值很好,对负载扰动,如果 很大(像摩擦轮的 2 s), 会让扰动恢复得很慢。Skogestad 的修正是限制 :把对象近似成积分器 (),PI 的闭环特征式是
临界阻尼要求判别式 ,即 。把 代入得 。两个限制取小的:
这个推导我对照了 Skogestad 2003 的式(19)到式(24)。 是他推荐的“紧”整定,我默认就用它:,。要更保守就加大 ,不用换公式,这是 SIMC 比 Ziegler–Nichols 好用的地方。同一篇论文还说:数字实现时采样周期 对等效延迟贡献约 (ZOH 平均要等半个采样周期);这一点我后面要用。
对应的代码只有三行有效算术,tauc 默认取 theta,返回的 Gains 里 :
def simc_pi( k: float, tau: float, theta: float, tauc: float | None = None) -> Gains: # ... if tauc is None: tauc = theta kp = tau / (k * (tauc + theta)) ti = min(tau, 4.0 * (tauc + theta)) return Gains(kp, kp / ti, 0.0)鲁棒性与性能
比较三套规则需要至少两个指标:
- 性能: IAE ,设定值阶跃之后算一次(
IAE_sp),负载阶跃之后算一次(IAE_ld);再加设定值阶跃的超调。 - 鲁棒性: 第 3 篇的灵敏度峰值 ,它是奈奎斯特曲线到 的最近距离的倒数。 在 1.4 到 2 之间通常算稳妥,更大就是离 太近。我用
freq模块在真实对象(含延迟和第 4 篇的半拍 ZOH)上算。
注意: 只在回路稳定时是个有意义的“距离”。 不稳定的回路 的最小值也可以很大;后面摩擦轮的阶跃法就是例子。
评估用第 5 篇的 Pid:CLAMP 抗饱和,微分滤波 ,输出夹在执行器范围内。设定值阶跃之后,在一半的时间点加一个负载阶跃。
驱动 python/ch06_tuning.py 里有三条线:开环阶跃、继电器、闭环评估,都走第 5 篇的仿真合同(测量、控制器、限幅、延迟线、保持 10 个 RK4 子步)。simulate 把三种“控制器”收成一个 ctrl(k, r, y) -> u 回调:
def simulate(spec: Spec, data: dict, ctrl) -> dict[str, np.ndarray]: # ... plant = spec.plant() delay = DelayLine(spec.delay) x = [0.0] * plant.n rows = [] for k in range(len(data["t"])): r = data["r"][k] y = plant.output(x) + data["n"][k] u = ctrl(k, r, y) u = min(max(u, -spec.u_lim), spec.u_lim) rows.append([data["t"][k], r, y, u]) x = advance( plant.deriv, x, [delay.push(u), data["d"][k]], spec.ts, SUBSTEPS ) return dict(zip(COLUMNS, np.array(rows).T))开环的回调从数据文件读 ,继电器的回调是 relay.update(r - y),闭环的回调是 pid.update(r, y)。数据文件由 Python 生成(numpy 种子 6),包含阶跃时刻、负载、继电器测试里 rad/s 的测量噪声。闭环评估用的配置把三套规则的增益统一接进第 5 篇的 Pid:
def eval_config(spec: Spec, g: Gains) -> PidConfig: return PidConfig( g.kp, g.ki, g.kd, spec.ts, tf=g.kd / g.kp / 10.0, u_min=-spec.u_lim, u_max=spec.u_lim, windup=Windup.CLAMP, )IAE_sp 用第 2 篇的 step_metrics 在负载阶跃之前截断,IAE_ld 是负载阶跃之后 的矩形和:
def evaluate(spec: Spec, o: dict) -> tuple[float, float, float]: # ... y, ts = o["y"], spec.ts sm = step_metrics(y[: spec.eval_load], ts, spec.eval_sp, spec.eval_r) iae_ld = 0.0 for yi in y[spec.eval_load :]: iae_ld += abs(spec.eval_r - yi) * ts return sm.iae, iae_ld, sm.overshoot 由 sensitivity 用 freq 模块在真实的对象多项式上算,控制器是 在第 5 篇定义下的有理形式(loop_polys),延迟用 theta_loop = (delay + 0.5)·ts:传输延迟加半拍 ZOH。
另外三种语言
三个版本都是 tuning.py 的逐行翻译,算术顺序一样,所以第 6 篇没有新的数值问题。区别在这几处:
- 输出参数。 C 没有多返回值,
pl_fopdt_fit、pl_relay_analyse返回 0 或-EINVAL,结果写进调用方的结构体(struct pl_fopdt、struct pl_relay_result);三个规则函数返回void,写进struct pl_gains。C++ 用std::optional<Fopdt<T>>和std::optional<RelayResult<T>>返回,规则函数直接返回Gains<T>;Rust 是Option<Fopdt>和Option<RelayResult>。Python 抛ValueError,三种原生语言都没有异常,失败条件一样:没有阶跃、、、不到四个上升沿、。 - 输入是切片。 C 传
const pl_real *加长度long n;C++ 用std::span<const T>;Rust 是&[Real]。三个函数都不拷贝数据,不分配内存。 - “滑动四个上升沿”。 Python 把所有上升沿存进列表再取最后几个;C、C++、Rust 的
relay_analyse只保留最后四个(idx[4]、tm[4],每来一个就移位)。这是为了不需要容量未知的数组,结果相同。 simc_pi的默认tauc。 C 用负数表示“用 ”(pl_simc_pi(k, tau, theta, -1.0, &g));C++ 是std::optional<T> tauc = std::nullopt;Rust 的tauc: Option<Real>,传None。- 的写法。 C 的
-std=c11 -Wpedantic没有M_PI,我写了PL_PI常量;Rust 用core::f64::consts::PI转Real。 - 类型。
pl_real、T、Real都是标量开关,第 10 篇会用到 float32;这里没有写死double。
C
pl_relay_analyse 是这一篇最长的函数,上升沿用一个移位的 4 元窗口收集:
int pl_relay_analyse(const pl_real *r, const pl_real *y, const pl_real *u, long n, pl_real ts, pl_real eps, pl_real d, struct pl_relay_result *out){ pl_real tm[4] = { 0 }, lo, hi, a; long idx[4] = { 0 }, k; int cnt = 0, j;
for (k = 1; k < n; k++) { pl_real e0, e1;
if (!(u[k] > 0.0 && u[k - 1] <= 0.0)) continue; e0 = r[k - 1] - y[k - 1]; e1 = r[k] - y[k]; for (j = 0; j < 3; j++) { idx[j] = idx[j + 1]; tm[j] = tm[j + 1]; } idx[3] = k; tm[3] = (k - 1 + (eps - e0) / (e1 - e0)) * ts; cnt++; } if (cnt < 4) return -EINVAL; /* ... peak-to-peak of y over [idx[2], idx[3]) gives a ... */ out->pu = (tm[3] - tm[0]) / 3.0; out->a = a; out->ku = 4.0 * d / (PL_PI * a); return 0;}SIMC 只有几行。注意 tauc < 0.0 是“默认”的标记,而 是合法值(对应 ):
void pl_simc_pi(pl_real k, pl_real tau, pl_real theta, pl_real tauc, struct pl_gains *g){ pl_real ti, lim;
if (tauc < 0.0) tauc = theta; lim = 4.0 * (tauc + theta); g->kp = tau / (k * (tauc + theta)); ti = tau < lim ? tau : lim; g->ki = g->kp / ti; g->kd = 0.0;}驱动是 c/apps/ch06.c。simulate 里三种模式用一个 enum mode 和一个 void *ctl 分派,不用函数指针回调;闭环用的 struct pl_pid 和继电器 struct pl_relay 都放在调用方的栈上。
C++
继电器是一个有状态的小类,Update(e) 一拍一次;SimcPi 的 tauc 用 std::optional。事后分析的函数是自由函数模板,输入是 std::span:
template <class T = double>class Relay { public: Relay(T d, T eps) : d_(d), eps_(eps) {}
// One sample of the relay on the error e = r - y. T Update(T e) { if (state_ > 0 && e < -eps_) { state_ = -1; } else if (state_ < 0 && e > eps_) { state_ = 1; } return T(state_) * d_; }
private: T d_, eps_; int state_ = 1;};// Skogestad's SIMC PI: Kp = tau / (k (tauc + theta)),// Ti = min(tau, 4 (tauc + theta)). tauc defaults to theta.template <class T>Gains<T> SimcPi(T k, T tau, T theta, std::optional<T> tauc = std::nullopt) { const T tc = tauc.value_or(theta); const T lim = T(4) * (tc + theta); const T kp = tau / (k * (tc + theta)); const T ti = tau < lim ? tau : lim; return {kp, kp / ti, T(0)};}驱动是 cpp/apps/ch06.cc。
Rust
Rust 版的上升沿窗口用 copy_within(1.., 0) 移位;峰峰值用 fold 而不是 iter().min(),因为 f64 没有全序,不能直接 min:
pub fn relay_analyse( r: &[Real], y: &[Real], u: &[Real], ts: Real, eps: Real, d: Real,) -> Option<RelayResult> { let mut idx = [0usize; 4]; let mut tm = [0.0; 4]; let mut count = 0; for k in 1..u.len() { if !(u[k] > 0.0 && u[k - 1] <= 0.0) { continue; } let e0 = r[k - 1] - y[k - 1]; let e1 = r[k] - y[k]; idx.copy_within(1.., 0); tm.copy_within(1.., 0); idx[3] = k; tm[3] = ((k - 1) as Real + (eps - e0) / (e1 - e0)) * ts; count += 1; } if count < 4 { return None; } let seg = &y[idx[2]..idx[3]]; let lo = seg.iter().fold(seg[0], |m, &v| if v < m { v } else { m }); let hi = seg.iter().fold(seg[0], |m, &v| if v > m { v } else { m }); let a = (hi - lo) / 2.0; // ...}simc_pi 的 tauc 是 Option<Real>,None 表示取 ,其余和 C++ 版一一对应。驱动是 rust/src/bin/ch06.rs。
编译参数和前几篇一样:C 是 gcc -std=c11 -O2 -Wall -Wextra -Wpedantic -Werror(15.3.0),C++ 是 g++ -std=c++20 加同样的警告,Rust 是 rustc 1.95.0、edition 2024,cargo clippy --release -- -D warnings(0.1.95)。风格检查:C 用内核的 checkpatch.pl(--no-tree,忽略 SPDX 和 typedef 两项),0 errors、0 warnings;C++ 用 clang-format 21.1.8 的 Google 风格;Python 用 ruff format --check 和 ruff check,行宽 79;Rust 用 cargo fmt --check。四项都在提交前过了。
结果
make ch06 一次跑完。每种语言 14 个文件,42 个对比文件;下面的输出把中间的 ok 行裁掉了,只留头尾,其余的 max diff 都是 0 或 量级(最大的一个是 tuning_flywheel_rs.csv 的 ):
$ make -s ch06ch06: C wrote 2 plants to out/ch06ch06: C++ wrote 2 plants to out/ch06ch06: Rust wrote 2 plants to out/ch06ok eval_benchmark4_simc_c.csv: max diff 0.000e+00 <= 1.0e-09ok eval_benchmark4_simc_cpp.csv: max diff 0.000e+00 <= 1.0e-09ok eval_benchmark4_simc_rs.csv: max diff 0.000e+00 <= 1.0e-09... (中间 33 行 ok 省略)ok tuning_benchmark4_c.csv: max diff 0.000e+00 <= 1.0e-09ok tuning_benchmark4_cpp.csv: max diff 0.000e+00 <= 1.0e-09ok tuning_benchmark4_rs.csv: max diff 0.000e+00 <= 1.0e-09ok tuning_flywheel_c.csv: max diff 0.000e+00 <= 1.0e-09ok tuning_flywheel_cpp.csv: max diff 0.000e+00 <= 1.0e-09ok tuning_flywheel_rs.csv: max diff 2.220e-16 <= 1.0e-09
--- flywheel ---step fit k = 78.11 (Kt/b = 78.11) tau = 2.0008 s (J/b = 2.0000) theta = 1.39 ms (delay + current lag = 3.00 ms)relay Ku = 4.805 Pu = 31.63 ms a = 2.650true Ku = 12.872 Pu = 0.01374 s (freq module)harmonic balance: a = |G(jw)| 4d/pi = 2.4552 (measured 2.6496); arg G(jw) = -129.5 deg; -180 + asin(eps/a) = -131.0 rule Kp Ti Td IAE_sp IAE_ld over % Ms PM zn_step 22.104 0.00278 0.00070 62.7667 0.5093 0.46 1.304 -48.7 zn_ultimate 2.883 0.01581 0.00395 62.7824 0.0376 0.78 1.633 61.7 simc 9.210 0.01113 0.00000 62.7615 0.0307 0.30 12.405 6.2
--- benchmark4 ---step fit k = 1.0000 tau = 2.497 s theta = 1.855 srelay Ku = 3.913 Pu = 6.340 s a = 0.3254true Ku = 3.980 Pu = 6.29887 s (freq module)harmonic balance: a = |G(jw)| 4d/pi = 0.3241 (measured 0.3254); arg G(jw) = -179.3 deg; -180 + asin(eps/a) = -180.0 rule Kp Ti Td IAE_sp IAE_ld over % Ms PM zn_step 1.616 3.70909 0.92727 3.0187 2.2958 11.26 1.626 66.7 zn_ultimate 2.348 3.17000 0.79250 3.3231 1.3772 36.16 2.166 41.3 simc 0.673 2.49677 0.00000 4.1331 3.7464 6.80 1.628 62.0IAE_sp spread over the three rules: 0.033 % (a 20 A clamp sets the ramp, not the gains)zn_step: PM = -48.7 deg, |u| at the 20 A clamp in 41 % of the samples after the load stepSIMC on the same fit, tuned with different thetas: theta = 1.39 ms ( fitted): Kp = 9.210 Ms = 12.40 theta = 3.00 ms (delay + lag): Kp = 4.269 Ms = 1.85 theta = 3.50 ms ( + half ZOH): Kp = 3.659 Ms = 1.66lowest IAE_sp: zn_step; lowest IAE_ld: zn_ultimate; lowest overshoot: simc; lowest Ms: zn_stepSIMC detuned to tauc = 2 theta: Kp = 0.449, Ms = 1.373 (tauc = theta: 1.628)figure: figures/ch06/relay-oscillation.svgfigure: figures/ch06/fopdt-fit.svgfigure: figures/ch06/tuning-compare-flywheel.svgfigure: figures/ch06/tuning-compare-benchmark4.svgfigure: figures/ch06/ms-vs-iae.svg
ch06 OK阶跃拟合
先看拟合。摩擦轮:
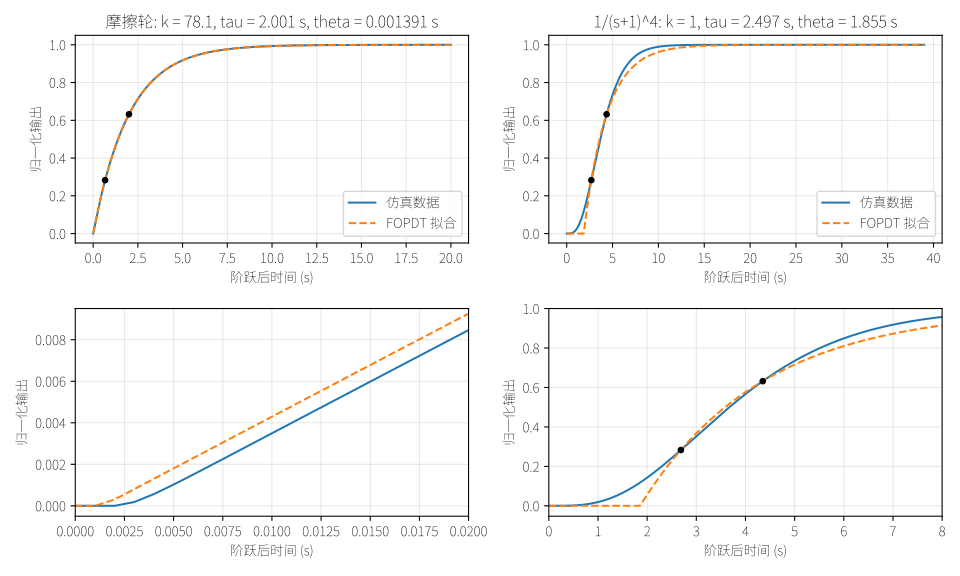
摩擦轮的 ,和 一致; s,和 一致(report 里断言相对误差小于 )。延迟对不上:拟合给出 ms,而 2 拍传输延迟加 1 ms 电流环是 3.00 ms。 图下半是放大 20 ms 的视图:真实响应(蓝)在 2 ms 之前几乎不动,然后是缓慢的抛物线起步(电流环的二阶效应),而拟合(橙)在 1.39 ms 就开始直线上升。差的 1.61 ms 和前面估计的取整误差 1.7 ms 是同一个量级,所以我猜这就是主要原因,没有进一步分解(我没有试过用更精确的 0.2833 和 0.6321 重新算,看是不是整整消掉)。
四阶对象:, s, s(图右)。真实响应是一条 S 形曲线,FOPDT 在 和 两个点之间贴得很好,但头部(拟合有一个硬的延迟,真实曲线是缓慢起步)和尾部(拟合比真实响应慢)都不贴。这是模型本身的限制,不是拟合方法的毛病:四个重合极点用一个极点加延迟代替,必然损失。
继电器
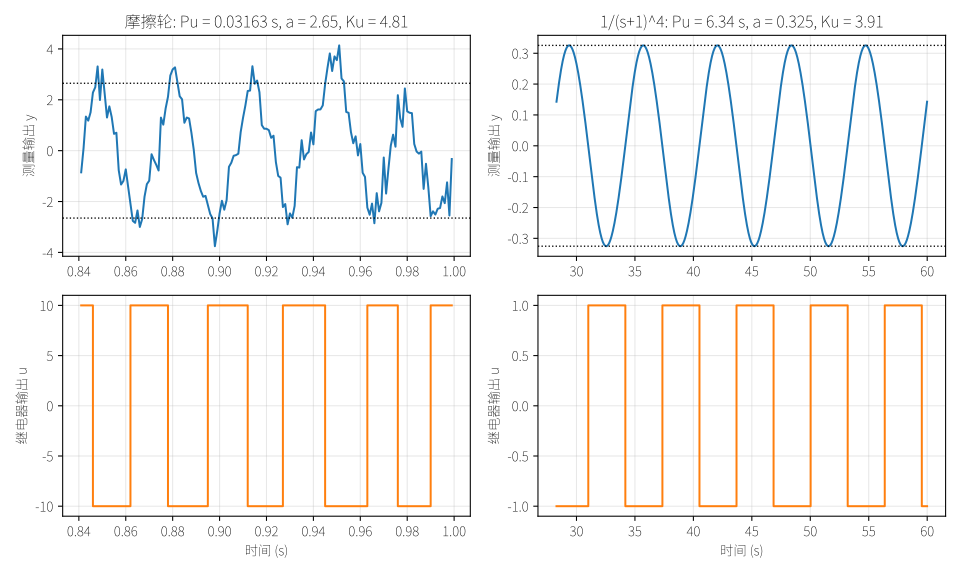
四阶对象(右):继电器 ,没有滞环,没有噪声。输出是干净的正弦,, s,所以 。freq 模块在真实对象上算出的真值是 、 s。继电器读的 比真值低 1.7%, 高 0.65%。 谐波平衡自己也能检验:在测得的 处算 ,实测 ,差 0.4%;,几乎正好在 上。这点偏差来自描述函数只取基波,三次谐波还是有一点点。(report 里这三条都是断言: 差小于 5%, 小于 2%, 小于 2%。)
摩擦轮(左): A, rad/s,测量噪声 rad/s。测到 , ms,所以 。真值是 , ms:继电器读出的 小了 2.7 倍,周期长了 2.3 倍。 这不是噪声的错,是前面推出的滞环效应:在测得的 处,(实测 2.6496,噪声把峰峰值撑大了一点,这是猜测),,而公式 。差 1.5°。继电器测的是 那个点,不是 那个点。 不小,这个效应就大。滞环是为了不被噪声反复触发才加的,2 rad/s 的滞环是 0.5 rad/s 噪声的 4 倍,是我选的,没有找最小可行值。
摩擦轮上的三套规则
tuning_flywheel_*.csv 的结果, 和 PM 是在真实对象上算的:
rule Kp Ti Td IAE_sp IAE_ld over % Ms PM zn_step 22.104 0.00278 0.00070 62.7667 0.5093 0.46 1.304 -48.7 zn_ultimate 2.883 0.01581 0.00395 62.7824 0.0376 0.78 1.633 61.7 simc 9.210 0.01113 0.00000 62.7615 0.0307 0.30 12.405 6.2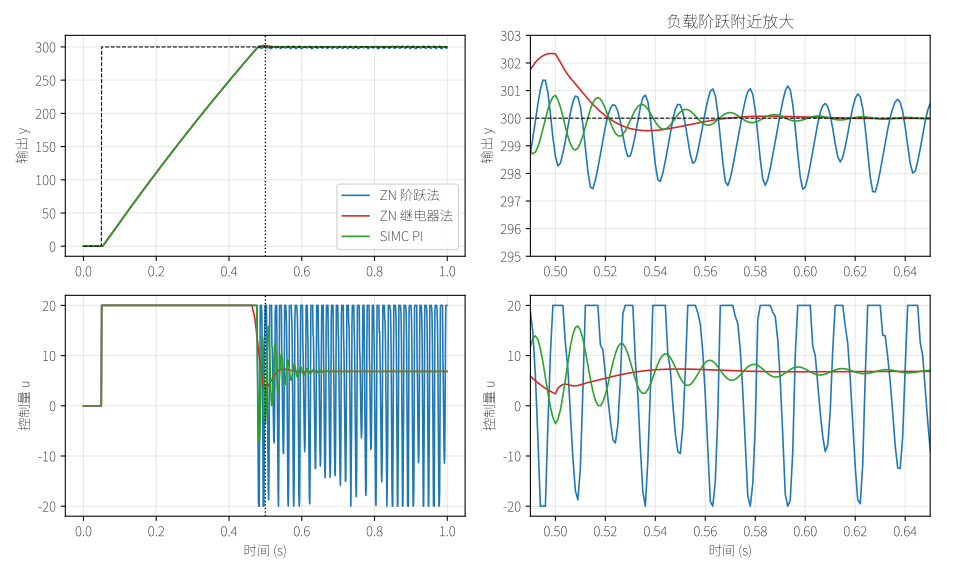
三件事。第一,IAE_sp 完全没有区别:62.7667、62.7824、62.7615,三者相差 0.033%。 设定值是 300 rad/s 的阶跃,电流上限 20 A,电机以固定的加速度爬坡,整条上升过程都被限幅占着,增益选什么对 IAE 没有影响(图左上三条线重合)。这个指标在这个对象上没有判别力,我把它留在表里是为了让你看到它。
第二,阶跃法给的增益让线性回路不稳定。 PM = 。因为拟合的 ms 比真实的等效延迟 3.00 ms 小一半多, 里的 小了, 大了:22.104。图里蓝线在负载阶跃之后一直在 A 之间切换(限幅限住了发散,变成极限环),report 数出来负载阶跃之后 41% 的采样点上 贴着 20 A。它的 看起来很漂亮,但是前面说过,回路不稳定的时候 不是距离,所以在 对 IAE 的图里这个点我画成空心。IAE_ld 是 0.5093,比另两个大 13 到 17 倍。
第三,SIMC 的负载 IAE 最低(0.0307),但 ,PM 只有 。 同一个 的错误在这里表现成另一种形式:SIMC 的 同样对 很敏感。我用同一个拟合的 、,只换 再算一遍:
SIMC on the same fit, tuned with different thetas: theta = 1.39 ms ( fitted): Kp = 9.210 Ms = 12.40 theta = 3.00 ms (delay + lag): Kp = 4.269 Ms = 1.85 theta = 3.50 ms ( + half ZOH): Kp = 3.659 Ms = 1.66用真实的 3.00 ms, 从 12.40 降到 1.85;再加上第 4 篇的半拍 ZOH(0.5 ms,正是 Skogestad 的 规则),,落进这个规则设计的 1.6 到 1.7 的范围。SIMC 没有错,是我喂给它的 错了。(report 断言了 (1.39 ms) > 5 且 (3.5 ms) < 2.5。)
真正“胜出”的是继电器的临界法:,PM ,,IAE_ld = 0.0376,比 SIMC 差 22%。 但这有点讽刺:前面看到继电器读的 小了 2.7 倍,所以 其实只是真值的 0.22 倍(2.883 / 12.872),一个意外地保守的增益,保守恰好救了它。我没有一个办法声称这是“继电器法更好”,它是“滞环给的误差碰巧落在安全的一边”。如果去掉 让它读到 的点, 会是 ,而我没有跑那个实验。
四阶对象上的三套规则
rule Kp Ti Td IAE_sp IAE_ld over % Ms PM zn_step 1.616 3.70909 0.92727 3.0187 2.2958 11.26 1.626 66.7 zn_ultimate 2.348 3.17000 0.79250 3.3231 1.3772 36.16 2.166 41.3 simc 0.673 2.49677 0.00000 4.1331 3.7464 6.80 1.628 62.0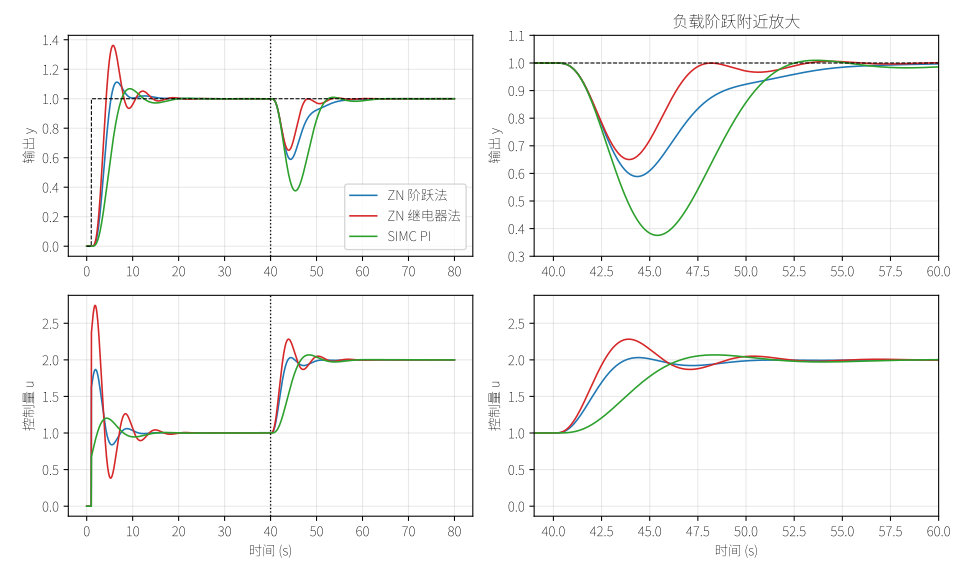
这个对象没有限幅,也没有拟合出错,所以三套规则分得开:
- 设定值: 阶跃法最快(
IAE_sp3.0187),继电器法次之(3.3231),SIMC 最慢(4.1331)。超调反过来,SIMC 最小(6.80%),阶跃法 11.26%,继电器法 36.16%,是 SIMC 的 5.3 倍。 - 负载: 继电器法最好(
IAE_ld1.3772),阶跃法 2.2958,SIMC 3.7464,是继电器法的 2.7 倍。图里 SIMC 在负载阶跃之后下沉到 0.38,最深。 - 鲁棒性: 阶跃法和 SIMC 几乎一样( 1.626 和 1.628),继电器法最差(2.166)。
report 里这四句话是断言:IAE_sp 最低的是阶跃法,IAE_ld 最低的是继电器法,超调最小的是 SIMC, 最大的是继电器法。
我没想到的一点:阶跃法在四阶对象上赢了 SIMC。 同样的 (1.626 对 1.628),阶跃法的两个 IAE 都更低(3.02 对 4.13,2.30 对 3.75),只是超调大了 4.5 个百分点。要说公平,阶跃法是 PID,SIMC 这里只是 PI:Td 是 0.927 对 0。我没有跑 SIMC-PID(Skogestad 的论文里对二阶模型有 PID 版本,我这一篇只实现了 PI)。所以这个“赢”只能说是“PID 对 PI”,不能说是规则的胜负。
SIMC 的可调之处:同一个拟合,(只改了一个参数), 从 0.673 降到 0.449, 从 1.628 降到 1.373(report 断言它变小)。我没有评估它的 IAE,所以不知道这个更稳的版本贵多少。
鲁棒性和性能
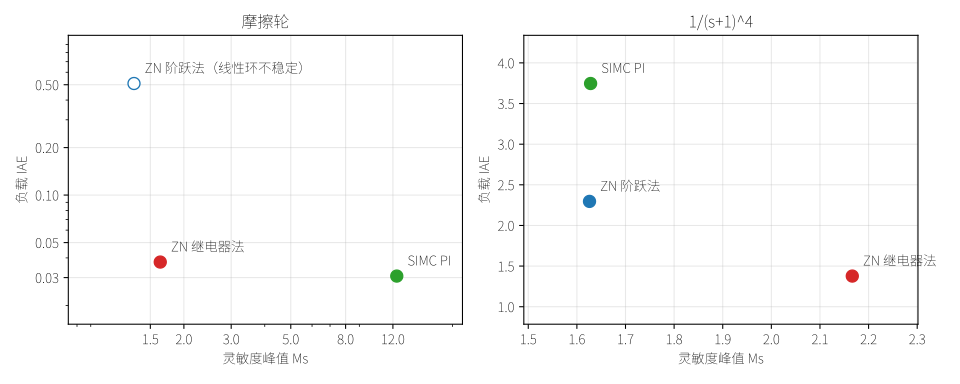
把每套规则画成一个点,横轴是 ,纵轴是负载 IAE,越靠左下越好。四阶对象(右图)呈现的是教科书里的权衡:继电器法在最下面(IAE 1.38),也在最右边( = 2.17);另外两个点在 的同一列,阶跃法(2.30)在 SIMC(3.75)下面。所以继电器法拿性能换了鲁棒性,而阶跃法在同样的 上压住了 SIMC。
摩擦轮(左图,纵轴是对数)呈现的则是另一回事:权衡被拟合误差盖住了。左下角的点(继电器法)是被滞环意外保护起来的,右下角的点(SIMC)是被错误的 害的,空心点(阶跃法)是不稳定的。这张图的信息不是哪条规则好,而是:在这个对象上,规则之间的差别小于模型误差带来的差别。
我没有测的东西
有几件事我没有去证实,列在这里,免得读者以为它们是结论:
- 摩擦轮上 FOPDT 拟合的延迟偏小,我估计的取整误差(1.7 ms)和实际差的 1.61 ms 同量级,但没有换精确常数重新拟合来证实。
- 继电器在摩擦轮上实测的幅值 比描述函数预测的大 8%,我猜是噪声,没有分解;也没有去掉滞环重做一遍,看 能不能回到 12.87 附近。
- 阶跃法对摩擦轮的 在回路不稳定时没有意义,它和不稳定同时出现,只是因为我用的函数不检查稳定性。
- 四阶对象上我把 PID(两套 Ziegler–Nichols)和 PI(SIMC)放在一起比,所以那里的结论是“PID 对 PI”,不是规则之间的胜负。
- 我没有测 Ziegler–Nichols 说的“四分之一衰减比”,它是我凭记忆写的目标,不是这一篇的实验结果。
- 继电器的滞环和噪声是我选的,没有扫描。四阶对象上没有滞环,所以那里的 1.7% 误差是“理想”情形。
检查点
在仓库根目录、nix develop 里运行:
make -s ch06输出就是上面“结果”开头那一段(中间的 ok 行我裁掉了):每种语言 14 个文件,共 42 个对比文件全部 ok,容差 ,最大差异 ;末尾是 ch06 OK,表示 report 里的所有断言都过了。out/ch06/ 下有 56 个 CSV,figures/ch06/ 下有 5 张图(这两个目录和 data/ 一样不进 git,是 make 生成的)。
这一篇新增的文件:
| 文件 | 命令 | 结果 |
|---|---|---|
python/pidlab/tuning.py | make -s ch06 | fopdt_fit、Relay、relay_analyse、zn_step、zn_ultimate、simc_pi;Python 参考,其余三种语言与它的最大差异 |
python/pidlab/plants.py | make -s ch06 | 新增 Flywheel、Benchmark4 |
c/include/pl/tuning.h、c/src/tuning.c | make -s ch06 | C 版整定模块,eval_*_c.csv 等 ok |
c/include/pl/plants.h、c/src/plants.c | make -s ch06 | 新增 pl_flywheel、pl_benchmark4 |
cpp/include/pidlab/tuning.h、cpp/include/pidlab/plants.h | make -s ch06 | C++ 版整定模块和 Flywheel<T>、Benchmark4<T>,*_cpp.csv 全部 ok |
rust/src/tuning.rs、rust/src/plants.rs | make -s ch06 | Rust 版整定模块和 Flywheel、Benchmark4,*_rs.csv 全部 ok |
python/ch06_tuning.py | python3 python/ch06_tuning.py ref,python3 python/ch06_tuning.py report | ref 写数据和 Python 参考输出;report 比对、断言、打印两张表、画 5 张图,结尾 ch06 OK |
c/apps/ch06.c、cpp/apps/ch06.cc、rust/src/bin/ch06.rs | make -s ch06 | 各写 14 个 CSV,分别打印 ch06: C wrote 2 plants to out/ch06、C++、Rust |
这一篇依赖、但没有改动的文件:
| 文件 | 命令 | 结果 |
|---|---|---|
python/pidlab/pid.py、c/src/pid.c、cpp/include/pidlab/pid.h、rust/src/pid.rs | make -s ch06 | 第 5 篇的 Pid,评估三套规则时用 CLAMP 和 |
python/pidlab/freq.py、python/pidlab/metrics.py | make -s ch06 | 第 3 篇的 和第 2 篇的 step_metrics,report 用来算真值 、、IAE |
下一篇
这一篇我把整定拆成了函数:两点法在摩擦轮上拟合出 、 s,但把 3.00 ms 的延迟拟成了 1.39 ms;继电器在四阶对象上读出 ,比真值 3.980 低 1.7%,在带 2 rad/s 滞环的摩擦轮上读出 4.805,真值是 12.872;三套规则里,阶跃法在摩擦轮上线性不稳定(PM ),SIMC 在同一个拟合上 ,换成 3.5 ms 的 之后降到 1.66;四阶对象上 SIMC 的超调 6.80%,继电器法 36.16%,但负载 IAE 是 3.7464 对 1.3772。四种语言 42 个对比文件最大差异是 。
第 7 篇:串级 PID:云台的角度环和速度环会把这些单回路 PID 接成两层:云台的速度环(内)和角度环(外),内环抗底盘转动带来的扰动。整定用的还是这一篇的 SIMC 和第 2 篇的极点配置,评估用第 5 篇的 Pid,外环怎么知道内环饱和了,要靠 hold_integral。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!