
 Better Mistakes



音乐
暂未播放
频域:Bode、Nyquist 与稳定裕度
上一篇结尾我留了一个难看的事实:Routh 判据给出的临界增益,在 1 kHz 采样下少了 20%,而我只能靠“把对象重新离散化一遍再求特征值”去量它。这一篇我换一个问法:这个回路还能再吃多少延迟? 频域给的答案是一个数,。第 2 篇的 PI 速度环(、)加一个采样周期的纯延迟,我算出 ms,也就是 72.875 拍。然后我把额外延迟设成这个数的 0.9 倍(66 拍)和 1.1 倍(80 拍)去仿真:0.9 倍的偏差包络以 /s 衰减,1.1 倍以 /s 增长,直到电流限幅把它夹成一个极限环。把延迟逐拍加上去的精确 1 kHz 离散模型说,最后一个稳定的额外延迟是 72 拍,73 拍就不稳了。
这一篇结束时你会有:make ch03 通过,out/ch03/ 下 16 个 CSV(bode、margins、delay_0.9、delay_1.1 四组,每组 Python、C、C++、Rust 各一份),figures/ch03/ 下 5 张图;以及频率响应、Bode 渐近线、Nyquist 判据、三种裕度、灵敏度函数和 Bode 灵敏度积分的完整推导。
新增模块:Python 是 pidlab/freq.py;C 是 pl/freq.h 和 freq.c,pl/real.h 多了 PL_LOG10;C++ 是 pidlab/freq.h;Rust 是 freq.rs,real.rs 多了 log10。
前置:第 2 篇。需要的数学:复数的模和辐角、欧拉公式、第 2 篇的传递函数和极点配置公式。
数学
正弦稳态:频率响应是什么
设 是稳定的线性系统,脉冲响应为 ,输入 。卷积给出
积分上限 时(系统稳定, 衰减,暂态消失),右边的积分就是拉普拉斯变换 在 处的值:
是实函数,所以对 取虚部,得到 。频率响应就是传递函数沿虚轴取值: 幅值是放大倍数,辐角是相位滞后。我之前把 当成复数平面上的任意点去找极点,现在只看一条线。
纯延迟 的传递函数是 ,在虚轴上 ,相位是 。幅值不变,相位随频率线性往下掉。画在对数频率轴上,这条直线会越弯越陡,这是下面 Bode 图里蓝线和橙线分开的原因。
频率响应的乘法有一个很好用的性质:开环 是一串因子的积,所以
在对数幅值和线性相位下,因子是加起来的。这就是 Bode 图的全部发明。
本篇的回路
对象是带电流环的 M3508 速度模型(第 2 篇的 MotorSpeedLag):,。从电流指令到轮速的传递函数是
控制器是第 2 篇极点配置出来的 PI,,其中 ,,取 、 rad/s,得到 、。(第 2 篇里比例项对设定值的权重只影响从 到 的通路,不进入开环 ,所以这里不出现。)
延迟有两部分。一部分是我故意加的:指令先进 DelayLine,延迟 1 个采样周期,也就是 1 ms。另一部分是零阶保持器(ZOH)自己带的:控制器每 才更新一次指令,在 内保持不变,它的传递函数是
低频下相当于半个采样周期的延迟。所以我取总延迟 ms:
我一开始只放了 1 个采样周期的传输延迟,做实验时才发现这半拍有区别(见下面“结果”一节),所以这里直接按 1.5 拍写。
Bode 渐近线:不用算也能读
的因子有一个积分器 、PI 的零点 、两个极点 和 。幅值渐近线是折线:每过一个极点,斜率下降 20 dB/dec,每过一个零点,斜率上升 20 dB/dec。转折频率是(手算):
- rad/s,机械极点。
- rad/s,PI 零点。
- rad/s,电流环极点。
所以斜率从低频的 (积分器)到 0.333 之后变成 ,到 7.32 又回到 ,到 1000 以后是 。PI 的零点把斜率拉回了 ,而增益穿越频率会落在 7.32 和 1000 之间的 dB/dec 段上:这是一个经验规则,穿越点的斜率是 时,相位通常离 还远,相位裕度是健康的。下面的数据会验证这一点: rad/s,确实在这一段里。
Nyquist 判据:为什么 这个点特别
闭环特征方程是 。Nyquist 在 1932 年发表《Regeneration Theory》,那是 Bell System Technical Journal 第 11 卷第 1 期 126 到 147 页,问题是电子管放大器的反馈什么时候会振荡。他的判据用现在的话说就是辐角原理:取 平面上包住整个右半平面的封闭曲线(沿虚轴从 走到 ,再沿无穷大半圆绕回来), 沿这条曲线的像绕原点顺时针转的圈数 等于曲线内部的零点数 减去极点数 。零点就是闭环极点,极点就是开环极点,所以
绕原点,等价于 绕点 。开环稳定()时,闭环稳定当且仅当 的完整曲线( 从 到 )不绕 。负频率那一半是正频率的复共轭,所以只画 ,再镜像。
我的 在原点有一个积分极点,它在虚轴上,不属于开右半平面,处理办法是把曲线在原点附近往右半平面绕出去一个小半圆,把它排除在外。代价是 的图像在 时会在无穷远处画一段大圆弧,这是 Nyquist 图里看起来“多出来一块”的原因,我这里只用它的直观版本,不推导严格的绕圈数。
增益裕度、相位裕度、延迟裕度
“不绕 ”是一个二元判断,现实里要问的是离 有多远。三个裕度各取一种方向:
- 增益裕度(GM)。 的相位到 的那个频率 处, 穿过负实轴,位置是 。增益还能放大 倍才碰到 。
- 相位裕度(PM)。 的频率 处, 穿过单位圆,相位还剩 才转到 。
- 延迟裕度。额外加一个延迟 ,相当于乘 ,幅值不变,所以 不动,只是相位多滞后 。当 等于 PM(换成弧度)时,曲线正好压到 上:
这个公式只在 恰好穿越 1 一次时精确;如果有多个穿越点,要取每个穿越点算出来的最小值。我的 在这一点上没有问题(图里能看到)。
我选这个回路的原因也在这里: ms 比采样周期 1 ms 大两个数量级,所以“把延迟加到 的 0.9 倍和 1.1 倍”可以用整数拍表示,舍入误差不会盖住那 10%。
灵敏度函数、噪声和
定义灵敏度 和补灵敏度 ,显然 。 是从扰动到输出的传递函数, 是从设定值到输出的传递函数,也是从测量噪声到输出的传递函数(符号相反):低频要 小(抗扰动、无稳态误差),高频要 小(不放大噪声),而两者之和是 1,所以两个目标没法同时在同一个频率上做到。
是 最小值的倒数,几何上是 Nyquist 曲线到 的最近距离的倒数。这给了一个比 GM、PM 更严格的稳健性指标,因为它考虑了整条曲线,不只是两个穿越点。它和另外两个裕度有关,推导很短: 意味着曲线始终在以 为圆心、半径 的圆外。穿越单位圆的那一点离 的距离是弦长 ,穿越负实轴的那一点离 的距离是 ,它们都不能小于 :
噪声方面,PID 里的微分项是问题。 的幅值在高频是 ,随频率无限增长。 在 附近提供的相位超前是 (对 PD 而言),小于 90°,这是好处;代价是 在测量噪声的频段里被放大。工程上的办法是给微分加一个一阶滤波,,高频增益被压到 。滤波器的转折频率 如果比 高得多,那在穿越频率附近几乎没有额外的相位代价,第 5 篇会把它放进 Pid 里。
Bode 灵敏度积分:水床
在低频压低一块,就一定会在别的频率抬高一块,据我所知这个结论属于 Bode,来自他 1945 年的《Network Analysis and Feedback Amplifier Design》(书在 Internet Archive,NASA 的一篇论文说这个积分定理首次出现在 1945 年)。形式是:设 在开右半平面没有极点,并且比较分母和分子的阶次,分母至少高两阶(相对阶数不小于 2),那么
这是维基百科 Bode’s sensitivity integral 词条里的表述,它还给出了有右半平面极点时的一般式 。常被叫做“水床效应”:压下去一块,另一块就鼓起来。我的 有一个原点处的极点,不在开右半平面里;相对阶数是 3 减 1 等于 2;延迟项 在高频不影响收敛。条件看起来都满足,但我没有去查带积分器和延迟的情形是否被原始证明覆盖,所以下面我直接做数值检验,而不是把它当作已知。
把公式写成代码
数学写完了,剩下的是两件容易写错的事:相位怎么展开,穿越点怎么找。我先写 Python,再逐行翻成 C、C++、Rust。
频率响应和相位展开
就是分子除以分母再乘延迟。多项式求值用第 2 篇的 poly_eval(Horner,复数点),所以 loop_eval 只有三行:
def loop_eval( num: Sequence[float], den: Sequence[float], theta: float, w: float) -> complex: """L(jw) for L(s) = num(s) / den(s) * exp(-s theta).""" s = complex(0.0, w) lag = complex(math.cos(w * theta), -math.sin(w * theta)) return poly_eval(num, s) / poly_eval(den, s) * lag延迟项我写成 ,不调 cmath.exp,这样四种语言用的是同样的几个初等函数。
atan2 返回的辐角在 里,曲线转过 的时候会从 跳到 。我的办法是逐点展开:把相邻两个采样点的辐角差折回 ,再累加。
def wrap(d: float) -> float: """Fold a phase difference of (-2 pi, 2 pi) into (-pi, pi].""" if d > math.pi: return d - 2.0 * math.pi if d <= -math.pi: return d + 2.0 * math.pi return d
def bode( num: Sequence[float], den: Sequence[float], theta: float, ws: Sequence[float],) -> tuple[list[float], list[float]]: """Magnitude in dB and unwrapped phase in degrees on the grid ws.""" mag, phase = [], [] ph = 0.0 prev = 0.0 for i, w in enumerate(ws): lw = loop_eval(num, den, theta, w) a = math.atan2(lw.imag, lw.real) ph = a if i == 0 else ph + wrap(a - prev) prev = a mag.append(20.0 * math.log10(abs(lw))) phase.append(math.degrees(ph)) return mag, phase这要求相邻两点之间相位变化小于 。 网格是 2000 个点、 rad/s 对数均匀,相邻两点的比值是 ;延迟项在 rad/s 处的相位是 rad,相邻两点的差是 rad,离 差得远。
穿越点:网格定区间,二分求精
网格只告诉我 在哪个区间从 变成 。区间宽度大约 ,直接用端点会差 0.3%。所以我在区间里做 60 次二分,区间缩到比 float64 的分辨率还小。四种语言取同一个区间、同一个判据、同一个步数,就会收敛到同一个浮点数(最后几位除外)。margins 里增益穿越这一段是:
if math.isnan(wc) and abs(prev) >= 1.0 > abs(cur): lo, hi = ws[i - 1], ws[i] for _ in range(BISECT_STEPS): mid = 0.5 * (lo + hi) if abs(loop_eval(num, den, theta, mid)) >= 1.0: lo = mid else: hi = mid wc = 0.5 * (lo + hi) ph_c = _phase_at(num, den, theta, wc, prev, ph) pm = math.pi + ph_c dm = pm / wc_phase_at 是“从已知点 prev 把相位延拓到 wc”,相位裕度 pm 和延迟裕度 dm = pm / wc 都从它来。 是同一个结构,判据换成展开后的相位 ,然后 。
margins 是一遍扫完的。 它不存数组,边走边记上一个点的复数值和展开相位,穿越时就地二分,并持续更新 ,所以 C 版本不需要大缓冲区。网格里没有穿越点时,对应字段是 NaN,不是 0:0 会被误读成“零裕度”。
回路和延迟仿真
驱动 python/ch03_frequency_domain.py 先把第 2 篇的 PI 设计和 的分子分母拼出来:
def design() -> tuple[MotorSpeedLag, float, float]: """Plant and the PI gains (kp, ki) placed at ZETA, WN as in ch02.""" m = MotorSpeedLag() kp = (2.0 * ZETA * WN * m.j - m.b) / m.kt ki = WN * WN * m.j / m.kt return m, kp, ki
def loop_polys(m: MotorSpeedLag, kp: float, ki: float): """L(s) = Kt (kp s + ki) / (s (J s + b) (tau_c s + 1)).""" num = poly_scale([kp, ki], m.kt) den = poly_mul([1.0, 0.0], poly_mul([m.j, m.b], [m.tau_c, 1.0])) return num, denTHETA = (TRANSPORT + 0.5) * TS 就是上面的 1.5 拍。检验延迟裕度的闭环仿真是第 2 篇的循环顺序:测量、控制器、限幅、进 DelayLine、advance 十步 RK4。唯一的区别是延迟线的长度,我可以拿 extra 去逐拍调:
def run_delay(extra: int) -> dict[str, np.ndarray]: """Closed loop with `extra` more samples of command delay.""" m, kp, ki = design() data = read_csv(DATA / "ch03_step.csv") delay = DelayLine(TRANSPORT + extra) # ... for k in range(STEPS): r = data["r"][k] y = m.output(x) + data["n"][k] e = r - y u = kp * (r - y) + integ u = min(max(u, -m.u_max), m.u_max) rows.append([data["t"][k], r, y, u]) integ += ki * TS * e x = advance(m.deriv, x, [delay.push(u), data["d"][k]], TS, SUBSTEPS)精确的采样模型:用来当裁判
0.9 倍和 1.1 倍的仿真只说“这两个点一个稳一个不稳”,我还想知道真正的边界在哪一拍。ZOH 离散化之后,闭环是线性定常的离散系统,状态是 (积分器状态和还在延迟线里的 个指令),谱半径小于 1 就稳定:
def sampled_radius(extra: int) -> float: """Spectral radius of the exact 1 kHz ZOH loop with `extra` samples.""" from scipy.linalg import expm
m, kp, ki = design() d = TRANSPORT + extra a = np.array([[-m.b / m.j, m.kt / m.j], [0.0, -1.0 / m.tau_c]]) em = np.zeros((3, 3)) em[:2, :2] = a em[:2, 2] = [0.0, 1.0 / m.tau_c] e = expm(em * TS) # state: w, i, integrator, then the d commands still in flight f = np.zeros((3 + d, 3 + d)) f[:2, :2] = e[:2, :2] f[:2, 2 + d] = e[:2, 2] # oldest command reaches the plant f[2, 0] = -ki * TS f[2, 2] = 1.0 f[3, 0] = -kp f[3, 2] = 1.0 for q in range(1, d): f[3 + q, 2 + q] = 1.0 return float(np.abs(np.linalg.eigvals(f)).max())这个模型不含任何频域近似,只有 expm 和矩阵。sampled_critical_extra 在 里对额外拍数做 12 步二分,找最大的稳定拍数。
仿真里的增长率用偏差包络量:取 的局部峰值,只取到电流限幅第一次起作用为止(之后是极限环,不再是线性增长),对峰值取对数做线性回归,斜率就是增长率(1/s)。这是 ch03_frequency_domain.py 里的 envelope 和 measured_growth。
C、C++、Rust
三个版本是同一份结构:Loop(分子、分母、延迟)、bode、margins,加一个驱动。区别主要在这几处:
- 复数。 C 用第 2 篇引入的
pl_cplx,虚数单位是<complex.h>的I,PL_CABS、PL_CIMAG、PL_CREAL取模和分量;C++ 用std::complex<T>;Rust 用第 2 篇写的Complex,这一篇没有给它加方法,辐角直接用atan2(im, re)。 - 数组的存放。 C 的
struct pl_loop里是两个PL_MAX_POLY长度的固定数组加两个长度,不分配内存;C++ 的Loop<T, NN, ND>把分子分母的长度放进类型;Rust 的Loop<'a>借用调用者的切片,生命周期参数就是“这个回路不拥有系数”。 - NaN。 C 用
NAN和isnan,C++ 用quiet_NaN()和std::isnan,Rust 用Real::NAN和is_nan()。三种写法都在没有穿越点时留下 NaN,compare.py把两边同为 NaN 算作相等。 - 取整。 延迟拍数 :C 是
lround,C++ 是std::lround,Rust 是f64::round,Python 是我自己写的round_half_away(Python 内置的round是银行家舍入)。0.9 倍是 65.59,1.1 倍是 80.16,离 .5 都很远,这里谁舍入都一样,但我还是统一了。 - 数学函数。 C 和 C++ 走 glibc 的
atan2、log10、sin、cos,Rust 的no_std库走libmcrate(第 1 篇已经这么做了),real.rs里多包了一个log10。
C
struct pl_loop 和 pl_margins 是 Python 版的逐行翻译,一遍扫完,不开缓冲区。回路是固定容量的数组,没有 malloc:
/* Polynomials are highest degree first, at most PL_MAX_POLY coefficients. */struct pl_loop { pl_real num[PL_MAX_POLY]; pl_real den[PL_MAX_POLY]; int nnum; int nden; pl_real theta; /* pure delay, seconds */};pl_margins 的主循环:
int pl_margins(const struct pl_loop *l, const pl_real *w, int n, struct pl_margins *m){ /* ... */ m->wc = m->pm_deg = m->w180 = m->gm_db = m->dm = NAN; prev = pl_loop_eval(l, w[0]); ph = arg_of(prev); m->ms = 1.0 / PL_CABS(1.0 + prev); for (i = 1; i < n; i++) { cur = pl_loop_eval(l, w[i]); ph_new = phase_at(l, w[i], prev, ph); if (1.0 / PL_CABS(1.0 + cur) > m->ms) m->ms = 1.0 / PL_CABS(1.0 + cur); if (isnan(m->wc) && PL_CABS(prev) >= 1.0 && PL_CABS(cur) < 1.0) { m->wc = bisect_gain(l, w[i - 1], w[i]); pm = PL_PI + phase_at(l, m->wc, prev, ph); m->pm_deg = pm * (180.0 / PL_PI); m->dm = pm / m->wc; } /* ... the w180 crossing, same shape ... */ prev = cur; ph = ph_new; } return 0;}pl_loop_eval 里 w * I 是一个复数,pl_poly_eval 是第 2 篇的 Horner。phase_at 把“从已知点往前延拓相位”单独拎出来,pl_margins 里的穿越点和二分都靠它,wrap 则是它和 pl_bode 共用的。输出是调用者给的 struct pl_margins *,函数只返回 0 或 -EINVAL(网格少于两个点)。
驱动 c/apps/ch03.c 从 data/ch03_w.csv 读频率网格,从 data/ch03_step.csv 读设定值,自己用 pl_poly_mul 拼出分母,调 pl_bode 和 pl_margins,再 lround 出延迟拍数。
C++
模板参数是标量类型 T 和两个多项式的长度,不满足条件的调用在编译期就错了:
template <class T, std::size_t NN, std::size_t ND>struct Loop { std::array<T, NN> num; std::array<T, ND> den; T theta; // pure delay, seconds
// L(jw). std::complex<T> Eval(T w) const { const std::complex<T> s(T(0), w); const std::complex<T> lag(std::cos(w * theta), -std::sin(w * theta)); return PolyEval(num, s) / PolyEval(den, s) * lag; }};ComputeMargins 的主循环(增益穿越一段; 那段省略):
// ... for (std::size_t i = 1; i < w.size(); ++i) { const std::complex<T> cur = l.Eval(w[i]); const T ph_new = PhaseAt(l, w[i], prev, ph); m.ms = std::max(m.ms, T(1) / std::abs(T(1) + cur)); if (std::isnan(m.wc) && std::abs(prev) >= T(1) && std::abs(cur) < T(1)) { T lo = w[i - 1], hi = w[i]; for (int s = 0; s < internal::kBisectSteps; ++s) { const T mid = T(0.5) * (lo + hi); if (std::abs(l.Eval(mid)) >= T(1)) { lo = mid; } else { hi = mid; } } m.wc = T(0.5) * (lo + hi); const T pm = kPi + PhaseAt(l, m.wc, prev, ph); m.pm_deg = pm * (T(180) / kPi); m.dm = pm / m.wc; } // ... the w180 crossing, same shape ... prev = cur; ph = ph_new; }Bode 接受 std::span,调用者传 std::vector 或数组都行,长度不一致返回 false,不抛异常。ComputeMargins 对不足两个点的网格返回默认构造的结果(全 NaN、ms = 0)。驱动:cpp/apps/ch03.cc。
Rust
pub fn margins(l: &Loop, w: &[Real]) -> Option<Margins> { if w.len() < 2 { return None; } // ... let dist = |z: Complex| Complex::new(1.0 + z.re, z.im).abs(); let mut prev = l.eval(w[0]); let mut ph = arg(prev); m.ms = 1.0 / dist(prev); for i in 1..w.len() { let cur = l.eval(w[i]); let ph_new = l.phase_at(w[i], prev, ph); m.ms = m.ms.max(1.0 / dist(cur)); if m.wc.is_nan() && prev.abs() >= 1.0 && cur.abs() < 1.0 { let (mut lo, mut hi) = (w[i - 1], w[i]); for _ in 0..BISECT_STEPS { let mid = 0.5 * (lo + hi); if l.eval(mid).abs() >= 1.0 { lo = mid; } else { hi = mid; } } m.wc = 0.5 * (lo + hi); let pm = PI + l.phase_at(m.wc, prev, ph); m.pm_deg = pm * (180.0 / PI); m.dm = pm / m.wc; } // ... the w180 crossing, same shape ... prev = cur; ph = ph_new; } Some(m)}Loop<'a> 借用分子分母的切片,margins 返回 Option<Margins>,网格短于两个点时是 None。复数的除法是第 2 篇写的朴素公式 ,C 和 C++ 走编译器和标准库的实现,这是下面 bode_rs.csv 比另外两个多出 的一个可能原因,另一个是 libm 的 sin、cos、atan2 和 glibc 末位舍入不同。我没有去追究到底是哪一个, 的容差留了四个数量级的余地。驱动:rust/src/bin/ch03.rs。
编译和风格检查
编译参数和前两篇一样:C 是 gcc -std=c11 -O2 -Wall -Wextra -Wpedantic -Werror(15.3.0),C++ 是 g++ -std=c++20 加同样的警告(15.3.0),Rust 是 rustc 1.95.0、edition 2024,cargo clippy --release -- -D warnings(0.1.95)。风格检查:C 用内核的 checkpatch.pl --no-tree --ignore SPDX_LICENSE_TAG,NEW_TYPEDEFS,全部文件 0 errors、0 warnings;C++ 用 clang-format --style=Google(21.1.8);Python 用 ruff format --line-length 79 和 ruff check(0.15.14);Rust 用 cargo fmt --check。
结果
make ch03 一次跑完。12 个对比文件(4 组乘 C、C++、Rust)全部列在这里,后面是 Python 的 report 打印的表:
$ make -s ch03ch03: C wrote bode, margins and 2 delay runs to out/ch03ch03: C++ wrote bode, margins and 2 delay runs to out/ch03ch03: Rust wrote bode, margins and 2 delay runs to out/ch03ok bode_c.csv: max diff 0.000e+00 <= 1.0e-09ok bode_cpp.csv: max diff 0.000e+00 <= 1.0e-09ok bode_rs.csv: max diff 5.684e-13 <= 1.0e-09ok delay_0.9_c.csv: max diff 0.000e+00 <= 1.0e-09ok delay_0.9_cpp.csv: max diff 0.000e+00 <= 1.0e-09ok delay_0.9_rs.csv: max diff 0.000e+00 <= 1.0e-09ok delay_1.1_c.csv: max diff 0.000e+00 <= 1.0e-09ok delay_1.1_cpp.csv: max diff 0.000e+00 <= 1.0e-09ok delay_1.1_rs.csv: max diff 0.000e+00 <= 1.0e-09ok margins_c.csv: max diff 0.000e+00 <= 1.0e-09ok margins_cpp.csv: max diff 0.000e+00 <= 1.0e-09ok margins_rs.csv: max diff 3.553e-15 <= 1.0e-09vs scipy.signal.freqresp: max |mag diff| 1.42e-14 dB, max |phase diff| 7.96e-13 degPI placed at zeta 0.7, wn 10.0: kp = 1.3667, ki = 10.0000 wc PM w180 GM Ms Dm 15.1683 63.334° 653.971 35.14dB 1.0357 72.875msDm / ts = 72.875 samples, theta = 1.5 mswithout the ZOH half sample (theta = 1.0 ms): PM 63.769°, Dm / ts = 73.375
continuous prediction: Dm / ts = 72.87 extra samples; exact 1 kHz sampled loop goes unstable at 73 extra samples (last stable: 72) case extra ln(rho)/ts slope 1/s max|u| delay_0.9 66 -1.064 -1.063 10.20 delay_1.1 80 +0.851 +0.806 20.00
Bode integral of ln|S|: +0.00002 = +24.8890 (S > 1) -24.8890 (S < 1)min |1 + L| = 0.9655 = 1/Ms, Ms = 1.0357 (0.31 dB), peak |T| = 1.2728
PID with kd = 0.02, kp = 1.3667, ki = 10.0 tf |C(j wc)| lead at wc |C| at Nyq 0.000 1.4122 11.16° 62.844 0.001 1.4167 11.20° 20.363 0.005 1.4348 11.32° 5.356 0.020 1.5003 11.02° 2.366tf = 0 at 3142 rad/s: 46.0 x kpfigure: figures/ch03/bode.svgfigure: figures/ch03/nyquist.svgfigure: figures/ch03/delay-margin-check.svgfigure: figures/ch03/sensitivity.svgfigure: figures/ch03/d-term-noise-gain.svg
ch03 OK12 个文件里,除了两个 Rust 文件,其余 10 个和 Python 的最大差值都是 0.000e+00,逐位一致。bode_rs.csv 差 (单位是 dB 和度,相位的数值在几百的量级,相当于末几位),margins_rs.csv 差 。两组延迟仿真在三种语言里共 6 个文件都是 0.000e+00:仿真只有加减乘除,不碰 atan2,也不碰复数。Python 的 freq.py 另外对照了 scipy.signal.freqresp:幅值最大差 dB,相位最大差 度。
裕度
PI 回路的穿越点和裕度(表里 Dm 在 ts = 1 ms 下就是拍数):
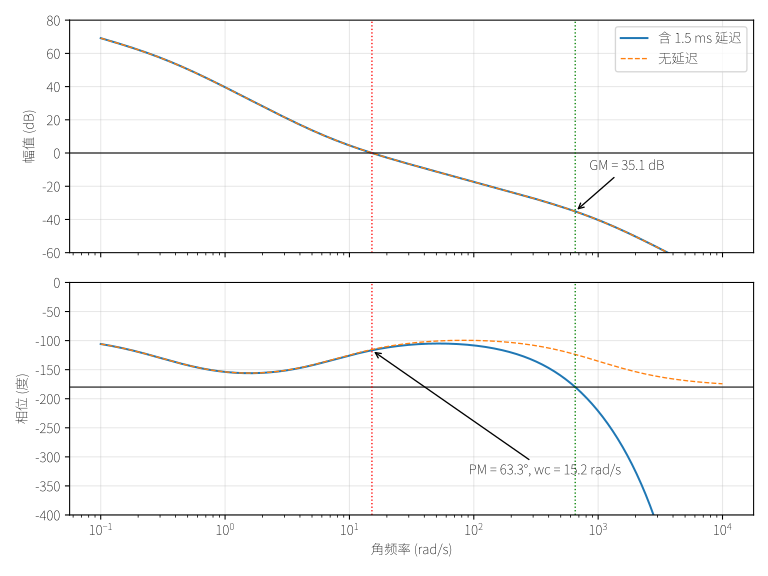
增益穿越频率 rad/s,在上面渐近线分析说的 7.32 到 1000 rad/s 的 dB/dec 段里,相位裕度 63.33°, rad/s,增益裕度 35.14 dB(线性值 57.2 倍),(0.31 dB), ms。
半拍的账。 图上橙色虚线是没有延迟的 ,蓝线是 ms。两条幅值曲线重合(延迟不改幅值),相位在 附近几乎重合,在 100 rad/s 以后才分开,在 650 rad/s 处蓝线已经穿过 ,橙线直到 rad/s 都还在 附近。
我一开始只放了 1 ms 的传输延迟(没有算 ZOH 的半拍):相位裕度 63.769°, 拍。算上半拍之后是 63.334° 和 72.875 拍,半拍在 处值 rad ,相位裕度减少 0.435°,延迟裕度少 0.5 拍,也就是 0.68%。第 2 篇里同样的半拍加电流环的滞后吃掉了 Routh 临界增益的 20%,这里只吃掉延迟裕度的 0.7%:那个拨弹盘回路在临界增益附近的穿越点在 31.6 rad/s,相位裕度趋近于零,这个速度环的穿越点在 15.2 rad/s、相位裕度 63°,同样的半拍落在富裕得多的地方。
但这 0.5 拍恰好决定了整数拍的答案。看下一节。
延迟裕度:0.9 倍衰减,1.1 倍发散
额外延迟取 拍和 拍,设定值阶跃到 5 rad/s,跑 3 秒:
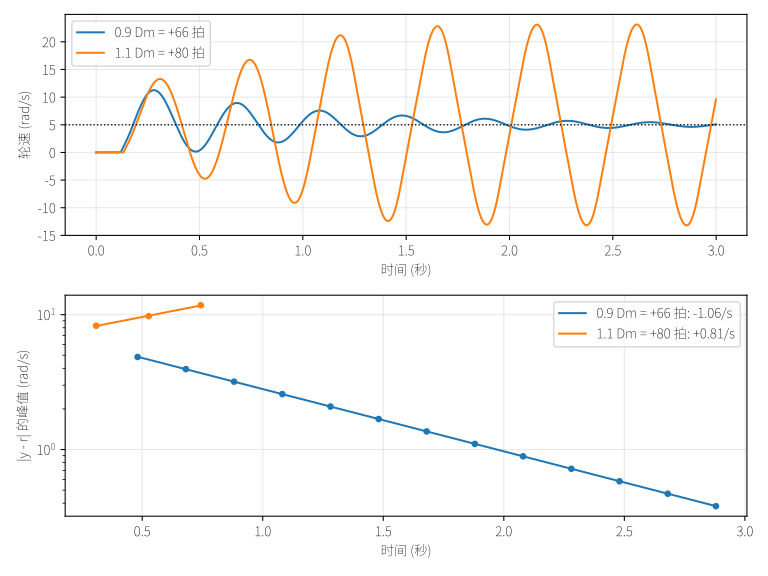
上图是轮速。蓝线(0.9 倍,+66 拍)震荡着收敛,偏差峰值从 0.48 s 处的 4.86 一路降到 2.88 s 处的 0.38,12.8 倍。橙线(1.1 倍,+80 拍)的振幅逐周期增大,大约 0.96 s 时电流指令碰到 20 A 限幅,之后变成一个幅值固定的极限环:偏差的峰值停在 18.2 附近,轮速在 到 rad/s 之间摆。下图把偏差峰值画成对数,回归直线的斜率是 /s 和 /s。
对照上面输出里的三列:
ln(rho)/ts:精确的 1 kHz 离散模型的谱半径取对数除以 ,是理论增长率: 和 。slope:仿真里量出来的: 和 。0.9 倍的两个数只差 0.001;1.1 倍低了 5%,我猜是因为线性区只有三个峰值(0.31 s、0.53 s、0.74 s),回归点太少,斜率对第一个峰里残留的快模态很敏感。max|u|:0.9 倍时 10.20 A,没有碰限幅,断言要求这一点;1.1 倍时 20.00 A,限幅起了作用。
连续模型的 这个数是准的吗? 精确模型说:额外 72 拍稳定,73 拍不稳。72.875 落在 72 和 73 之间,预测对了整数。如果我只用 1 ms 的 ,,会预测“73 拍稳定”,这是错的。半拍决定了对错。
Nyquist 图:离 很远
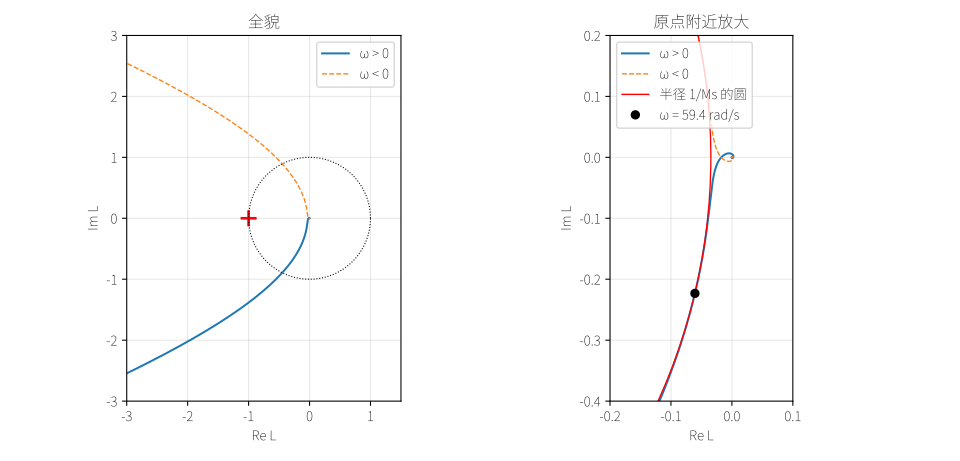
左图是整条曲线(实线 ,虚线是镜像)。 很小时 ,幅值 3000 倍的量级,所以曲线从下方无穷远处进来,向原点收拢,在 处穿过单位圆(左图里黑色点线),然后在延迟的作用下绕着原点螺旋收缩。它离 一直很远。
最近距离是 ,等于 。它出现在 rad/s,那里 (我另外用 20 万点的细网格查到的,图里用 2000 点网格标出的是 59.4 rad/s)。这不是穿越单位圆的那一点(),而是曲线收向原点的途中,在相位快到 的区域里(右图:红色圆是以 为圆心、半径 的圆,黑点是曲线和它擦边的位置)。前面的两个不等式给出 和 (29.2 dB),实测是 63.3° 和 57.2(35.1 dB):不等式成立,PM 比下界多了 5.6°,GM 多了约 6 dB。 这个全局量把两个局部量夹在了里面。
灵敏度和水床
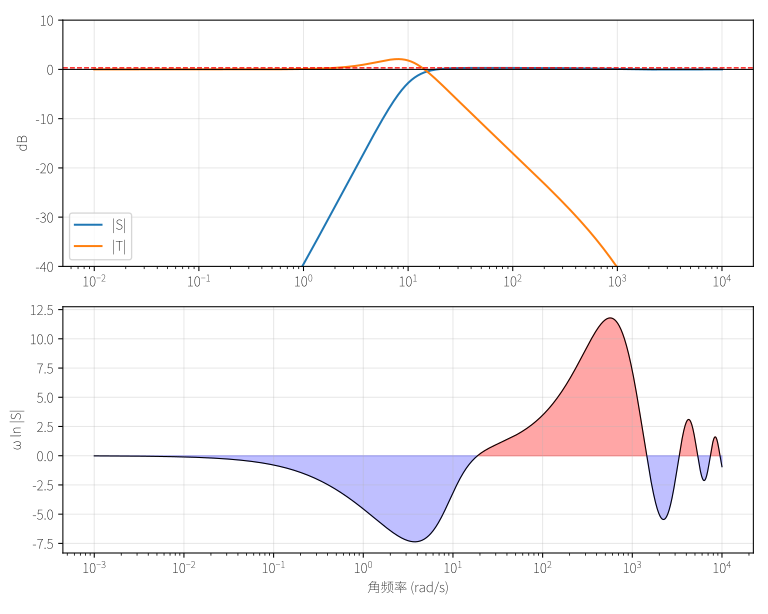
上图: 在 1 rad/s 处是 dB,再往下越来越低, 在 8.0 rad/s 附近有一个 2.1 dB 的小峰(,这是第 2 篇说的 PI 零点造成的)。 低得几乎看不出来,红色虚线只比 0 dB 线高 0.31 dB。
下图是 对 。这个量在对数横轴下的面积正好是 (因为 )。蓝色是 的部分,红色是 的部分。我做了数值积分(横轴从 到 rad/s,40 万个点):
- 红色面积 ,蓝色面积 ,总和 。
所以积分是 0,Bode 的积分在这个带积分器、带延迟的回路上成立,这是我想检验的。(准确说是红蓝相消到小数点后 5 位,剩下的误差来自有限的积分区间和离散化。)
这张图里有两件事我事先没想到。第一,红色那一块很高也很宽: 只比 1 大 3.5%,但在 18.8 到 1446 rad/s 的近两个数量级里都是正的(我从细网格里找到的两个过零点), 的峰值是 11.8,在 567 rad/s 处。低频压得越狠(蓝),高频就要用越宽的频带去还。第二,1446 rad/s 以后的几个小起伏是延迟造成的: 在高频让 绕着 的邻域转圈, 一会儿大于 1 一会儿小于 1,每个起伏的面积都在衰减。
D 项:相位几乎白拿,噪声增益不是
PID 的幅频特性在高频由 决定。我拿同一个 PI 加 (假设值),对比滤波时间常数 :
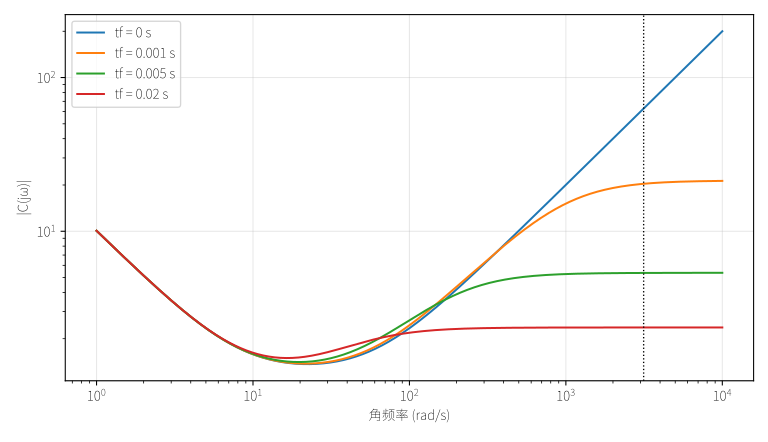
表里的列是穿越频率处的增益和相位超前(相对于纯 PI),以及采样的奈奎斯特频率 rad/s 处的增益:
- :穿越点处增益 1.4122、超前 11.16°,奈奎斯特处增益 62.844,是 的 46.0 倍。
- :1.4167、11.20°,奈奎斯特处 20.363(高频极限 )。
- :1.4348、11.32°,奈奎斯特处 5.356。
- :1.5003、11.02°,奈奎斯特处 2.366。
噪声增益从 62.8 降到 20.4(3.1 倍),在穿越频率处的相位超前只动了 0.04°。 原因是 rad/s 比 rad/s 低得多,滤波器在穿越点附近几乎没有相位代价。我猜这是实际调 D 项最容易被忽视的免费午餐:只要 比 高一个数量级以上,滤波不会伤到相位裕度。 增大到 0.02 s( rad/s,离 只有 3 倍)时超前降到 11.02°,开始比 0.005 s 时低,但变化仍然很小;这里的 本来就小,相位超前只有 11° 的量级,D 项在这个回路上不是主角。
检查点
在 pid-lab 根目录(nix develop 里)运行:
make -s ch03输出见上一节:12 个 ok 对比行(bode、margins、delay_0.9、delay_1.1 各对 C、C++、Rust),最大差值 0 到 ,容差 ;然后是裕度表(,PM 63.334°,GM 35.14 dB,, ms)、延迟检验(0.9 倍斜率 /s,1.1 倍 /s)、灵敏度积分和 D 项增益表,最后一行是 ch03 OK。report 里的断言(0.9 倍衰减且没碰限幅,1.1 倍增长且碰限幅,Bode 积分为零,精确采样模型的边界落在 72 和 73 拍之间)有任何一条不成立都会退出 1。
本篇新增的文件(tag tutorial-v1,本篇还会用到第 1、2 篇的 sim、plants、poly、complex,它们没有变化):
| 文件 | 命令 | 结果 |
|---|---|---|
python/pidlab/freq.py | make -s ch03 | 频率响应、相位展开、margins;对 scipy.signal.freqresp 幅值差 dB |
c/include/pl/freq.h、c/src/freq.c | make -s ch03 | bode_c.csv、margins_c.csv、两个延迟文件与 Python 最大差 0 |
c/include/pl/real.h | 同上 | 多了 PL_LOG10 |
cpp/include/pidlab/freq.h | make -s ch03 | *_cpp.csv 与 Python 最大差 0 |
rust/src/freq.rs、rust/src/real.rs | make -s ch03 | bode_rs.csv 差 ,margins_rs.csv 差 ;real.rs 多了 log10 |
驱动和应用:
| 文件 | 命令 | 结果 |
|---|---|---|
python/ch03_frequency_domain.py | python3 python/ch03_frequency_domain.py ref 或 report | ref 写数据和 Python 参考输出;report 比对、打印表、断言、画 5 张图 |
c/apps/ch03.c | make -s ch03 | ch03: C wrote bode, margins and 2 delay runs to out/ch03 |
cpp/apps/ch03.cc | make -s ch03 | ch03: C++ wrote ... |
rust/src/bin/ch03.rs | make -s ch03 | ch03: Rust wrote ... |
figures/ch03/ 下是 bode、nyquist、delay-margin-check、sensitivity、d-term-noise-gain 5 张 SVG,它们是 report 在本地生成的(figures/ 不进仓库)。
下一篇
这一篇我把“稳定的边界”变成了几个能读出来的数:63.3° 的相位裕度、35.1 dB 的增益裕度、72.875 ms 的延迟裕度,和一个把三者统一起来的 。延迟裕度的预测经受住了 0.9 和 1.1 倍的检验,包络斜率 /s 和 /s 跟精确离散模型的 /s 和 /s 一致。同时我也发现一个不起眼的细节会决定整数拍的答案:ZOH 的半个采样周期。
第 4 篇:离散化:位置式、增量式与采样率会把这个半拍放到台面上来。第 2 篇的 PI(这一篇取 ),我把采样周期从 1 ms 拉到 5、10、20 ms,看相位裕度掉多少、超调涨多少;再推位置式和增量式 PID 的等价关系,对比后向差分和 Tustin 两种 D 项离散化的振铃。这一篇手算的“半拍”,到时候会变成一张表。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!