
 Better Mistakes



音乐
暂未播放
18.06 第 29 讲:奇异值分解
- 118.06 第 1 讲:方程组的行图与列图
- 218.06 第 2 讲:用矩阵做消元
- 318.06 第 3 讲:矩阵乘法的四种看法与逆矩阵
- 418.06 第 4 讲:分解成 A = LU
- 518.06 第 5 讲:转置、置换与向量空间
- 618.06 第 6 讲:列空间与零空间
- 718.06 第 7 讲:解 Ax = 0,主变量与特解
- 818.06 第 8 讲:解 Ax = b,行最简形 R
- 918.06 第 9 讲:线性无关、基与维数
- 1018.06 第 10 讲:四个基本子空间
- 1118.06 第 11 讲:矩阵空间、秩 1 矩阵与小世界图
- 1218.06 第 12 讲:图、网络与关联矩阵
- 1318.06 第 13 讲:第一次测验复习
- 1418.06 第 14 讲:正交向量与正交子空间
- 1518.06 第 15 讲:投影到子空间
- 1618.06 第 16 讲:投影矩阵与最小二乘
- 1718.06 第 17 讲:正交矩阵与 Gram-Schmidt
- 1818.06 第 18 讲:行列式的性质
- 1918.06 第 19 讲:行列式公式与代数余子式
- 2018.06 第 20 讲:Cramer 法则、逆矩阵与体积
- 2118.06 第 21 讲:特征值与特征向量
- 2218.06 第 22 讲:对角化与矩阵的幂
- 2318.06 第 23 讲:微分方程与 exp(At)
- 2418.06 第 24 讲:Markov 矩阵与 Fourier 级数
- 2518.06 第 24b 讲:第二次测验复习
- 2618.06 第 25 讲:对称矩阵与正定性
- 2718.06 第 26 讲:复矩阵与快速 Fourier 变换
- 2818.06 第 27 讲:正定矩阵与极小值
- 2918.06 第 28 讲:相似矩阵与 Jordan 标准形
- 3018.06 第 29 讲:奇异值分解本文
- 3118.06 第 30 讲:线性变换及其矩阵
- 3218.06 第 31 讲:基变换与图像压缩
- 3318.06 第 32 讲:第三次测验复习
- 3418.06 第 33 讲:左逆、右逆与伪逆
- 3518.06 第 34 讲:期末复习
Strang 开场就说 SVD 是矩阵“最终的、最好的”分解:任何矩阵(不必方,不必可逆,不必对称)都能写成 ,正交矩阵乘对角矩阵再乘正交矩阵。我用他黑板上的 算了一遍:奇异值是 和 ,单位圆上 2000 个点乘上 以后,最长的半径是 5.6569,最短的是 4.2426,像是一个面积 75.3981 的椭圆。他在黑板上还算出了一个符号错误,当堂没有解决,我在下面给出原因。
视频:Lecture 29: Singular value decomposition(OCW 页面与字幕) 教材:《Introduction to Linear Algebra》第 6 版 §7.1 Singular Values and Singular Vectors 前置:第 28 讲:相似矩阵与 Jordan 标准形 一句话:行空间里有一组正交基,被 送进列空间里另一组正交基,只是各自拉伸了 倍;这组基由 的特征向量给出。
- 开头几分钟他先说明对称正定矩阵是 SVD 的特例(,一个 就够了),再画“行空间的正交基被送进列空间的正交基”那张图。这两段要认真看,整个 SVD 的想法都在这里。
- 把 里的 消掉、只剩 的那几行推导很短,下面我会用代码再算一遍,可以倍速。
- 第一个例子()算到最后,他得到了 和 对不上的符号,说周三再补。这一段值得看他怎么面对错误,我在“先算 ”一节里给出答案。
- 秩 1 的第二个例子、四个子空间的基(视频最后几分钟)本篇都算过了,倍速即可。
目标:行空间的一组正交基,送到列空间的一组正交基
先说他想要什么。回忆那张“最重要的图”:左边是行空间,右边是列空间, 把行空间里的每个向量送到列空间里。他问了一个很具体的问题:能不能在行空间里找一组 正交 基 ,使得它们被 送过去以后,在列空间里 仍然是正交的?
随便取一组正交基(Gram-Schmidt 能给你一组)通常做不到, 乘完直角就没了。他要的是一组特殊的基,使得
其中 是列空间里的单位向量, 是“拉伸的倍数”。他说这个倍数不再叫 了,叫 。零空间不用操心:把 取成零空间的正交基,把 取成 的零空间的正交基,对应的 全是 0,对角线上多几个 0 而已。
把这些式子并排写成矩阵,就是
和 都是方阵,列向量标准正交,所以逆就是转置,。和对角化 比,这里 要两个不同的正交矩阵(他的原话是“probably different”),好处是任何矩阵都做得到,而且两边都是正交矩阵,没有 那种数值上的烦恼。对称正定的 是唯一的例外:特征向量本来就正交,,。
怎么找 和 呢?他的办法是造一个让 消失的组合:
,所以 不见了。右边是对称矩阵 的 : 是 的特征向量, 是它的特征值( 半正定,特征值不会是负的,所以有实的正平方根)。反过来乘 , 消失, 是 的特征向量。
这样造出来的 为什么正好是标准正交的? 视频里没有展开,我补一下。 对称,,所以它半正定,特征向量 可以取成标准正交,特征值 。再看 们:
时内积是 0,说明 两两正交; 时 ,除以 就是单位向量。所以 天然是标准正交的,不需要再对 做一次特征分解。他讲 是为了让大家看见 是它的特征向量,但真要算的时候,这个公式更省事,也不会出符号问题(下一节会撞上)。
先算 :黑板上的第一个例子
他选的矩阵是
可逆,秩 2。他的步骤是:算 ,求特征向量和特征值,特征值开方得 ,再算 找 。我照着做,然后复现他在最后一步算错的地方:
import numpy as np
def main() -> None: np.set_printoptions(precision=4, suppress=True) A = np.array([[4.0, 4.0], [-3.0, 3.0]])
# 第一步:A^T A 的特征分解给出 V 和 sigma^2 print("A^T A =") print(A.T @ A) w, V = np.linalg.eigh(A.T @ A) order = np.argsort(w)[::-1] # 从大到小排 w, V = w[order], V[:, order] sigma = np.sqrt(w) print("A^T A 的特征值:", w) print("sigma =", sigma) print("v1 =", V[:, 0], " v2 =", V[:, 1])
# 第二步:A A^T 恰好是对角阵,特征向量是单位矩阵的列 print("A A^T =") print(A @ A.T)
# Strang 在黑板上的选择:U = 单位矩阵,V 取 (1, 1)/sqrt(2) 与 # (1, -1)/sqrt(2) V_board = np.array([[1.0, 1.0], [1.0, -1.0]]) / np.sqrt(2.0) U_board = np.eye(2) Sigma = np.diag(np.sqrt([32.0, 18.0])) print("U Sigma V^T(黑板上的选择)=") print(U_board @ Sigma @ V_board.T)
# 修正:U 的列不能独立挑,必须取 u_i = A v_i / sigma_i U = (A @ V_board) / np.sqrt([32.0, 18.0]) print("U = A V / sigma =") print(U) print("U Sigma V^T =") print(U @ Sigma @ V_board.T) print("还原出 A:", np.allclose(U @ Sigma @ V_board.T, A))
# 对照 NumPy U_np, s_np, Vt_np = np.linalg.svd(A) print("np.linalg.svd 的 sigma:", s_np) print("np 的 U:") print(U_np) print("np 的 V^T:") print(Vt_np)
if __name__ == "__main__": main()A^T A =[[25. 7.] [ 7. 25.]]A^T A 的特征值: [32. 18.]sigma = [5.6569 4.2426]v1 = [0.7071 0.7071] v2 = [-0.7071 0.7071]A A^T =[[32. 0.] [ 0. 18.]]U Sigma V^T(黑板上的选择)=[[ 4. 4.] [ 3. -3.]]U = A V / sigma =[[ 1. 0.] [ 0. -1.]]U Sigma V^T =[[ 4. 4.] [-3. 3.]]还原出 A: Truenp.linalg.svd 的 sigma: [5.6569 4.2426]np 的 U:[[-1. 0.] [ 0. 1.]]np 的 V^T:[[-0.7071 -0.7071] [-0.7071 0.7071]]读一下输出。,和他口算的一样(他还特意说“一定要对称”)。特征向量是 和 ,特征值是 32 和 18, 是 5.6569 和 4.2426。eigh 给出的 是 ,和他的差一个符号,这是特征向量天然的自由度,后面马上用得上。
恰好是对角阵 ,他说这是个“lucky case”:特征向量就是单位矩阵的两列,所以 。特征值也还是 32 和 18,他顺便提了一句: 和 的特征值一样。
问题出在乘回去的时候。用他的 和 乘出来的是 ,第二行的符号反了。他当堂的反应是“Phooey”,说想想再讲。(我挺喜欢这种场面:一个 1999 年的教授在讲台上被自己的矩阵打了脸,然后说周三再来。)
答案是: 的列不能独立挑。 作为 的特征向量, 和 都合格,但一旦 固定了, 就把符号定死了。正确的做法是先求 和 ,再令 。代码里的 U = (A @ V_board) / ... 就是这样做的,得到 ,乘回去恰好是 。np.linalg.svd 给出的 和 的符号和我的不同(它把两个 和 的符号各翻了一下),但每一对 的符号是同步的,所以乘积一样。SVD 的唯一性只到每一对 同时变号为止。
据我所知,视频里这个符号问题当堂没有解决,我这里给的是自己推的解释,用上面的输出验证过了。
秩 1 的例子与四个子空间
他的第二个例子是奇异矩阵
秩 1:行空间是 所在的直线,列空间是 所在的直线,另外两个子空间(零空间和左零空间)是它们各自的垂线。他的答案是 ,,(来自 ,秩 1 所以另一个特征值是 0,迹是 125)。 和 只需要补成标准正交基。他还说乘回去时 和 约掉得到 5,整数就出来了:
import numpy as np
def main() -> None: np.set_printoptions(precision=4, suppress=True) A = np.array([[4.0, 3.0], [8.0, 6.0]]) print("rank =", np.linalg.matrix_rank(A)) print("A^T A =") print(A.T @ A) print("A^T A 的特征值:", np.linalg.eigvalsh(A.T @ A))
# 黑板上的答案:u1 = (1, 2)/sqrt(5),v1 = (0.8, 0.6),sigma1 = sqrt(125) U = np.array([[1.0, 2.0], [2.0, -1.0]]) / np.sqrt(5.0) Sigma = np.array([[np.sqrt(125.0), 0.0], [0.0, 0.0]]) Vt = np.array([[0.8, 0.6], [0.6, -0.8]]) print("U Sigma V^T =") print(U @ Sigma @ Vt) print("还原出 A:", np.allclose(U @ Sigma @ Vt, A))
# 多出来的那一对向量被 sigma = 0 吃掉 v2 = Vt[1] u2 = U[:, 1] print(f"|A v2| = {np.linalg.norm(A @ v2):.1e}(v2 在 A 的零空间里)") print(f"|A^T u2| = {np.linalg.norm(A.T @ u2):.1e}(u2 在 A^T 的零空间里)")
# 对照 NumPy U_np, s_np, Vt_np = np.linalg.svd(A) print("np.linalg.svd 的 sigma:", s_np) print(f"sqrt(125) = {np.sqrt(125.0):.4f}") rank_one = s_np[0] * np.outer(U_np[:, 0], Vt_np[0]) print("sigma1 * u1 v1^T 等于 A:", np.allclose(rank_one, A))
if __name__ == "__main__": main()rank = 1A^T A =[[80. 60.] [60. 45.]]A^T A 的特征值: [ 0. 125.]U Sigma V^T =[[4. 3.] [8. 6.]]还原出 A: True|A v2| = 9.9e-16(v2 在 A 的零空间里)|A^T u2| = 0.0e+00(u2 在 A^T 的零空间里)np.linalg.svd 的 sigma: [11.1803 0. ]sqrt(125) = 11.1803sigma1 * u1 v1^T 等于 A: True把 和 这一对吃掉了: 是零向量(浮点误差 ), 也是零向量。所以 在零空间里, 在左零空间里。对角阵里这个 0,就是“零空间不用操心”的意思。
这正是视频最后几分钟的结论:SVD 给四个基本子空间同时选好了标准正交基。
- :行空间。
- :列空间。
- :零空间,共 个。
- :左零空间,共 个。
Gram-Schmidt(第 17 讲)也能给出标准正交基,但他说它给不出“让矩阵对角”的基,这里需要特征值。我用一个非方的矩阵验证维数:随机造一个 、秩为 2 的矩阵( 乘 ),取完整的 SVD:
import numpy as np
def main() -> None: np.set_printoptions(precision=4, suppress=True) rng = np.random.default_rng(1806)
# 一个 4 x 3、秩为 2 的矩阵:m = 4,n = 3,r = 2 A = rng.standard_normal((4, 2)) @ rng.standard_normal((2, 3)) m, n = A.shape U, s, Vt = np.linalg.svd(A) # 完整的 SVD:U 是 4 x 4,V^T 是 3 x 3 V = Vt.T r = int(np.sum(s > 1e-10)) print("sigma =", s) print("m, n, r =", m, n, r)
# 四个子空间的正交归一基 print( "A v_i = sigma_i u_i(i < r):", np.allclose(A @ V[:, :r], U[:, :r] * s[:r]), ) print( "|A V_null| =", f"{np.linalg.norm(A @ V[:, r:]):.1e}", ",列数 n - r =", n - r, ) print( "|A^T U_null| =", f"{np.linalg.norm(A.T @ U[:, r:]):.1e}", ",列数 m - r =", m - r, ) print( "U 与 V 都是正交矩阵:", np.allclose(U.T @ U, np.eye(m)), np.allclose(V.T @ V, np.eye(n)), )
# A^T A 与 A A^T 的非零特征值都是 sigma^2,其余的是 0 w_right = np.linalg.eigvalsh(A.T @ A)[::-1][:r] w_left = np.linalg.eigvalsh(A @ A.T)[::-1][:r] print("A^T A 的前 r 个特征值:", w_right) print("A A^T 的前 r 个特征值:", w_left) print("sigma^2(前 r 个)=", s[:r] ** 2)
# 对称正定的特殊情形:奇异值就是特征值 S = np.array([[2.0, -1.0], [-1.0, 2.0]]) lam = np.linalg.eigvalsh(S) s_spd = np.linalg.svd(S, compute_uv=False) print("S 的特征值:", lam[::-1], ",奇异值:", s_spd)
if __name__ == "__main__": main()sigma = [1.8858 0.4917 0. ]m, n, r = 4 3 2A v_i = sigma_i u_i(i < r): True|A V_null| = 1.5e-16 ,列数 n - r = 1|A^T U_null| = 3.8e-16 ,列数 m - r = 2U 与 V 都是正交矩阵: True TrueA^T A 的前 r 个特征值: [3.5561 0.2418]A A^T 的前 r 个特征值: [3.5561 0.2418]sigma^2(前 r 个)= [3.5561 0.2418]S 的特征值: [3. 1.] ,奇异值: [3. 1.]第三个奇异值是 0,所以 。 的范数是 ,只有 列; 是 ,有 列,维数和第 10 讲的四个基本子空间完全对得上。()和 ()的形状不同,但非零特征值都是 3.5561 和 0.2418,等于 :它们是同一组数,只是放进了不同大小的矩阵。最后一行是对称正定的特例: 的特征值和奇异值都是 3 和 1。(如果有负特征值,奇异值是它的绝对值, 和 的对应列差一个符号,这一条我没有在代码里验证。)
单位圆变成椭圆
回到第一个例子,换成几何的看法。 是对 做了三件事:先用 转一下(正交,不改变长度),再用 沿两个坐标轴分别拉伸 和 倍,最后用 再转一下。所以 把单位圆映成一个椭圆,半轴长就是 ,半轴方向就是 ,而单位圆上被映成长轴和短轴的点,正好是 。把一团圆形的面团沿两个垂直的方向擀开,擀面杖的方向是 ,擀出来的长短轴是 。这个类比就用这一次。
数一下:
import numpy as np
def main() -> None: np.set_printoptions(precision=4, suppress=True) A = np.array([[4.0, 4.0], [-3.0, 3.0]]) U, s, Vt = np.linalg.svd(A)
# 单位圆上取 2000 个点,整体乘 A t = np.linspace(0.0, 2.0 * np.pi, 2000, endpoint=False) circle = np.vstack([np.cos(t), np.sin(t)]) # 2 x 2000 ellipse = A @ circle lengths = np.linalg.norm(ellipse, axis=0) print("sigma =", s) print("像的最长半径:", f"{lengths.max():.4f}") print("像的最短半径:", f"{lengths.min():.4f}")
# 椭圆的半轴方向就是 u_i:把像转到 U 的坐标系,再除以 sigma canonical = (U.T @ ellipse) / s[:, None] on_unit_circle = np.allclose(np.linalg.norm(canonical, axis=0), 1.0) print("U^T y / sigma 回到单位圆:", on_unit_circle)
# 面积:鞋带公式,与 pi * sigma1 * sigma2 = pi * |det A| 对照 x, y = ellipse area = 0.5 * abs(np.sum(x * np.roll(y, -1) - np.roll(x, -1) * y)) print("椭圆面积(鞋带公式):", f"{area:.4f}") print("pi * sigma1 * sigma2 =", f"{np.pi * s[0] * s[1]:.4f}") print("pi * |det A| =", f"{np.pi * abs(np.linalg.det(A)):.4f}")
# 把 v1 和 v2 送进去:长度被拉成 sigma,方向落在 u1 和 u2 上 for i in range(2): image = A @ Vt[i] print( f"A v{i + 1} =", image, ",等于 sigma * u:", np.allclose(image, s[i] * U[:, i]), )
if __name__ == "__main__": main()sigma = [5.6569 4.2426]像的最长半径: 5.6569像的最短半径: 4.2426U^T y / sigma 回到单位圆: True椭圆面积(鞋带公式): 75.3981pi * sigma1 * sigma2 = 75.3982pi * |det A| = 75.3982A v1 = [-5.6569 0. ] ,等于 sigma * u: TrueA v2 = [0. 4.2426] ,等于 sigma * u: True2000 个点的像里,最长的半径是 5.6569,最短的是 4.2426,和 、 在四位小数里一致。把像用 转到椭圆自己的坐标系再除以 ,所有点都回到单位圆上,说明这确实是一个以 为轴、以 为半轴的椭圆。面积由鞋带公式算得 75.3981(离散化的误差),, 就是 。最后两行直接验证了 :,,两个像互相垂直,这就是 Strang 在那张图上画的“两个直角”。
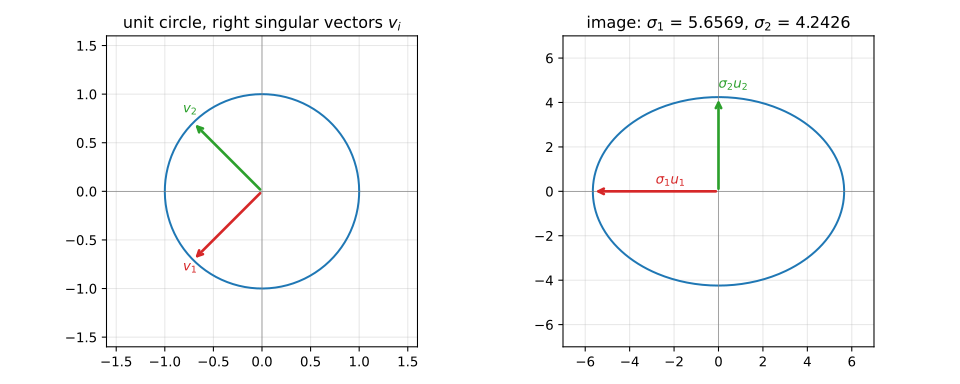
上面这张图由下面这个脚本生成(需要 matplotlib,在当前目录写出 SVG;图中的数据与前面的代码块相同):
import matplotlibimport matplotlib.pyplot as pltimport numpy as np
def main() -> None: matplotlib.use("Agg") plt.rcParams["svg.hashsalt"] = "la1806"
A = np.array([[4.0, 4.0], [-3.0, 3.0]]) U, s, Vt = np.linalg.svd(A) t = np.linspace(0.0, 2.0 * np.pi, 400) circle = np.vstack([np.cos(t), np.sin(t)]) ellipse = A @ circle
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10, 4)) ax1.plot(*circle, color="tab:blue") ax2.plot(*ellipse, color="tab:blue") colors = ["tab:red", "tab:green"] for i in range(2): v = Vt[i] u = s[i] * U[:, i] ax1.annotate( "", xy=v, xytext=(0, 0), arrowprops=dict(arrowstyle="->", color=colors[i], lw=2), ) ax1.text(v[0] * 1.15, v[1] * 1.15, f"$v_{i + 1}$", color=colors[i]) ax2.annotate( "", xy=u, xytext=(0, 0), arrowprops=dict(arrowstyle="->", color=colors[i], lw=2), ) pos = 0.5 * u + np.array([0.0, 0.35]) if i == 0 else u * 1.1 ax2.text( pos[0], pos[1], f"$\\sigma_{i + 1} u_{i + 1}$", color=colors[i] ) ax1.set_title("unit circle, right singular vectors $v_i$") ax2.set_title(f"image: $\\sigma_1$ = {s[0]:.4f}, $\\sigma_2$ = {s[1]:.4f}") ax1.set_xlim(-1.6, 1.6) ax1.set_ylim(-1.6, 1.6) ax2.set_xlim(-7, 7) ax2.set_ylim(-7, 7) for ax in (ax1, ax2): ax.set_aspect("equal") ax.axhline(0, color="gray", lw=0.5) ax.axvline(0, color="gray", lw=0.5) ax.grid(alpha=0.3) fig.tight_layout() fig.savefig( "l29-circle-ellipse.svg", metadata={"Date": None}, )
if __name__ == "__main__": main()注意图里 指向左下, 指向左:这是 np.linalg.svd 选的符号。换成黑板上的符号只会让箭头翻到另一边,椭圆本身不变。
在控制里
多变量控制里的“增益”不是一个数,而是一个矩阵 :输入 是几个执行器,输出 是几个被控量。这时 SVD 回答的问题是:哪个输入方向增益大,哪个增益小? 奇异值 是任何单位输入能得到的最大输出, 是最小的, 就是条件数。PID 控制系列第 8 篇里 Wood–Berry 精馏塔的稳态增益矩阵是 ,那篇用相对增益阵(RGA)判断了输入输出怎么配对,这里用 SVD 看同一个矩阵:
import numpy as np
def main() -> None: np.set_printoptions(precision=4, suppress=True)
# Wood-Berry 精馏塔的稳态增益矩阵 G(0),y = G u G = np.array([[12.8, -18.9], [6.6, -19.4]]) U, s, Vt = np.linalg.svd(G) print("sigma =", s) print("条件数 sigma1 / sigma2 =", f"{s[0] / s[1]:.2f}") print("np.linalg.cond(G) =", f"{np.linalg.cond(G):.2f}") print("高增益的输入方向 v1 =", Vt[0], ",输出方向 u1 =", U[:, 0]) print("低增益的输入方向 v2 =", Vt[1], ",输出方向 u2 =", U[:, 1])
# 单位长度的输入,沿不同方向推,输出有多长 theta = np.linspace(0.0, np.pi, 1000) inputs = np.vstack([np.cos(theta), np.sin(theta)]) gains = np.linalg.norm(G @ inputs, axis=0) print( "1000 个方向上的增益:", f"{gains.min():.4f}", "到", f"{gains.max():.4f}", ) for name, u in [("u = (1, 0)", [1.0, 0.0]), ("u = (0, 1)", [0.0, 1.0])]: print(name, "的增益:", f"{np.linalg.norm(G @ np.array(u)):.4f}")
# 要让输出沿 u1、u2 各长 1,输入要多长 for i in range(2): u_need = np.linalg.solve(G, U[:, i]) print( f"输出沿 u{i + 1} 长为 1,所需输入的长度:", f"{np.linalg.norm(u_need):.4f}", )
if __name__ == "__main__": main()sigma = [30.4048 4.0645]条件数 sigma1 / sigma2 = 7.48np.linalg.cond(G) = 7.48高增益的输入方向 v1 = [-0.4585 0.8887] ,输出方向 u1 = [-0.7454 -0.6666]低增益的输入方向 v2 = [-0.8887 -0.4585] ,输出方向 u2 = [-0.6666 0.7454]1000 个方向上的增益: 4.0647 到 30.4048u = (1, 0) 的增益: 14.4014u = (0, 1) 的增益: 27.0845输出沿 u1 长为 1,所需输入的长度: 0.0329输出沿 u2 长为 1,所需输入的长度: 0.2460两个奇异值是 30.4048 和 4.0645,条件数 7.48。单位长度的输入沿不同方向推,增益从 4.0647 到 30.4048(和 、 在网格精度内一致)。只推单个输入时,增益取决于哪个输入: 的增益是 14.4014, 是 27.0845,都夹在两个极值中间。要把输出沿 推 1 个单位,输入长度是 0.0329;沿 推 1 个单位,输入长度是 0.2460,比值恰好是条件数 7.48。
读法是:这个塔的输出沿 的方向最“难推”,需要的输入是另一个方向的 7.48 倍,如果输入有限幅,我猜这个方向会先撞上限幅。我也猜这就是 MIMO 控制里“条件数大,对模型误差敏感、要小心解耦”的由来;这一篇我只验证了稳态增益的方向性,没有验证它对闭环性能的影响。
下一讲
这一讲的 SVD 把行空间和列空间配成了一对一对的正交方向。下一讲 Strang 要问的是:任何一个线性变换,换一组基,矩阵长什么样?SVD 正是“选两组好基让矩阵最简单”的一个答案,细节见 18.06 第 30 讲:线性变换及其矩阵。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!