
 Better Mistakes



音乐
暂未播放
字体与中文排版
- 1第一份文档:标记语法、编译与 watch
- 2代码模式:值、类型与控制流
- 3函数与 content:一切都是函数调用
- 4set 与 show:样式是规则,不是命令
- 5字体与中文排版本文
- 6页面与布局:盒子、网格与浮动
- 7context、计数器与状态:Typst 如何“多遍”编译
- 8数学公式
- 9图、表、代码与交叉引用
- 10参考文献:BibTeX、Hayagriva 与 GB/T 7714
- 11数据驱动:用一份 YAML 生成中英文简历
- 12作业模板:模块、多文件与条件编译
- 13幻灯片与绘图
- 14生态:Typst Universe 与第三方包
- 15用 Rust 写一个 WebAssembly 插件:按拼音排序术语表
- 16导出、工具链与 CI
pdffonts 对一份常规字重的中文 PDF 打印出的字体名是 NotoSerifCJKsc-ExtraLight。我没有要过 ExtraLight,正文明明是常规字重。这个名字的答案要拆成三层才讲得清:Typst 怎么在一串字体里给每个字符挑字体,可变字体在 PDF 里怎么命名,以及中文排版里 text 和 par 的哪几个参数真正有用。这一篇把这三层逐个跑通,最后收成 xuan 的两个文件:fonts.typ(13 行)和 cjk.typ(21 行)。
这一篇结束时你会有:src/fonts.typ 和 src/cjk.typ,两个都是最终版本,之后不会再改。第 4 篇的 base.typ 里已经有一行 show: xuan-cjk.with(lang: lang),那一篇我把它当黑盒用,这一篇打开它。lab/ch05/ 下的 6 个文件(含一个预期产生警告的)全部通过 make ch05。
前置:第 4 篇(set、show、xuan 包骨架)。环境和第 1 篇一样:nix develop 里的 Typst 0.15.1,字体由 flake.nix 通过 TYPST_FONT_PATHS 提供。
在仓库里,xuan 的源文件位于 packages/local/xuan/0.1.0/src/,文中说的 src/fonts.typ 都指这个目录。
先看 Typst 能看见哪些字体
写 set text(font: ...) 之前,先问 Typst 它手里有什么。typst fonts 列出所有家族名,每行一个。我先在仓库的 nix develop 里跑加了 --ignore-system-fonts 的版本,这也是 scripts/chapter.sh 编译每个 lab 文件时用的参数:
$ typst fonts --ignore-system-fontsDejaVu Sans MonoLibertinus SerifMaple Mono NFNew Computer ModernNew Computer Modern MathNoto Sans CJK HKNoto Sans CJK JPNoto Sans CJK KRNoto Sans CJK SCNoto Sans CJK TCNoto Sans Mono CJK HKNoto Sans Mono CJK JPNoto Sans Mono CJK KRNoto Sans Mono CJK SCNoto Sans Mono CJK TCNoto Serif CJK HKNoto Serif CJK JPNoto Serif CJK KRNoto Serif CJK SCNoto Serif CJK TC$ typst fonts --ignore-system-fonts | wc -l2020 个家族,来源有两处:
- DejaVu Sans Mono、Libertinus Serif、New Computer Modern、New Computer Modern Math 这 4 个嵌在 Typst 可执行文件里,不用装任何东西就能用。
- 其余 16 个来自
TYPST_FONT_PATHS:flake.nix的shellHook把 Noto Serif CJK、Noto Sans CJK 和 Maple Mono NF CN 三个目录用:拼起来导出,其中 15 个是 Noto 家族,1 个是 Maple Mono NF。Maple Mono 只给第 1 篇的基准测试用,xuan自己只点名大约 6 个家族:Libertinus Serif、Noto Serif CJK SC、Noto Sans CJK SC、DejaVu Sans Mono、Noto Sans Mono CJK SC、New Computer Modern Math。
不加限制会怎样?我在同一个 shell 里直接跑 typst fonts | wc -l,得到 284,因为这台机器的系统字体里已经有 229 个 Noto 家族(env -u TYPST_FONT_PATHS typst fonts | grep -c Noto 的输出)。同一份源文件在另一台机器上会看见另一批字体,编译结果可能不一样。仓库里每个编译命令都带 --ignore-system-fonts,原因就在这里:让字体集合只由嵌入字体加 flake 提供的字体决定,你和我编出来的 PDF 用的是同一批字体。
CLI 上和字体有关的开关就这几个,我把每一个都跑了一遍:
| 开关 | 作用 | 我在这个 shell 里看到的家族数 |
|---|---|---|
| (无) | 嵌入字体 + 系统字体 + TYPST_FONT_PATHS | 284 |
--ignore-system-fonts | 去掉系统字体 | 20 |
env -u TYPST_FONT_PATHS ... --ignore-system-fonts | 再去掉环境变量里的目录 | 4(只剩嵌入字体) |
--ignore-system-fonts --ignore-embedded-fonts | 去掉嵌入字体,保留环境变量 | 16 |
--font-path <dir>(只给第一个 Noto 目录,不带环境变量) | 额外扫描一个目录 | 9(4 嵌入 + 5 个 Noto Serif CJK) |
--font-path 和环境变量 TYPST_FONT_PATHS 等价,后者用 : 分隔多个目录。官方文档写的优先级是 --font-path 高于系统字体,系统字体高于嵌入字体。
--ignore-embedded-fonts 值得单独做个实验,因为它会让一个常见的“找不到字体”变得很安静。我写了个只有一行的文件,要求 Libertinus Serif,再把嵌入字体关掉:
$ typst compile --ignore-system-fonts --ignore-embedded-fonts emb.typ emb.pdfwarning: unknown font family: libertinus serif ┌─ emb.typ:1:16 │1 │ #set text(font: "Libertinus Serif") │ ^^^^^^^^^^^^^^^^^^
$ echo $?0警告,不是错误,退出码 0。文件只有两行:#set text(font: "Libertinus Serif") 加一行 Typst 排版。看 pdffonts 画了什么:
$ pdffonts emb.pdfname type encoding emb sub uni object ID------------------------------------ ----------------- ---------------- --- --- --- ---------GZMBIX+NotoSerifCJKjp-ExtraLight CID TrueType Identity-H yes yes yes 8 0Typst 悄悄换了一个字体,连 Typst 这几个拉丁字母都由 NotoSerifCJKjp 画。这是下一节要讲的“最后兜底”:指定的字体不存在,就去所有可用字体里找一个最像的。注意它挑的是日文版本的 Noto Serif,而不是你想要的简体版。
字体列表:每个字符各找各的
text 的 font 参数接受三种东西:一个字符串,一个字符串数组(优先级列表),或者数组里夹着带 covers 的字典。lab/ch05/fonts.typ 的前半(源文件,文件分两段引用,中间没有改动):
#set page(width: 14cm, height: auto, margin: 1cm)
// A font list is a fallback chain: Typst picks the first family covering// each character. Latin falls to Libertinus, Chinese to Noto Serif CJK SC.#set text(font: ("Libertinus Serif", "Noto Serif CJK SC"), size: 12pt)
Fallback:Typst 排版 abc 123。
// `covers` restricts a family to a set of characters.#let latin-only = ( name: "Noto Serif CJK SC", covers: regex("[\u{4e00}-\u{9fff}]"),)#text(font: ( latin-only, "Libertinus Serif",))[Han 走 Noto,English 走 Libertinus。]列表的语义不是“选第一个存在的字体”,而是“对每个字符,选第一个包含这个字符的字形的字体”。 这像 shell 查 $PATH:每个命令独立地从左往右找第一个可执行文件,一个目录里没有,就看下一个目录(这个类比我只用这一次)。所以 ("Libertinus Serif", "Noto Serif CJK SC") 的意思是:Latin 字母和数字由 Libertinus 画,Libertinus 里没有的汉字由 Noto Serif CJK SC 画。
顺序为什么重要?Noto Serif CJK 自带一套 Latin 字母,所以把两个字体颠倒过来,Latin 也会被 Noto 抢走。更隐蔽的是标点:Libertinus 有 U+201C 和 U+201D(弯引号),Noto 也有。我写了一个实验 order.typ,同一句话用三种字体列表各排一遍:
#set page(width: auto, height: auto, margin: 12pt)#set text(size: 14pt, lang: "zh", region: "cn")#let sample = [Typst 2026 (括号) “引号”,句号。]#let a = ("Libertinus Serif", "Noto Serif CJK SC")#let b = ("Noto Serif CJK SC", "Libertinus Serif")#let c = ( (name: "Libertinus Serif", covers: "latin-in-cjk"), "Noto Serif CJK SC",)#grid( columns: 2, gutter: 0.8em, align: left + horizon, [`A`], text(font: a, sample), [`B`], text(font: b, sample), [`C`], text(font: c, sample),)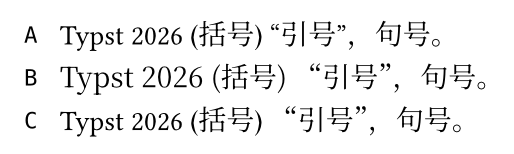
这三行的区别,用 pdffonts 看得更直接:A 用了 LibertinusSerif-Regular 和 NotoSerifCJKsc 两个字体,B 只用了 NotoSerifCJKsc 一个,C 又是两个。我还量了 “引号” 四个字符在 A 和 C 下的宽度(quote-width.typ,a 和 c 与上面 order.typ 里的定义相同):
#set text(size: 14pt, lang: "zh", region: "cn")#let a = ("Libertinus Serif", "Noto Serif CJK SC")#let c = ( (name: "Libertinus Serif", covers: "latin-in-cjk"), "Noto Serif CJK SC",)#context { let w(font) = measure(text(font: font)[“引号”]).width.pt() [A:#w(a) pt,C:#w(c) pt]}A:38.5 pt,C:42 pt两枚引号加起来,A 占 10.5 pt,C 占 14 pt,宽度差了 3.5 pt,眼睛也看得出来。看图:
- A(朴素写法):字母和数字是 Libertinus,窄而紧凑,但
“引号”的弯引号也来自 Libertinus,是西文那种窄引号,比汉字小一圈。 - B:一切都由 Noto 画,字母明显变宽,弯引号是全角占位的,符合中文习惯。
- C:给 Libertinus 加了
covers: "latin-in-cjk"。官方文档对这个预设的描述是:覆盖所有码点,除了那些“在 Latin 字体里也有,但最好取自 CJK 字体”的(原文 covers all codepoints except for those which exist in Latin fonts, but should preferably be taken from CJK fonts)。结果是字母和数字仍然来自 Libertinus,引号和括号交给了 Noto。
A 是最朴素的写法,也是最容易踩的坑,C 是 xuan 用的。 A 行的引号和 B 行的肉眼可见地不一样,我跑了 pdffonts 和上面的宽度测量来确认原因:Libertinus 里有 U+201C 和 U+201D,A 的列表里它排在 Noto 前面,所以引号归它。C 给 Libertinus 加 covers: "latin-in-cjk",把这类字符让给 Noto,引号就是全角的。后面显示的 fonts.typ 用的就是 C。
covers:给一个家族划定职责
covers 也可以是一个正则,官方文档说只能是“一个点、一个字母或一个字符类”。上面 fonts.typ 里的 latin-only 就是一个字符类:Noto Serif CJK SC 只负责 U+4E00 到 U+9FFF 的汉字,其他码点直接跳过。渲染出来:
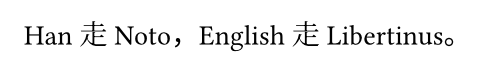
注意,名字叫 latin-only 不准确,它其实是“汉字只用 Noto”。更值得看的是这行里的逗号和句号 ,。。这两个字符不在 Libertinus 里,Noto Serif CJK SC 又被 covers 限定在汉字区间,两个字体都跳过了它们。这时 Typst 的行为是“最后兜底”:从所有可用字体里找一个有这个字形的。我对这行单独跑了 pdffonts:
$ pdffonts cov.pdfname type encoding emb sub uni object ID------------------------------------ ----------------- ---------------- --- --- --- ---------KFQELT+LibertinusSerif-Regular-Identity-H CID Type 0C Identity-H yes yes yes 8 0TPBOKN+NotoSerifCJKsc-ExtraLight CID TrueType Identity-H yes yes yes 11 0OXUTFP+NotoSansCJKjp-Thin CID TrueType Identity-H yes yes yes 14 0第三行就是它:Noto Sans CJK JP,一个无衬线的日文字体,被拿去画两个全角标点。lab/ch05/fonts.typ 里的整页渲染里也有同样的字体,因为这个文件的 latin-only 例子就是这样写的。解法是在列表末尾再追加一次不带 covers 的 "Noto Serif CJK SC" 作为兜底。我在 cov2.typ 里这样写:
#set page(width: auto, height: auto, margin: 12pt)#set text(size: 14pt)#let han = (name: "Noto Serif CJK SC", covers: regex("[\u{4e00}-\u{9fff}]"))#text(font: ( han, "Libertinus Serif", "Noto Serif CJK SC",))[Han 走 Noto,English 走 Libertinus。]pdffonts 里 NotoSansCJKjp-Thin 消失了,只剩 Libertinus 和 NotoSerifCJKsc 两行。(实验文件在 /tmp/p5,没有放进仓库,代码就在文中。)
找不到、不兜底、没字体
lab 里有两个文件专门看“字体找不到”。第一个是 unknown-font.warn.typ(源文件):
// A family that no font provides only produces a warning; text falls back.#set text(font: ("No Such Font", "Libertinus Serif"))Typst falls back to the next family.make ch05 会检查它退出码为 0 且 stderr 非空,stderr 存在 out/ch05/unknown-font.stderr:
warning: unknown font family: no such font ┌─ lab/ch05/unknown-font.warn.typ:2:16 │2 │ #set text(font: ("No Such Font", "Libertinus Serif")) │ ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^Typst 把家族名转成小写再报告,警告针对的是整个列表(指向整个数组,不是单个名字)。文字照样排出来,用的是列表里的下一个。
第二个是 missing-glyph.typ(源文件),演示 fallback 参数:
// With fallback off, a missing character is drawn as a tofu box and Typst// stays silent. Compare with the default.#set text(font: "Libertinus Serif")默认:Latin 与 汉字 \#text(fallback: false)[关闭:Latin 与 汉字]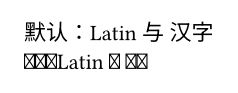
(这张图是同一份文件,我把页面设成了自动大小以便截图。)fallback: true 是默认值,Typst 会翻遍所有可用字体找一个有这个字符的。关掉它之后,汉字和全角冒号变成豆腐块,而且没有任何警告,out/ch05/missing-glyph.stderr 是空的,这也是为什么 missing-glyph.typ 不是 .warn.typ。官方文档也写了这一点:目前没有“字体缺字”的警告。结论是:排版出豆腐块时,Typst 不会告诉你,只能靠肉眼检查,或者配合 pdffonts 看用了哪些字体。
把这两个“静默”场景合起来,再看一个更极端的:不设 TYPST_FONT_PATHS,也不装任何 CJK 字体,编译同一份 emb.typ:
$ env -u TYPST_FONT_PATHS typst compile --ignore-system-fonts emb.typ emb3.pdf$ echo $?0$ pdffonts emb3.pdfname type encoding emb sub uni object ID------------------------------------ ----------------- ---------------- --- --- --- ---------MOITFO+LibertinusSerif-Regular-Identity-H CID Type 0C Identity-H yes yes yes 8 0退出码 0,stderr 空,PDF 里只有 Libertinus。没有任何字体能画“排版”两个字,汉字渲染成什么我没有逐像素看,但 Typst 没有提醒你一个字。中文文档一定要让你的构建环境显式提供 CJK 字体,这就是 flake.nix 里 noto-fonts-cjk-serif 的意义。
字重、字形与 0.15 的 variations
lab/ch05/fonts.typ 的后半:
// Weight, style, tracking, spacing.#text(weight: "bold")[粗体 bold] #text(style: "italic")[italic 斜体]#text(tracking: 2pt)[字距 tracking] #text(spacing: 200%)[词距 word spacing]
// 0.15: variable fonts expose axes through `variations`.#text(weight: 300)[Light 300 轻] \#text(weight: 900)[Black 900 黑] \#text(variations: (wght: 600))[wght=600 手动指定]
// OpenType features and number styles.#text(features: ("smcp",))[Small caps via feature] \#text(number-type: "old-style")[0123456789] vs#text(number-type: "lining")[0123456789]#smallcaps[smallcaps] #upper[upper] #lower[LOWER]整个文件编出来是这样:
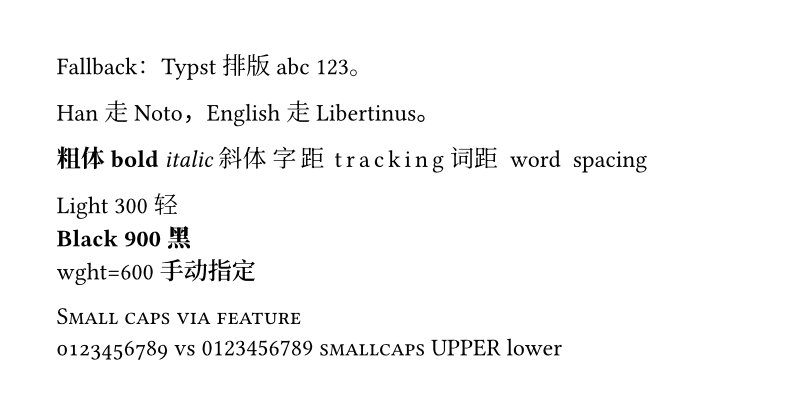
前面几个参数逐个过:
weight:整数 100 到 900 或名字("bold"是 700,"light"是 300,"regular"是 400)。style:"normal"、"italic"、"oblique"。图里italic 斜体一行,italic是斜的,斜体两个字仍是直立的:Noto CJK 没有斜体,Typst 找不到斜体字形就退回 normal,不会把汉字强行倾斜(官方文档写的是 When neither an italic nor an oblique style is available, Typst selects the normal style,这张图是它的实例)。tracking:字符之间额外加的距离。图里t r a c k i n g被撑开了,汉字“字距”也跟着撑开。spacing:词间距,只影响空格,所以word spacing里两个单词隔得很远,中间没有空格的汉字不受影响。它可以是绝对长度,也可以是相对于该字体空格宽度的百分比。size:第 4 篇已经讲了em相对继承字号。
字体名里的 ExtraLight
现在回答开头那个问题。typst fonts --variants 把每个字体的变体列出来,我看 Noto Serif CJK SC:
$ typst fonts --ignore-system-fonts --variants...Noto Serif CJK SC └ /nix/store/4gqvskjagg0w5zs36y6dg7h0nzinh1ci-noto-fonts-cjk-serif-2.003/share/fonts/opentype/noto-cjk/NotoSerifCJK-VF.otf.ttc (Variable) Style: Normal Stretch: 100% Weight: 200-900 (Default: 200)...只有一个文件,标着 (Variable),字重轴范围 200 到 900,默认实例是 200,即 ExtraLight。对照一下 Libertinus Serif,它是六个静态字体:
Libertinus Serif ├ (Embedded) │ Style: Normal, Weight: 400, Stretch: 100% ├ (Embedded) │ Style: Normal, Weight: 700, Stretch: 100% ├ (Embedded) │ Style: Italic, Weight: 400, Stretch: 100% ├ (Embedded) │ Style: Italic, Weight: 700, Stretch: 100% ├ (Embedded) │ Style: Normal, Weight: 600, Stretch: 100% └ (Embedded) Style: Italic, Weight: 600, Stretch: 100%可变字体的文件里只有一份轮廓数据加上一根字重轴。Typst 按 weight 去那根轴上取对应的值,把结果插值后嵌进 PDF,但 PDF 里给这个字体对象起名字用的是文件的默认实例名,也就是 ExtraLight。我验证了一下:写一个文件,同一个 Noto Serif CJK SC,用 400、700、900 三种字重各排两个字:
#set text(font: "Noto Serif CJK SC")#text(weight: 400)[常规]#text(weight: 700)[粗体]#text(weight: 900)[黑体]$ pdffonts var-names.pdfname type encoding emb sub uni object ID------------------------------------ ----------------- ---------------- --- --- --- ---------YDGOLY+NotoSerifCJKsc-ExtraLight CID TrueType Identity-H yes yes yes 8 0YEUBDD+NotoSerifCJKsc-ExtraLight CID TrueType Identity-H yes yes yes 11 0BINIWB+NotoSerifCJKsc-ExtraLight CID TrueType Identity-H yes yes yes 14 0三个字重,三个 PDF 字体对象,名字全是 ExtraLight。对象数等于不同字重数,说明每个字重确实各有一份实例,只是名字没有跟着变。lab/ch05/fonts.typ 里用了 400、700、300、900、600 五个字重的汉字,pdffonts 里就有五个 NotoSerifCJKsc-ExtraLight,再加上前面说过那个兜底的 NotoSansCJKjp-Thin。所以 pdffonts 看到 ExtraLight 不代表字重错了,眼睛看渲染图才是准的,看看上面 Light 300、Black 900 三行实际是不同的粗细。
weight 与 variations
Typst 0.15 把可变字体的轴暴露成了 text.variations,是一个字典,键是轴名。我想知道它和 weight 的关系,写了三个只差一行的文件,各自编成 PNG:
#text(weight: 600)[手动指定 wght]// var-b.typ#text(variations: (wght: 600))[手动指定 wght]// var-c.typ#text(weight: 400, variations: (wght: 900))[手动指定 wght](三个文件的开头都是 #set page(width: auto, height: auto, margin: 8pt) 和 #set text(font: "Noto Serif CJK SC", size: 20pt),这里省略。)
$ md5sum var-?.pngf300a241cae78175ce1a0ac8b6d8a88a var-a.pngf300a241cae78175ce1a0ac8b6d8a88a var-b.png348adae211869a8a34c3bc488febd2b2 var-c.pngvar-a 和 var-b 的 PNG 字节完全一致,也就是说 weight: 600 就是 variations: (wght: 600):官方文档说,用可变字体时 Typst 会自动根据 weight 配置 wght,根据 size 配置 opsz,根据 style 配置 ital 或 slnt,根据 stretch 配置 wdth。var-c 里 variations 把 weight: 400 覆盖成了 900,渲染出来是最粗的那档。所以平时直接用 weight,只有你要调 weight 之外的轴(比如某些字体的 slnt、opsz 想手动指定)时才写 variations。
OpenType 特性与数字
字体里除了字形还有大量“特性”(feature),text 给常用的几个单独开了参数,其余走 features。features.typ 这个实验在 /tmp/p5,没有放进仓库:
#set page(width: 12cm, height: auto, margin: 8pt)#set text(font: ("Libertinus Serif", "Noto Serif CJK SC"), size: 12pt)
默认数字:1234567890 \#text(number-type: "old-style")[old-style:1234567890] \#text(number-type: "lining")[lining:1234567890] \#text(slashed-zero: true)[slashed-zero:0O0] \#text(fractions: true)[fractions:1/2 3/4] \#text(features: ("smcp", "c2sc"))[features: Small Caps] \#text(features: (smcp: 1))[dict form: Small Caps] \#smallcaps[smallcaps 函数] #upper[upper 大写] #lower[LOWER 小写]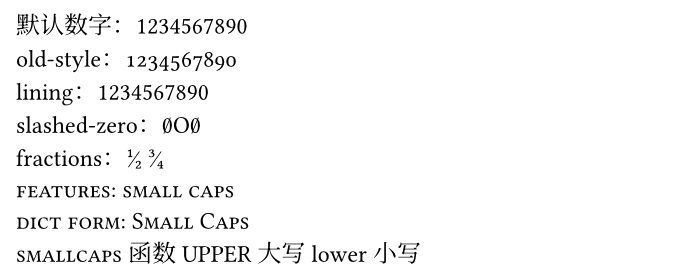
这几个我都在图里看到了效果:
number-type:"old-style"数字像小写字母一样高低错落(适合正文),"lining"一样高(适合表格)。Libertinus 默认就是 lining,所以第一行和第三行看着一样。slashed-zero:0带斜线,和字母O区分。fractions:把1/2排成分数形。features:直接给 OpenType 特性标签,数组形式(("smcp", "c2sc"))开启一组,字典形式((smcp: 1))可以指定特性取值。smcp把小写换成小型大写字母,c2sc把大写也换成小型大写;#text(features: ("smcp",))与#smallcaps[...]是同一个效果的两种写法,后者作为元素函数可以被show smallcaps单独设计。upper、lower、smallcaps:这三个是函数,不是字体特性,upper和lower把文字转成大写和小写。- 汉字不受这些特性影响:图里
函数、大写、小写都没变。
text 还有 ligatures、kerning、number-width、stylistic-set 等参数。我在 12pt 的 Libertinus 上试了开关,渲染图里我看不出肉眼可辨的差别,所以这里不下结论,需要的话去官方文档的 text 页查。
lang 与 region:不只是语言标签
lang 官方文档列的用途是连字符断词规则、智能引号和“其他语言相关的事”。region 呢,只有一句“让文本处理管线做出更明智的选择”。对中文,这个“更明智”体现在字形上。我写了个实验,同一串文字用五种语言设置各排一遍,并用 measure 量宽度:
#set page(width: auto, height: auto, margin: 12pt)#set text(font: ("Libertinus Serif", "Noto Serif CJK SC"), size: 16pt)#let s = [“你好”,直(括号)。门户:「引」]#let w(lang, region) = context measure(text( lang: lang, region: region, s,)).width#grid( columns: 3, gutter: 0.6em, [`en`], text(lang: "en", s), [#w("en", none)], [`zh`], text(lang: "zh", s), [#w("zh", none)], [`zh-cn`], text(lang: "zh", region: "cn", s), [#w("zh", "cn")], [`zh-tw`], text(lang: "zh", region: "tw", s), [#w("zh", "tw")], [`ja`], text(lang: "ja", s), [#w("ja", none)],)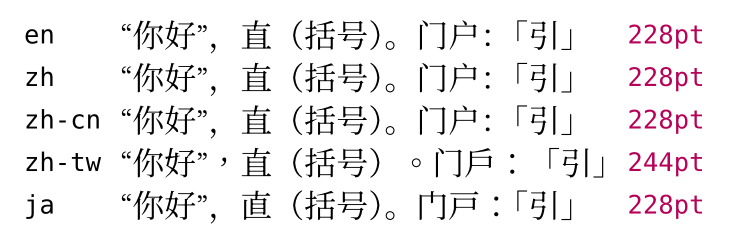
数字:en、zh、zh-cn、ja 的宽度都是 228 pt,zh-tw 是 244 pt,宽了 16 pt。图里 zh-tw 一行的 , 。 : 位置和其他几行明显不同,“户”字在 tw 和 ja 下也写成了另外的字形。官方文档说 lang 和 script 一起决定“字体特性(如字形替换)怎么实现”,我猜这里的区别来自 Noto 字体里按语言区分的字形替换表,但我没有去核对字体内部的特性表,只是观察结果。
这对 xuan 的意义是:简体中文我写 lang: "zh", region: "cn"。图里 zh 一行不写 region 看起来和 zh-cn 一样,所以光看这一串字,region: "cn" 不是必需的;我写它是为了明确选了简体,不依赖字体的默认字形,也能和 tw 区分开。xuan-cjk 对英文文档把 region 设成 none,只给 lang: "zh" 设 "cn"。
顺便说 smartquote。它把输入的直引号 " ' 换成弯引号,换成哪种由 lang 决定,set smartquote(enabled: false) 关掉,set smartquote(quotes: ...) 自定义。直角引号的实验放在下面的装饰一节里一起跑。
cjk-latin-spacing:汉字和字母之间的四分之一
中文排版有个老习惯:汉字和拉丁字母、数字之间留一点空隙。Typst 默认就会加,参数是 text.cjk-latin-spacing,取 auto(默认)或 none。lab/ch05/cjk-latin-spacing.typ(源文件)把两种设置的宽度量出来,直接印进 PDF:
#set page(width: 14cm, height: auto, margin: 1cm)#set text(font: ("Libertinus Serif", "Noto Serif CJK SC"), lang: "zh")
// Typst inserts a quarter-em gap between Chinese and Latin/digits by default.#let sample = [中文Typst排版2026年]
#context { let width(spacing) = { measure( text(cjk-latin-spacing: spacing, size: 12pt, sample), ).width } let on = width(auto) let off = width(none) [ - `auto`:#on.pt() pt - `none`:#off.pt() pt - 差值:#(on - off).pt() pt,共 #((on - off) / (0.25 * 12pt)) 处缝隙 ]}
#text(size: 12pt, cjk-latin-spacing: auto, sample) \#text(size: 12pt, cjk-latin-spacing: none, sample)measure 和 context 第 7 篇才讲,这里只借用:measure 返回内容的实际尺寸。pdftotext 读出来的结果:
• auto:121.776 pt• none:109.776 pt• 差值:12 pt,共 4 处缝隙中文 Typst 排版 2026 年中文 Typst 排版 2026 年样本 中文Typst排版2026年 里汉字和字母之间有 4 处交界:文|T、t|排、版|2、6|年。12 pt 下差值正好 12 pt,每处 3 pt,也就是 0.25em。这就是“默认插入四分之一个字宽”的实测值。
问题来了:我在源文件里手敲空格,会不会和自动空隙叠加?我又写了个实验 space.typ(/tmp/p5),分别量 中文Typst 和 中文 Typst:
#set text( font: ("Libertinus Serif", "Noto Serif CJK SC"), size: 12pt, lang: "zh", region: "cn",)#context { let w(x, spacing) = { measure(text(cjk-latin-spacing: spacing, x)).width.pt() } for s in (auto, none) { let tight = w([中文Typst], s) let spaced = w([中文 Typst], s) [#repr(s):无空格 #tight pt,有空格 #spaced pt \ ] }}auto:无空格 54.456 pt,有空格 54.456 ptnone:无空格 51.456 pt,有空格 54.456 ptauto 下有没有空格宽度一样(54.456 pt),没有叠加;none 下才是纯粹的“一个空格”宽度 3 pt。结论:用 auto 的话,写不写那个空格结果相同,不用在源文件里为排版好看再敲空格。
lab/ch05/fig-cjk.typ 把四种设置并排放,产出 out/figures/ch05-cjk.png:
#set page(width: auto, height: auto, margin: 12pt)#set text(font: ("Libertinus Serif", "Noto Serif CJK SC"), size: 12pt)
#let sample = [中文Typst排版2026年,数字100%。]
#grid( columns: 2, gutter: 1em, row-gutter: 0.8em, align: left + horizon, [`auto`], text(cjk-latin-spacing: auto, sample), [`none`], text(cjk-latin-spacing: none, sample), [`strong`], text(weight: "bold", sample), [`light`], text(weight: 300, sample),)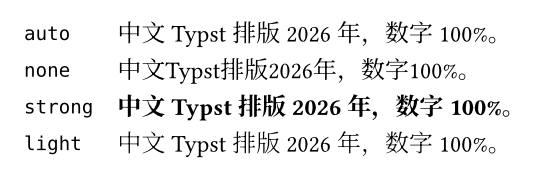
strong 一行说明可变字体的粗体是真粗体:汉字和字母一起变粗(这里的“字母”来自 Libertinus Bold,是另一个字体文件)。light 一行用的是 Noto 的 300 实例,汉字比 auto 行略轻。Libertinus 只有 400、600、700 三档(见上面的 --variants),请求 300 时取最近的一档:我另外把 Abc 用 weight: 300 和 weight: 400 各编成 PNG,两张图字节完全相同,所以字母没变。
文字装饰、引号与换行
这一节把还没出场的 text 周边函数一起过一遍。实验文件是 /tmp/p5/deco.typ:
#set page(width: 12cm, height: auto, margin: 8pt)#set text( font: ("Libertinus Serif", "Noto Serif CJK SC"), size: 12pt, lang: "zh", region: "cn",)
#highlight[高亮]#highlight(fill: yellow.lighten(50%), extent: 2pt)[带扩展的高亮] \#underline[下划线 underline]#underline(offset: 2pt, stroke: 1pt + blue)[偏移的蓝色下划线]#underline(evade: false)[不避让 gjpqy] #underline[避让 gjpqy] \#strike[删除线 strike] #overline[上划线 overline] \H#sub[2]O 与 x#super[2] \#text(baseline: 3pt)[手动基线 baseline] \"smart" 与 'single',英文里 #text(lang: "en")["smart" and 'single'] \#[ #set smartquote(enabled: false) "关闭后" 保持直引号] \#[ #set smartquote(quotes: (double: ("「", "」"), single: ("『", "』"))) "直角引号" 与 'nested'] \第一行 \ 第二行 #linebreak() 第三行 \#lorem(12)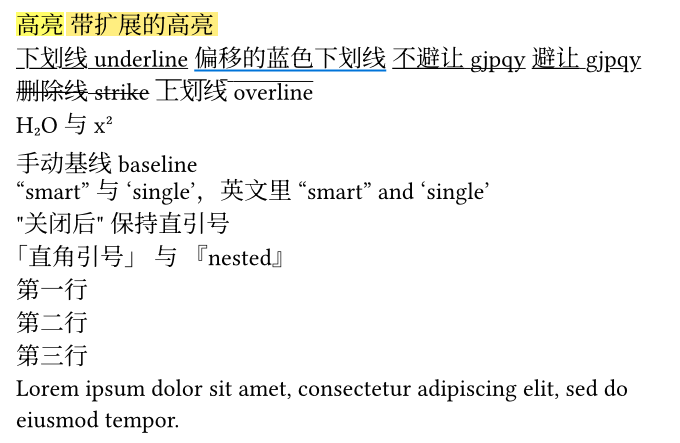
highlight:给内容加背景色,fill改颜色,extent让背景向两侧多伸出一段,图里第二个高亮比第一个宽一圈。underline、strike、overline:下划线、删除线、上划线。offset调离基线的距离,stroke调线型,evade(默认true)让线条在遇到字母下伸部分(g、j、p、q、y)时绕开,图里evade: false的那一条直接穿过了字母。对中文来说汉字没有下伸,evade只在夹杂英文时可见。sub、super:下标和上标,缩小字号并移动基线。这里排版用的是文字,公式里的上下标是第 8 篇的内容。baseline:手动抬升或降低基线,是text的参数。smartquote:"smart" 与 'single'在zh下得到的是“smart” 与 ‘single’,弯引号。set smartquote(enabled: false)保留直引号;set smartquote(quotes: (double: (...), single: (...)))换成别的引号,我换成了直角引号「」『』,中文排版中偶尔需要。linebreak:\是#linebreak()的简写,强制换行,图里“第一行 第二行 第三行”各占一行。lorem(n):生成 n 个词的 lorem ipsum 占位文字。注意它只会生成拉丁文,想要中文占位文字得自己写一段。
upper、lower、smallcaps 在上一节已经出现。第 9 篇会再用到 highlight、underline 等,在表格和引用里。
中文编号:"一" 和 "壹"
第 4 篇的 set heading(numbering: "一、") 用的就是中文数字。numbering 的模式字符串里,1、a、A、i、I 是拉丁系,一 和 壹 是中文系,我对 n = 1, 10, 11, 21, 100, 1234 各跑一遍。实验文件 /tmp/p5/numbering.typ:
#set page(width: 14cm, height: auto, margin: 8pt)#set text( font: ("Libertinus Serif", "Noto Serif CJK SC"), size: 12pt, lang: "zh",)
#for n in (1, 10, 11, 21, 100, 1234) { [#n:#numbering("一", n),#numbering("壹", n) \ ]}#numbering("①", 21),#numbering("①", 50) \
#set heading(numbering: "一、")= 概述== 小节#set heading(numbering: "第一章")= 另起#set heading(numbering: (..n) => "第" + numbering("一", ..n.pos()) + "节")= 函数形式
#set enum(numbering: "(一)")+ 条目+ 条目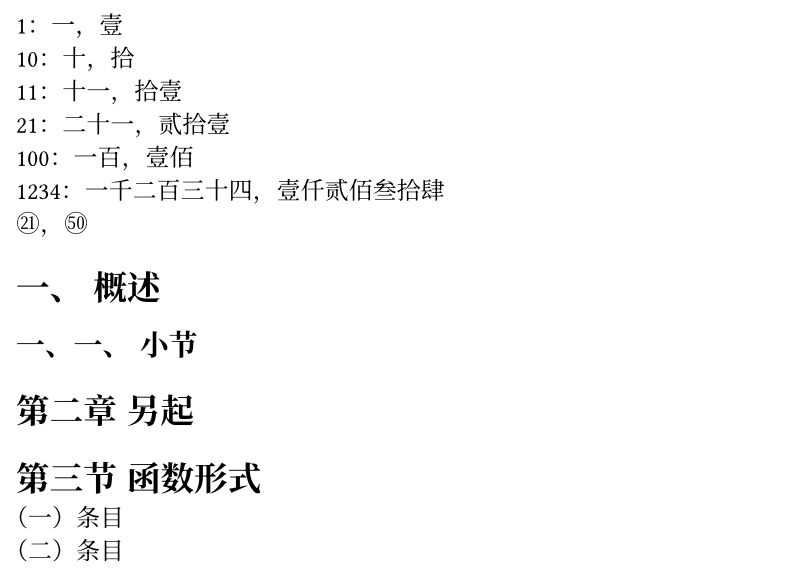
pdftotext 读出来:
1:一,壹10:十,拾11:十一,拾壹21:二十一,贰拾壹100:一百,壹佰1234:一千二百三十四,壹仟贰佰叁拾肆㉑,㊿"一"给小写中文数字,"壹"给大写(财务用),两者都能处理到 1234,都是完整的“十、百、千”读法,没有位数限制的错误。"①"只覆盖 1 到 50,到 100 时我在这个版本里得到的是一条警告the number 100 is too large to be represented with the arabic.o numeral system,附带this will become a hard error in the future,输出退化成阿拉伯数字100。用圈号数字要注意不超过 50。- 标题的
"一、"在二级标题上变成一、一、。我猜是模式只有一个计数符号,第二级的计数器按同一个模式再追加一次,没有去查源码。多级标题要么只给一级设中文,要么用函数形式。 - 把模式换成
"第一章"时,计数器并没有重置:接着上面的概述变成第二章,因为numbering只是改了显示,计数器是标题自己的。 - 函数形式
(..n) => "第" + numbering("一", ..n.pos()) + "节"可以随意拼装,..n.pos()把收到的计数器值展开成numbering的参数。 - 列表同理:
set enum(numbering: "(一)")用的是全角括号,条目内容紧接其后。
段落:par 的几个参数
lab/ch05/par.typ(源文件):
#set page(width: 12cm, height: auto, margin: 1cm)#set text( font: ("Libertinus Serif", "Noto Serif CJK SC"), lang: "zh", size: 11pt,)
// Chinese convention: indent every paragraph by two characters.// `all: true` also indents the first paragraph after a heading.#set par( justify: true, leading: 0.9em, spacing: 1.2em, first-line-indent: (amount: 2em, all: true),)#set heading(numbering: "1.")
= 缩进
排版中文时,每段首行缩进两个汉字宽,行距比西文略大。段落之间不需要额外空行,但这里用 `spacing` 留了一点。
// 0.15: first-line-indent folds, so a later rule can change one key.#set par(first-line-indent: (amount: 0pt))这一段把 amount 改成了 0,`all` 仍然继承自上面的规则。
// Hanging indent for references.#set par(first-line-indent: 0pt, hanging-indent: 2em)[1] Knuth, D. E. _The TeXbook_. Addison-Wesley, 1984. 这条参考文献的第二行会整体悬挂缩进。
// Line breaking: optimized (default) vs simple.#set par(hanging-indent: 0pt, linebreaks: "simple")简单断行直接贪心填满每一行,不做全段落优化,所以右边缘的空白更不均匀一些。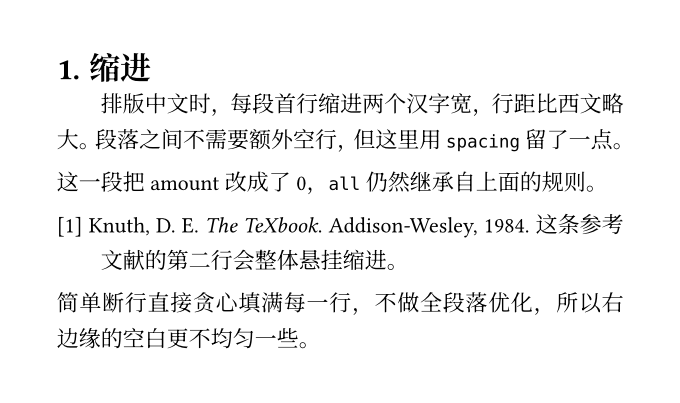
逐个说。
justify、leading、spacing。 justify: true 两端对齐。leading 是行与行之间的距离(不含字体本身的行高),spacing 是段与段之间的距离。我读了这些默认值(#context 里把 par.leading、par.spacing、par.first-line-indent、text.lang 等打印出来):
默认 leading 0.65em,spacing 1.2em,行首缩进 (amount: 0pt, all: false),字号 11pt,lang en,region none,cjk-latin-spacing autoxuan-cjk 把 leading 提到 0.9em。我的感觉是汉字方块占满整个字面,同样的行距看起来比拉丁文更挤,所以多给一点。
first-line-indent 与它的 all。 中文习惯每段缩进两个汉字,即 2em。first-line-indent 接受一个长度,也接受 (amount: ..., all: ...) 的字典。all 默认为 false,意思是只给“紧跟在其他段落后面”的段落缩进,标题后第一段不缩进,这是西文习惯。我用并排实验确认了:
#set par(first-line-indent: 2em)// vs#set par(first-line-indent: (amount: 2em, all: true))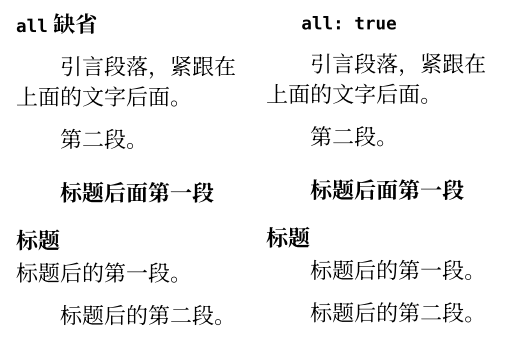
左边(all 缺省)标题“标题”后面的“标题后的第一段。”是顶格的,右边(all: true)也缩进了。中文排版要求每段都缩,所以 xuan-cjk 用 all: true。(这个并排实验是 /tmp/p5/indent-all.typ,每列里就是上面这条 set par 加几段文字。)
折叠(fold)。 第 4 篇讲过 set 规则会折叠,0.15 起 first-line-indent 也折叠,所以 lab 里 #set par(first-line-indent: (amount: 0pt)) 只写了 amount,按 lab 注释的说法 all 仍然继承。图里这一段确实不缩进了,all 继承与否单看这张图分辨不出来。
hanging-indent。 悬挂缩进,是第一行以外的所有行缩进。参考文献和术语表用得到。图里 [1] Knuth... 的第一行顶格,续行缩进了 2em。lab 里先把 first-line-indent 设回 0pt 再设悬挂,免得两个缩进叠在一起。
linebreaks。 "optimized" 是默认的整段最优断行算法,"simple" 是逐行贪心填满。最后一段用的是 "simple"。我没有量化这两种方式的区别,在 12 厘米宽的段落里肉眼几乎看不出来;这个参数对长段落、窄栏、拉丁文混排的差别更大一些。
收进 xuan:fonts.typ 与 cjk.typ
前面所有结论,在 xuan 里就是这两个文件。src/fonts.typ(源文件),13 行,最终版:
// Font stacks. Libertinus, DejaVu and New Computer Modern ship inside the// Typst binary; the Noto CJK families come from the flake (TYPST_FONT_PATHS).// `latin-in-cjk` keeps Libertinus away from CJK punctuation such as “”, so// those fall through to the full-width glyphs of Noto Serif CJK SC.#let fonts = ( serif: ( (name: "Libertinus Serif", covers: "latin-in-cjk"), "Noto Serif CJK SC", ), sans: ("Noto Sans CJK SC",), mono: ("DejaVu Sans Mono", "Noto Sans Mono CJK SC"), math: ("New Computer Modern Math",),)一个字典,四个键,都是字体列表(sans 后面的逗号让它是一个元素的数组,而不是字符串):
serif:正文。Latin 与数字走 Libertinus,汉字走 Noto Serif CJK SC。covers: "latin-in-cjk"让 Libertinus 不碰引号这类中文标点,它们落到 Noto 的全角字形上,前面的实验已经讲过。sans:无衬线,第 13 篇的幻灯片用。mono:代码。同样的思路,DejaVu Sans Mono 排字母符号,Noto Sans Mono CJK SC 补汉字。math:公式字体。第 8 篇会讲,这里只有一项,因为数学字体要有 OpenType math 表,普通字体用不了。
注释里已经把来源写明:Libertinus、DejaVu 和 New Computer Modern 是嵌在 Typst 里的,Noto CJK 来自 flake。所以你要在别的环境用 xuan,必须自己保证 Noto CJK 系列在字体路径里,否则就是前面那个“静默豆腐块”场景。
src/cjk.typ(源文件),21 行,最终版:
#import "fonts.typ": fonts
/// Typography defaults for Chinese (`lang: "zh"`) or English body text.#let xuan-cjk(body, lang: "zh") = { let zh = lang == "zh" set text( font: fonts.serif, lang: lang, region: if zh { "cn" } else { none }, cjk-latin-spacing: auto, ) set par( justify: true, leading: 0.9em, spacing: 1.2em, first-line-indent: if zh { (amount: 2em, all: true) } else { 0pt }, ) show raw: set text(font: fonts.mono) show math.equation: set text(font: fonts.math) body}它的形状就是第 4 篇讲的模板:(body, lang:) 参数,最后返回 body,前面登记一串规则。拆开看:
let zh = lang == "zh":后面三处要分语言,先算一次。set text(...):字体列表、lang、按语言选region(中文"cn",其他none)、cjk-latin-spacing: auto。auto就是默认值,我显式写出来是让读这个文件的人不必去查默认值。set par(...):中文缩进两个字,英文不缩进(0pt)。其余三项两种语言共用:两端对齐,行距 0.9em,段距 1.2em。first-line-indent值是if表达式,分支结果是一个字典或一个长度,两者都合法。show raw: set text(font: fonts.mono):行内和块级的raw都换成等宽栈。这是show ... : set形式,第 4 篇讲过,它不产生嵌套。show math.equation: set text(font: fonts.math):公式用数学字体。这里不用set text(font:),因为那会影响正文,只想让公式变。
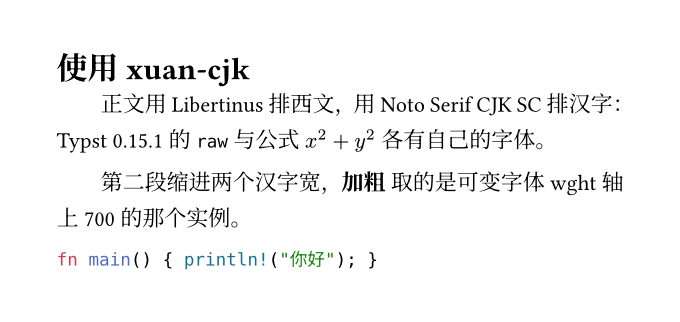
我用这个模板编了一份很小的文档,看它实际用了哪些字体。use.typ(/tmp/p5):
#import "@local/xuan:0.1.0": *
#set page(width: 12cm, height: auto, margin: 1cm)#show: xuan-cjk
= 使用 xuan-cjk
正文用 Libertinus 排西文,用 Noto Serif CJK SC 排汉字:Typst 0.15.1 的 `raw` 与公式 $x^2 + y^2$ 各有自己的字体。
第二段缩进两个汉字宽,*加粗* 取的是可变字体 wght 轴上 700 的那个实例。
```rustfn main() { println!("你好"); }```$ typst compile --root / --ignore-system-fonts use.typ use.pdf$ pdffonts use.pdfname type encoding emb sub uni object ID------------------------------------ ----------------- ---------------- --- --- --- ---------BJAXUM+NotoSerifCJKsc-ExtraLight CID TrueType Identity-H yes yes yes 19 0CXRIIC+LibertinusSerif-Bold-Identity-H CID Type 0C Identity-H yes yes yes 22 0ZLKZTV+NotoSerifCJKsc-ExtraLight CID TrueType Identity-H yes yes yes 25 0PQNDLO+LibertinusSerif-Regular-Identity-H CID Type 0C Identity-H yes yes yes 28 0WWBOFQ+DejaVuSansMono CID TrueType Identity-H yes yes yes 31 0HJDJUN+NewCMMath-Book-Identity-H CID Type 0C Identity-H yes yes yes 34 0GGUNCA+NotoSansMonoCJKsc-Regular CID TrueType Identity-H yes yes yes 37 0(--root / 是因为文件放在 /tmp 下,Typst 要求源文件必须在项目根目录里。)七个字体对象,对得上:两个 NotoSerifCJKsc(常规加标题或加粗两个字重),Libertinus 的 Bold 和 Regular,DejaVu Sans Mono 画代码里的 fn main 等拉丁字符,NewCMMath-Book 画 ,NotoSansMonoCJKsc-Regular 画代码里的“你好”。
跑一遍
$ nix develop --command make ch05./scripts/chapter.sh ch05ok lab/ch05/cjk-latin-spacing.typok lab/ch05/fig-cjk.typok lab/ch05/fonts.typok lab/ch05/missing-glyph.typok lab/ch05/par.typok lab/ch05/unknown-font.warn.typ (warned as expected)六个文件,五个正常输出,一个按预期给出警告。
一个新坑:这一篇的小实验放在 /tmp 下,我一开始给 typst compile 传了 --root ~/Projects/typst-lab,得到 error: source file must be contained in project root,因为源文件必须在根目录之内。改成 --root / 才编过。仓库里的 lab 文件本来就在仓库根下,--root . 就够了。
接下来
字体和段落解决了“字怎么排”,下一步是“字放在哪里”:页面大小、页边距、盒子、网格、浮动。第 6 篇讲 page、block、box、grid、place 和 layout,并把 xuan 的 page.typ 写出来。想先动手的话,lab/ch05/ 里的字体列表还是 A 的写法,可以把它换成 fonts.typ 里 serif 的写法,自己对比引号的变化:lab/ch05。下一篇:页面与布局:盒子、网格与浮动。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!