
 Better Mistakes



音乐
暂未播放
用 Rust 写一个 WebAssembly 插件:按拼音排序术语表
- 1第一份文档:标记语法、编译与 watch
- 2代码模式:值、类型与控制流
- 3函数与 content:一切都是函数调用
- 4set 与 show:样式是规则,不是命令
- 5字体与中文排版
- 6页面与布局:盒子、网格与浮动
- 7context、计数器与状态:Typst 如何“多遍”编译
- 8数学公式
- 9图、表、代码与交叉引用
- 10参考文献:BibTeX、Hayagriva 与 GB/T 7714
- 11数据驱动:用一份 YAML 生成中英文简历
- 12作业模板:模块、多文件与条件编译
- 13幻灯片与绘图
- 14生态:Typst Universe 与第三方包
- 15用 Rust 写一个 WebAssembly 插件:按拼音排序术语表本文
- 16导出、工具链与 CI
笔记末尾想要一张术语表,按拼音排序。Typst 的 array.sorted() 不认拼音,只认码点:把 ("卡尔曼", "奇异值", "矩阵", "最小二乘") 排一下,最小二乘 会跑到 矩阵 前面,因为 最 是 U+6700,矩 是 U+77E9。语言本身没有办法查汉字的读音,所以这一篇我用 Rust 写了一个 29 行的 WebAssembly 插件,让 Typst 通过 plugin 调用它,再把它包成 xuan 的 term 和 glossary。
这一篇结束时你会有这些新文件,都是最终版,文中完整展示:plugin/Cargo.toml、plugin/src/lib.rs、src/glossary.typ;还有 plugin/Cargo.lock(依赖锁,文中只引用)和已经提交进仓库的 packages/local/xuan/0.1.0/plugin/xuan_pinyin.wasm。lib.typ 仍是中间版本:这一篇只多一行 #import "src/glossary.typ": glossary, term。lab/ch15/ 下的 6 个文件(含两个预期失败的)全部通过 make ch15,make plugin 能从源码重建 .wasm。
前置:第 7 篇(context、query 和 metadata,术语表整个建立在它们之上)。Rust 本身不在这一篇讲,需要入门的话看 Rust 入门:第一个 crate。
为什么码点顺序不是拼音顺序
先把问题钉死。lab/ch15/unicode-sort.typ(源文件)把同样四个词用两种方式排序,一起打印出来。它还依赖本篇后面才写的 pinyin-keys,先看结果:
// Codepoint order vs pinyin order for the same four terms.#import "@local/xuan:0.1.0": *#import "../../packages/local/xuan/0.1.0/src/glossary.typ": pinyin-keys#set text(font: fonts.serif, lang: "zh")
#let words = ("卡尔曼", "奇异值", "矩阵", "最小二乘")#let by-codepoint = words.sorted()#let keys = pinyin-keys(words)#let by-pinyin = words.zip(keys).sorted(key: p => p.at(1)).map(p => p.at(0))
#table( columns: 2, [codepoint], [pinyin], ..by-codepoint.zip(by-pinyin).flatten(),)
#repr(by-codepoint) \#repr(by-pinyin) \#repr(keys)
#assert.eq(by-codepoint, ("卡尔曼", "奇异值", "最小二乘", "矩阵"))#assert.eq(by-pinyin, ("矩阵", "卡尔曼", "奇异值", "最小二乘"))pdftotext -layout out/ch15/unicode-sort.pdf - 的输出:
codepoint pinyin卡尔曼 矩阵奇异值 卡尔曼最小二乘 奇异值矩阵 最小二乘
("卡尔曼", "奇异值", "最小二乘", "矩阵")("矩阵", "卡尔曼", "奇异值", "最小二乘")( "ka er man ", "qi yi zhi ", "ju zhen ", "zui xiao er cheng ",)码点顺序是 卡 < 奇 < 最 < 矩,拼音顺序是 ju < ka < qi < zui。四个词在两种顺序里的位置全部不同:矩阵 从最后一名变成第一名,另外三个各后移一位。CJK 统一表意文字区大致按部首和笔画排列,和读音没有关系,所以只要排序用的是字符串比较,这个问题就不可能靠调参数解决。最后两个 assert.eq 把这个事实固定下来:文件能编译,说明两种顺序就是上面印出来的样子。
排序键是第三个 repr 打印的东西:矩阵 变成 "ju zhen ",每个汉字换成无声调拼音再加一个空格。自己在 Typst 里维护这张字音表太费事(常用字就有几千个),而 Rust 的 pinyin crate 已经带着数据表。缺的只是把它接进 Typst 的办法。
插件协议:字节进,字节出
办法是 WebAssembly。plugin("x.wasm") 加载一个 .wasm 文件,返回一个 module,模块里每个导出函数变成一个 Typst 函数。把它想成一台只有一个投币口和一个出货口的自动售货机:你从投币口放进去几段字节,它从出货口吐出一段字节,机器内部怎么运转你看不见,机器也看不到外面的任何东西。
协议在 plugin 的文档里有完整规定,我把和这个项目有关的几条挑出来:
- 导出函数接受
n个 32 位整数(每个参数的长度),返回一个 32 位整数。 - 函数先分配一块长度为各参数长度之和的缓冲区,调用宿主函数
wasm_minimal_protocol_write_args_to_buffer(ptr),宿主把所有参数依次写进去。 - 干完活之后,调用宿主函数
wasm_minimal_protocol_send_result_to_host(ptr, len)把结果交回去。 - 返回
0表示成功;返回1表示失败,此时缓冲区里的内容被当作 UTF-8 错误信息。 - 模块只允许从
typst_env导入上面那两个函数。没有文件、没有网络、没有打印:文档说插件“在隔离中运行”。
我没打算只信文档,写完之后用 Bun 的 WebAssembly.Module.imports 和 .exports 读了一遍编译出来的 .wasm:
imports: typst_env.wasm_minimal_protocol_write_args_to_buffer (i32) -> () typst_env.wasm_minimal_protocol_send_result_to_host (i32, i32) -> ()exports: memory (20 页) pinyin_keys (i32) -> i32(这个检查脚本放在 /tmp/p15-wasm.js,不在仓库里;原始输出是 JSON,我整理成了上面的样子。)导入恰好两个,导出一个函数加一块内存。pinyin_keys 接受一个 i32(唯一一个参数的长度),返回一个 i32(状态码)。这和协议对得上。
这也解释了为什么 Rust 要选 wasm32-unknown-unknown 目标:unknown-unknown 表示没有操作系统也没有 WASI,生成的模块天然不依赖 fd_write 之类的系统调用。很多编译器默认走 WASI,那样产出的模块里有 Typst 不提供的导入,要先用 wasi-stub 处理;这个项目不需要。
手写协议要自己管内存分配和两次宿主调用,很容易写错。wasm-minimal-protocol crate 用一个属性宏把这些都包掉了:#[wasm_func] 标注的函数只需要接受 &[u8] 参数,返回 Vec<u8> 或 Result<Vec<u8>, E>(E 实现 Display 即可)。我读了它在本机 cargo 缓存里的宏源码确认展开结果:Ok 对应状态码 0,Err(e) 把 e.to_string() 作为消息送回宿主并返回 1。
写 Rust 端
plugin/Cargo.toml(源文件):
[package]name = "xuan-pinyin"version = "0.1.0"edition = "2024"license = "MIT OR Apache-2.0"description = "Typst plugin: pinyin sort keys for Chinese glossary terms"
[lib]crate-type = ["cdylib"]
[dependencies]pinyin = { version = "0.11.0", default-features = false, features = ["plain"] }wasm-minimal-protocol = "0.2.1"
[profile.release]opt-level = "s"lto = truestrip = true三处是有意为之的。crate-type = ["cdylib"] 让 rustc 产出一个没有 Rust 元数据的 C 风格动态库,在 wasm 目标上就是一个可被宿主加载的 .wasm;默认的 rlib 是给别的 Rust 代码链接用的,Typst 用不了。default-features = false, features = ["plain"] 只打开无声调拼音:pinyin 的默认特性还包括声调、数字声调、多音字等几套数据(Cargo.toml 的 [features] 里列着)。我在 /tmp/p15/full 里把这一行改回 pinyin = "0.11.0"(不在仓库里),同样的 profile 下编出来是 495471 字节,是现在 235242 字节的 2.1 倍。opt-level = "s"、lto、strip 是针对体积的常规设置:我猜体积小对编译速度也有一点帮助,但我没有量过,选它们主要是为了仓库里提交的二进制别太大。
plugin/src/lib.rs(源文件),完整的 29 行:
use pinyin::ToPinyin;use wasm_minimal_protocol::*;
initiate_protocol!();
/// Input: UTF-8 lines. Output: one sort key per line./// Han characters become toneless pinyin followed by a space,/// every other character is lowercased as-is.#[wasm_func]pub fn pinyin_keys(input: &[u8]) -> Result<Vec<u8>, String> { let text = std::str::from_utf8(input) .map_err(|_| "xuan-pinyin: input is not valid UTF-8".to_string())?; let keys: Vec<String> = text.split('\n').map(line_key).collect(); Ok(keys.join("\n").into_bytes())}
fn line_key(line: &str) -> String { let mut key = String::new(); for ch in line.chars() { match ch.to_pinyin() { Some(p) => { key.push_str(p.plain()); key.push(' '); } None => key.extend(ch.to_lowercase()), } } key}几个设计选择值得说清楚。
一次调用处理所有词。 输入是“用换行分隔的多行 UTF-8”,输出是同样行数的键。每次 plugin 函数调用都要过一遍参数序列化,而且是一次宿主到客体的边界穿越;术语表通常几十条,一次打包比循环调用便宜,Typst 端也只产生一条缓存记录。代价是词里不能含换行:pinyin-keys 把词用 \n 拼起来再按 \n 拆开,含换行的词会让键的行数和词的数量对不上。术语不会含换行,所以我没有做防护。
每个汉字后面补一个空格。 为什么不直接拼成 juzhen?因为拼音音节边界会产生歧义。我在 /tmp/p15/poly.typ 里用真实插件算了 ("先", "西安", "西") 的键:
"xian ""xi an ""xi "有空格的时候 西 < 西安 < 先,这是字典里的顺序;没有空格 西安 和 先 的键都是 xian,会并列,由排序的稳定性(输入顺序)决定谁在前。空格比任何字母小,所以它把“音节结束”这个信息编进了字符串比较里。
非汉字原样小写保留。 ch.to_pinyin() 对非汉字返回 None,走 ch.to_lowercase() 分支,Abc矩阵 的键是 abcju zhen (注意 abc 和 ju 之间没有空格:拉丁字母不加分隔,只有汉字加)。tests/glossary.typ 里有一条断言固定了这个行为。
错误是值,不是 panic。 from_utf8 失败就返回 Err(String),宏把它翻译成状态码 1 加消息,Typst 端于是能原样显示这句话(后面有真实输出)。这个函数里唯一会失败的地方就是输入不是 UTF-8,所以我只需要处理这一条路径。
局限:多音字只取第一个读音。 这个 crate 的 to_pinyin 对每个字只给一个读音。同样在 poly.typ 里我算了 银行,键是 "yin xing ",而在这个词里 行 读 háng。对于术语表,这种错误只影响极少数词的相对位置;如果要处理,应该用 heteronym 特性加上词库,那是另一个项目了。
构建、格式和 lint
仓库的 Makefile 里有一条 plugin 目标:
plugin: cd plugin && cargo build --release --target wasm32-unknown-unknown && cp target/wasm32-unknown-unknown/release/xuan_pinyin.wasm ../packages/local/xuan/0.1.0/plugin/流程是在 nix develop(Rust 1.97.1,它自带 wasm32-unknown-unknown 的标准库,构建不需要 rustup target add,也没有用到 wasm-ld 或 wasi-stub)里:
$ make plugincd plugin && cargo build --release --target wasm32-unknown-unknown && cp target/wasm32-unknown-unknown/release/xuan_pinyin.wasm ../packages/local/xuan/0.1.0/plugin/ Finished `release` profile [optimized] target(s) in 0.23s$ stat -c %s packages/local/xuan/0.1.0/plugin/xuan_pinyin.wasm235242这是一次增量构建,target/ 已经在了所以只花 0.23 秒。冷构建我在另一个目录里量:CARGO_TARGET_DIR=/tmp/p15-target cargo build --release --target wasm32-unknown-unknown(依赖已经在 cargo 缓存里,不含下载时间):
Compiling proc-macro2 v1.0.107 Compiling quote v1.0.47 Compiling unicode-ident v1.0.27 Compiling pinyin v0.11.0 Compiling venial v0.5.0 Compiling wasm-minimal-protocol v0.2.1 Compiling xuan-pinyin v0.1.0 (/home/bfmhno3/Projects/typst-lab/plugin) Finished `release` profile [optimized] target(s) in 3.74s冷构建 3.74 秒,产物 235242 字节,而且 cmp 把它和仓库里提交的那份比较,输出 same:wasm32-unknown-unknown 的构建在这台机器上是逐字节可复现的。这个事实有实际意义,因为 CI 的 build 任务不重新编译插件,直接用提交进仓库的 .wasm(这样 Typst 的测试不依赖 Rust 工具链),所以我需要知道它没有和源码脱节。235242 字节里大头是拼音表:我另外用一个只有协议、没有 pinyin 依赖的计数器 crate(后文会用到)编了一份,是 15377 字节,相差约 219 KB。
CI 的 plugin 任务只跑格式和 lint,我原样跑一遍(命令和 .github/workflows/ci.yml 里一致):
$ cd plugin && cargo fmt --check && cargo clippy --release --target wasm32-unknown-unknown -- -D warningscargo fmt --check 无输出(我的命令里加了 && echo fmt-ok 确认退出码为 0),clippy 输出 Finished 一行,没有任何警告。-D warnings 把警告升级成错误,所以 CI 绿了就意味着一条警告都没有。
在 Typst 里调用它
先手动调用一次,不经过任何包装。lab/ch15/plugin-basics.typ(源文件):
// Calling the plugin by hand: bytes in, bytes out.#let p = plugin("../../packages/local/xuan/0.1.0/plugin/xuan_pinyin.wasm")
#let out = p.pinyin_keys(bytes("矩阵\nABC"))#type(out), #out.len() bytes: #repr(str(out))
// Same input, same output: plugins are pure functions.#assert.eq(out, p.pinyin_keys(bytes("矩阵\nABC")))
// Errors come back as Typst errors, which `assert` cannot catch,// so we only show the valid path here. See bad-bytes.fail.typ.输出:
bytes, 12 bytes: "ju zhen \nabc"三个点:返回值的类型是 bytes,要用 str() 才能当字符串用;"ju zhen \nabc" 是 8 + 1 + 3 = 12 字节;bytes(...) 和 str(...) 就是 Typst 一侧的全部“序列化”。
调用约定是严格的。我在 /tmp/p15/ 里试了几种错误用法(都不在仓库里),都是 typst compile --root /tmp/p15 <file>:
#let p = plugin("counter.wasm")#p.echo("矩阵")error: expected bytes, found string ┌─ nostr.typ:2:8 │2 │ #p.echo("矩阵") │ ^^^^^^参数必须是 bytes,不会自动转换。其余三种:
error: module does not contain `nothing` ┌─ nofn.typ:2:3 │2 │ #p.nothing(bytes("x")) │ ^^^^^^^
error: file not found (searched at /tmp/p15/missing.wasm) ┌─ nofile.typ:1:16 │1 │ #let p = plugin("missing.wasm") │ ^^^^^^^^^^^^^^第三种是把一个 .typ 文件当 .wasm 加载(plugin("counter.typ")),错误开头是 error: failed to load WebAssembly module (magic header not detected: bad magic number ...,后面跟着期望的 0x0 0x61 0x73 0x6d(即 \0asm)和实际读到的 0x23 0x6c 0x65 0x74(即 #let,源文件的前四个字节)。
这些都是编译期的使用错误。插件函数自己报错是另一回事,lab/ch15/bad-bytes.fail.typ(源文件)故意把两个不可能出现在 UTF-8 里的字节 255, 254 送进去:
// Invalid UTF-8 makes the plugin return Err, which aborts compilation.#let p = plugin("../../packages/local/xuan/0.1.0/plugin/xuan_pinyin.wasm")#p.pinyin_keys(bytes((255, 254)))out/ch15/bad-bytes.stderr:
error: plugin errored with: xuan-pinyin: input is not valid UTF-8 ┌─ lab/ch15/bad-bytes.fail.typ:3:1 │3 │ #p.pinyin_keys(bytes((255, 254))) │ ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^Rust 里写的那句 "xuan-pinyin: input is not valid UTF-8" 原样出现在 Typst 的错误信息里,前面只加了 plugin errored with: 。这就是状态码 1 加错误消息的完整往返。这个错误是编译错误,不是值:assert 抓不住它,没有 try 之类的东西,所以 plugin-basics.typ 末尾的注释说只展示成功路径。(在插件包里把错误消息写成 包名: 原因 的形式,用户读到 Typst 的输出时才知道该找谁。)
纯函数:Typst 会缓存同参数的调用
文档在 Purity 一节写得很直接:插件函数必须是纯函数,同样的参数必须总是返回同样的值,调用不能对后续调用产生可观察的副作用。原因是 Typst 函数本身是纯的,插件调用继承了这个要求。具体来说,同一个参数调用两次,Typst 可能缓存结果,只真正调用一次;Typst 还可能在多个线程里运行插件的多个实例,实例之间不共享状态。Typst 不检查你是否真的纯(为了效率),违反的后果文档称为不可预测、不可复现。
我不太喜欢只靠文档的措辞,所以写了一个故意不纯的插件来看它到底怎么不可预测。/tmp/p15/counter/src/lib.rs(不在仓库里,cargo fmt --check 通过):
use std::sync::atomic::{AtomicU32, Ordering};use wasm_minimal_protocol::*;
initiate_protocol!();
static CALLS: AtomicU32 = AtomicU32::new(0);
#[wasm_func]pub fn bump(_input: &[u8]) -> Vec<u8> { let n = CALLS.fetch_add(1, Ordering::Relaxed) + 1; n.to_string().into_bytes()}
#[wasm_func]pub fn echo(input: &[u8]) -> Vec<u8> { input.to_vec()}bump 每次调用把一个全局计数加一并返回。如果每次调用都真的执行,输入 a, b, a, a 应该得到 1 2 3 4。/tmp/p15/counter.typ:
#let p = plugin("counter.wasm")#for w in ("a", "b", "a", "a") [ #str(p.bump(bytes(w))) #h(1em)]\#str(p.echo(bytes("矩阵")))pdftotext -layout 的输出:
1 2 1 1矩阵是 1 2 1 1。第一个 a 真的执行了,得 1;b 得 2;后面两个 a 的参数和第一次完全相同,Typst 直接返回缓存的 1,计数器没有被碰过。同一份源码,插入或删除一个调用,后面所有数字都会变,这就是“不可复现”。第二个小实验换成 range(3) 循环,每轮先调 bump(bytes("a")) 再调 bump(bytes(str(i))),输出 12 13 14:a 永远是 1,而每个新参数让计数器前进一步,也印证了缓存的键是“函数加参数字节”。
如果插件确实需要状态(比如昂贵的初始化),官方提供 plugin.transition(func, ..args):执行一次调用,返回一个新 module,新 module 里的函数能看到这次调用的副作用,原 module 不受影响。/tmp/p15/trans.typ:
#let p = plugin("counter.wasm")#let q = plugin.transition(p.bump, bytes("x"))#str(p.bump(bytes("a"))) #str(q.bump(bytes("a"))) #str(q.bump(bytes("b")))输出 123:p 是原模块,计数器从零开始,p.bump("a") 得 1;q 在 transition 里已经吃掉了一次调用,所以 q.bump("a") 得 2,q.bump("b") 得 3。两个模块各有各的状态。官方文档特别注明:由于内部 WebAssembly 实现的限制,transition 只保证反映插件内存的变化,不保证反映 WebAssembly 全局变量的变化。这个计数器能工作,是因为 Rust 的 static 放在线性内存里,不是 wasm 全局变量(这是我对编译结果的推断,没有反汇编确认;实验结果与之相符)。我在 xuan 里没有用 transition:拼音转换天然是纯函数。
对 pinyin_keys 来说,纯函数意味着:它没有全局状态,输出只取决于输入字节,所以缓存对它只有好处。
xuan 的 glossary.typ
插件有了,包装它才是 xuan 的工作。src/glossary.typ(源文件)完整的 47 行:
// Glossary sorted by pinyin, using the Rust plugin in ../plugin.#import "util.typ": pick
#let pinyin = plugin("../plugin/xuan_pinyin.wasm")
/// Sort keys for a list of strings, computed by the WebAssembly plugin.#let pinyin-keys(words) = { str(pinyin.pinyin_keys(bytes(words.join("\n")))).split("\n")}
/// Look up the entries registered by `glossary(...)` anywhere in the document.#let entries-of(key) = { let found = query(<xuan-entries>) if found.len() == 0 { panic("xuan: term(" + repr(key) + ") needs a glossary(...) call") } let entries = found.first().value if key not in entries { panic("xuan: unknown glossary key: " + key) } entries}
/// Print the term and record its use for the glossary.#let term(key) = context { let entries = entries-of(key) [#entries.at(key).term#metadata(key)<xuan-term>]}
/// List the terms used so far, ordered by pinyin.#let glossary(entries, title: auto) = { [#metadata(entries) <xuan-entries>] context { let used = query(<xuan-term>).map(m => m.value).dedup() let words = used.map(k => entries.at(k).term) let keys = if words.len() == 0 { () } else { pinyin-keys(words) } let rows = used.zip(keys).sorted(key: pair => pair.at(1)) let heading-text = pick(title, if text.lang == "zh" { "术语表" } else { "Glossary" }) heading(heading-text) for (k, _) in rows { let e = entries.at(k) terms.item(strong(e.term), e.desc) } }}从上往下读,每个选择都有原因。
插件路径相对于这个文件。 plugin("../plugin/xuan_pinyin.wasm") 里的路径和 import 一样是相对于当前源文件解析的(第 12 篇讲过),所以不管用户从哪里 import "@local/xuan:0.1.0",路径都指向包目录里的 plugin/。.wasm 因此必须随包一起发布:这就是它被提交进 packages/local/xuan/0.1.0/plugin/ 的原因。
pinyin-keys 是对插件的一层薄封装。 它做三件事:拼接、调用、拆分。bytes 和 str 的转换只出现在这一处,包的其余部分只和字符串数组打交道。把它单独导出(lab 和 tests 都直接从 src/glossary.typ 导入它)也方便测试。
term 需要知道词的写法,但调用点在 glossary(...) 之前。 用户这样写文章:先在正文里 #term("lsq"),最后才 #glossary(yaml("glossary.yaml"))。term 只拿到一个键,要渲染出“最小二乘”,必须在这一刻读到词典。解法是 glossary() 开头把整个字典用 [#metadata(entries) <xuan-entries>] 挂在文档里,term 再用 query(<xuan-entries>)(这就是第 7 篇讲的内省)把它查回来。这也是 term 的整个函数体包在 context 里的原因:query 只能在 context 里调用。
两种错误都变成可读的 panic。 键不存在是用户最容易犯的错,所以 entries-of 先检查词典是否存在、再检查键是否在词典里,两处各给一条指名道姓的消息。lab/ch15/bad-key.fail.typ(源文件):
// An unknown key is a hard error with a readable message.#import "@local/xuan:0.1.0": *
#glossary((a: (term: "矩阵", desc: "数表")))
#term("matrix")out/ch15/bad-key.stderr:
error: panicked with: xuan: unknown glossary key: matrix ┌─ @local/xuan:0.1.0/src/glossary.typ:19:4 │19 │ panic("xuan: unknown glossary key: " + key) │ ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
while calling `entries-of` at @local/xuan:0.1.0/src/glossary.typ:26:16 entries-of(key)另一种是根本没写 glossary(...)。我在 /tmp/p15/nogloss.typ 里只放了一行 #term("a"):
error: panicked with: xuan: term("a") needs a glossary(...) call ┌─ @local/xuan:0.1.0/src/glossary.typ:15:4 │15 │ panic("xuan: term(" + repr(key) + ") needs a glossary(...) call") │ ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^没有这个检查的话,第二种情况会掉进 found.first(),得到一个“数组为空”的错误,和用户写的东西毫无关系。
glossary 只列用到过的词,并且去重。 query(<xuan-term>) 按文档顺序返回所有用过的 term 标记,.map(m => m.value).dedup() 取出键并保持首次出现的顺序。lab/ch15/glossary.typ 里 lsq 用了两次,unused 一次也没用,表里只出现一次 lsq,没有 unused。
排序是 zip 加 sorted(key:)。 keys 和 used 等长,used.zip(keys) 得到 (键, 拼音键) 对,sorted(key: pair => pair.at(1)) 按拼音键排。这里不能直接排 used(键是英文标识符),也不能排词(那就是码点顺序),必须把“排序依据”和“要排的东西”绑在一起。words.len() == 0 时跳过插件调用:没有用到任何词,就没有必要往边界那头送一个空缓冲区。
标题用 text.lang 选语言。 heading-text 通过 pick(第 3 篇的 util.typ)处理 title: auto,在 context 里读 text.lang,中文文档是“术语表”,其他语言是 Glossary。显式传 title: 则覆盖。
lab/ch15/glossary.typ(源文件)里有 5 个词条,正文用了其中 3 个(lsq 两次):
// term() marks a use; glossary() lists the used terms in pinyin order.#import "@local/xuan:0.1.0": *#set text(font: fonts.serif, lang: "zh")
#let entries = ( svd: (term: "奇异值分解", desc: [把矩阵写成 $U Sigma V^T$。]), lsq: (term: "最小二乘", desc: "使残差范数最小的拟合。"), rank: (term: "秩", desc: "列空间的维数。"), kalman: (term: "卡尔曼滤波", desc: "递推的线性最优估计。"), unused: (term: "伪逆", desc: "这一条没有被引用,不会出现。"),)
正文先提到 #term("lsq"),再提到 #term("svd") 和 #term("rank"),最后又提到 #term("lsq"),去重后只列一次。
#glossary(entries)pdftotext -layout out/ch15/glossary.pdf -:
正文先提到 最小二乘,再提到 奇异值分解 和 秩, 最后又提到 最小二乘,去重后只列一次。
术语表奇异值分解 把矩阵写成 𝑈 Σ𝑉 𝑇 。秩 列空间的维数。最小二乘 使残差范数最小的拟合。顺序 qi、zhi、zui。desc 可以是字符串也可以是 content,奇异值分解 的说明里有公式,也正常渲染。
lab/ch15/fig-glossary.typ 用四个词渲染了一张图,这次四个词全部用到了:
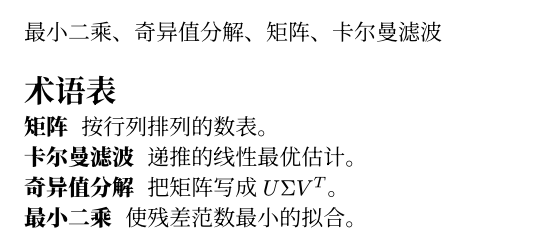
正文里 最小二乘 排在第一,术语表里它排在最后;矩阵 正文第三,表里第一。
在笔记里用
examples/notes/glossary.yaml 有 8 个词条,yaml 的结构正好是 glossary(entries) 要的字典:键到 term 和 desc。examples/notes/main.typ 在正文里用了 5 个:
#term("lsq")问题的本质是#term("proj"),#term("svd") 把投影、#term("rank")与#term("cond")放进同一个分解。进一步阅读可参考国内教材 @tongji2014 中关于正交化与二次型的章节。
#glossary(yaml("glossary.yaml"))这是 main.typ 末尾的一段,不是整个文件。make examples 之后用 pdftotext -layout out/examples/notes.pdf - 看,术语表这一节(笔记共 4 页)依次是:
奇异值分解 把任意矩阵写成正交阵、对角阵、正交阵的乘积,对角元是奇异值。条件数 最大与最小非零奇异值之比,衡量解对扰动的敏感程度。正交投影 把向量映到子空间上最近的点,残差与子空间正交。秩 列空间的维数,也等于非零奇异值的个数。最小二乘 使残差平方和最小的近似解法,几何上是向列空间做正交投影。(第一条在第 3 页末尾,其余四条被分页挤到第 4 页,我只摘了条目,没有抄页脚。)拼音顺序是 qi、tiao、zheng、zhi、zui。同样五个词按码点排序(我在 /tmp/p15/cp.typ 里直接 .sorted() 打印了一下)是:奇异值分解、最小二乘、条件数、正交投影、秩。变化最大的是 最小二乘:码点顺序排第二,拼音顺序排最后。秩 从第五变成第四,条件数 和 正交投影 各提前一位。五个词里只有 奇异值分解 在两种顺序里都排第一,其余四个全部换了位置。
加到 lib.typ
packages/local/xuan/0.1.0/lib.typ 增加这一篇的一行:
#import "src/glossary.typ": glossary, termlib.typ 仍是中间版本,这一篇只多了上面那一行。验证用 make ch15:
ok lab/ch15/bad-bytes.fail.typ (failed as expected)ok lab/ch15/bad-key.fail.typ (failed as expected)ok lab/ch15/fig-glossary.typok lab/ch15/glossary.typok lab/ch15/plugin-basics.typok lab/ch15/unicode-sort.typ整个 make ch15 在 0.44 秒内跑完(time make ch15,6 个文件,包括两个预期失败的)。插件的 235242 字节不是瓶颈。
什么时候该写插件
我这个插件做的事情,用一张手写的静态映射表也能做,只不过要自己维护数据。我觉得值得写插件的场景是:算法有成熟的库(排序、哈希、压缩、解析),而 Typst 语言本身又不是为这类计算设计的。反过来,只是想“多一点逻辑”的时候,Typst 自己的函数通常够用,而且不需要提交一个 235 KB 的二进制进仓库。
有两条边界要记住。第一,插件不能读文件、不能联网,输入全靠 Typst 端以字节传进去,所以如果要处理一个数据文件,先在 Typst 里 read(..., encoding: none) 把字节取出来(第 11 篇讲过)再交给插件。第二,.wasm 是二进制,评审者无法审阅它,所以我把 Rust 源码和 Cargo.lock 一并提交,CI 里跑 fmt 与 clippy,并且验证过它可以逐字节复现。
下一篇是最后一篇:怎么把这一切变成可以交付的东西,包括 PDF 标准、HTML 导出、typst eval、--timings、tests、CI 和模板,最后用一张“Typst 特性 → 第几篇”的索引表把整个系列对一遍。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!