
 Better Mistakes



音乐
暂未播放
作业模板:模块、多文件与条件编译
- 1第一份文档:标记语法、编译与 watch
- 2代码模式:值、类型与控制流
- 3函数与 content:一切都是函数调用
- 4set 与 show:样式是规则,不是命令
- 5字体与中文排版
- 6页面与布局:盒子、网格与浮动
- 7context、计数器与状态:Typst 如何“多遍”编译
- 8数学公式
- 9图、表、代码与交叉引用
- 10参考文献:BibTeX、Hayagriva 与 GB/T 7714
- 11数据驱动:用一份 YAML 生成中英文简历
- 12作业模板:模块、多文件与条件编译本文
- 13幻灯片与绘图
- 14生态:Typst Universe 与第三方包
- 15用 Rust 写一个 WebAssembly 插件:按拼音排序术语表
- 16导出、工具链与 CI
作业是一种很特别的文档:同一份源文件要交出两个版本,学生拿到的只有题目,助教拿到的带解答;题目的分值加起来要等于总分,而总分没人愿意手算。这一篇我要做的,是让这些约束都变成编译器的事:四道题各放一个文件,用 include 拼起来,总分从题目自己带的分值里算出来,解答用一个命令行参数开关。顺着这条线,我把 Typst 的模块系统(import、include、路径、0.15 新增的 path 类型、循环导入)一次跑完。
这一篇结束时你会有:src/homework.typ(最终版,88 行,全文都在下面)、examples/homework/ 下的 main.typ 与 problems/p1.typ 到 p4.typ,以及 lab/ch12/ 下的 4 个入口(modules/main.typ、cycle/main.fail.typ、path-type/main.typ、fig-homework.typ)。lib.typ 是中间版本,这一章只往里加了一行 #import "src/homework.typ": homework, problem, solution。make ch12 全部通过;make examples 会产出 out/examples/homework.pdf 和 out/examples/homework-questions.pdf。
前置:第 11 篇(数据驱动的简历)。这一篇用到第 3 篇的函数与 ..args、第 4 篇的 show: f.with(...) 模板形状,以及第 7 篇的 context、state、query 和 metadata,第 7 篇是读懂“总分怎么算出来”的前提。
一份源码,两个 PDF
先看产物。同一份 examples/homework/main.typ,编译两次,只差一个参数(命令就是 make examples 里的两行,我在仓库的 nix develop 里跑的):
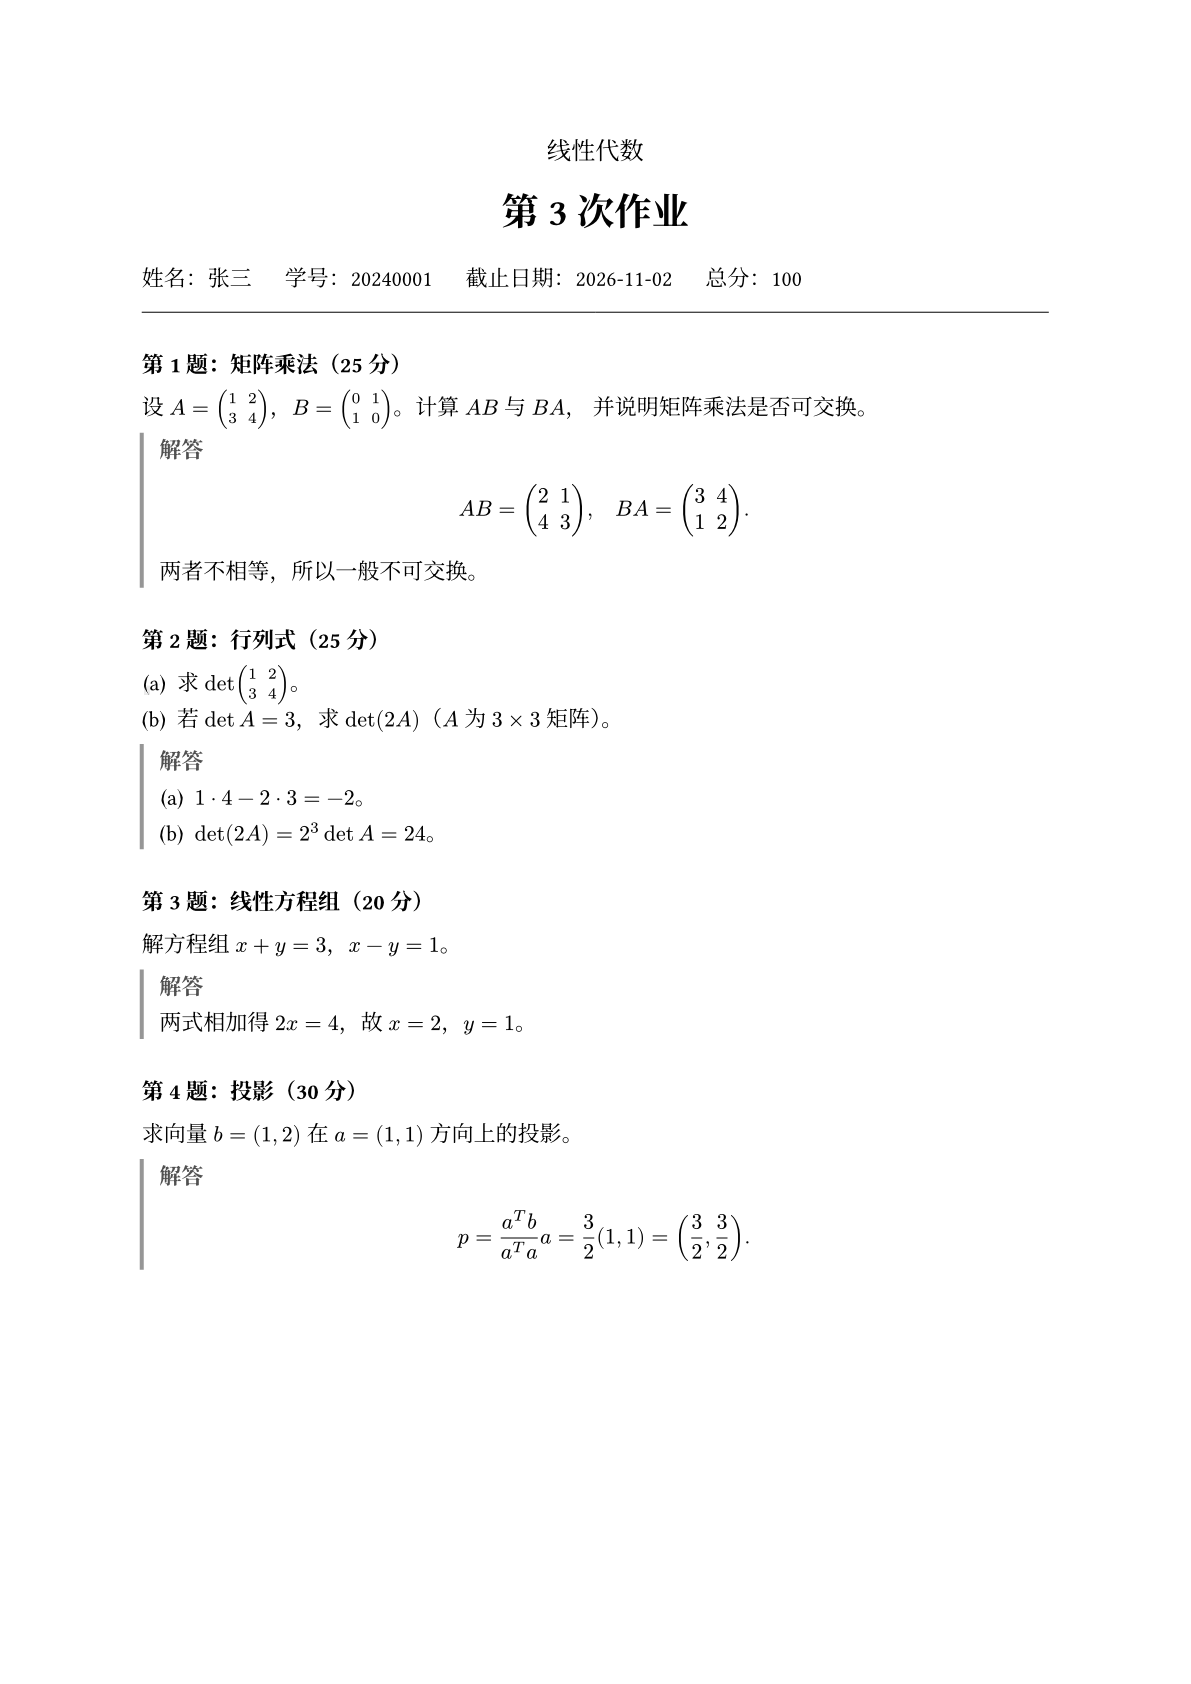
$ typst compile --root . --ignore-system-fonts examples/homework/main.typ out/examples/homework.pdf$ typst compile --root . --ignore-system-fonts --input solutions=false examples/homework/main.typ out/examples/homework-questions.pdf$ pdfinfo out/examples/homework.pdf | grep PagesPages: 1$ pdfinfo out/examples/homework-questions.pdf | grep PagesPages: 1$ pdftotext out/examples/homework.pdf - | grep -c 解答4$ pdftotext out/examples/homework-questions.pdf - | grep -c 解答0$ pdftotext out/examples/homework.pdf - | grep 总分总分:100$ pdftotext out/examples/homework-questions.pdf - | grep 总分总分:100两份都是 1 页;“解答”二字在带解答的版本里出现在 4 行(每题一次),在题目版里是 0 行;总分两份都是 100,也就是 25 + 25 + 20 + 30。后面这一点值得停一下:题目版里解答一个字都没有,总分却没有变,说明总分不依赖“解答显示与否”这个开关,它只依赖题目本身。
带解答的版本:
题目版(--input solutions=false,渲染命令是同一条加上 --pages 1 --format png --ppi 144,图片是 /tmp 里生成后复制进博客的,不是仓库里的 out/figures):
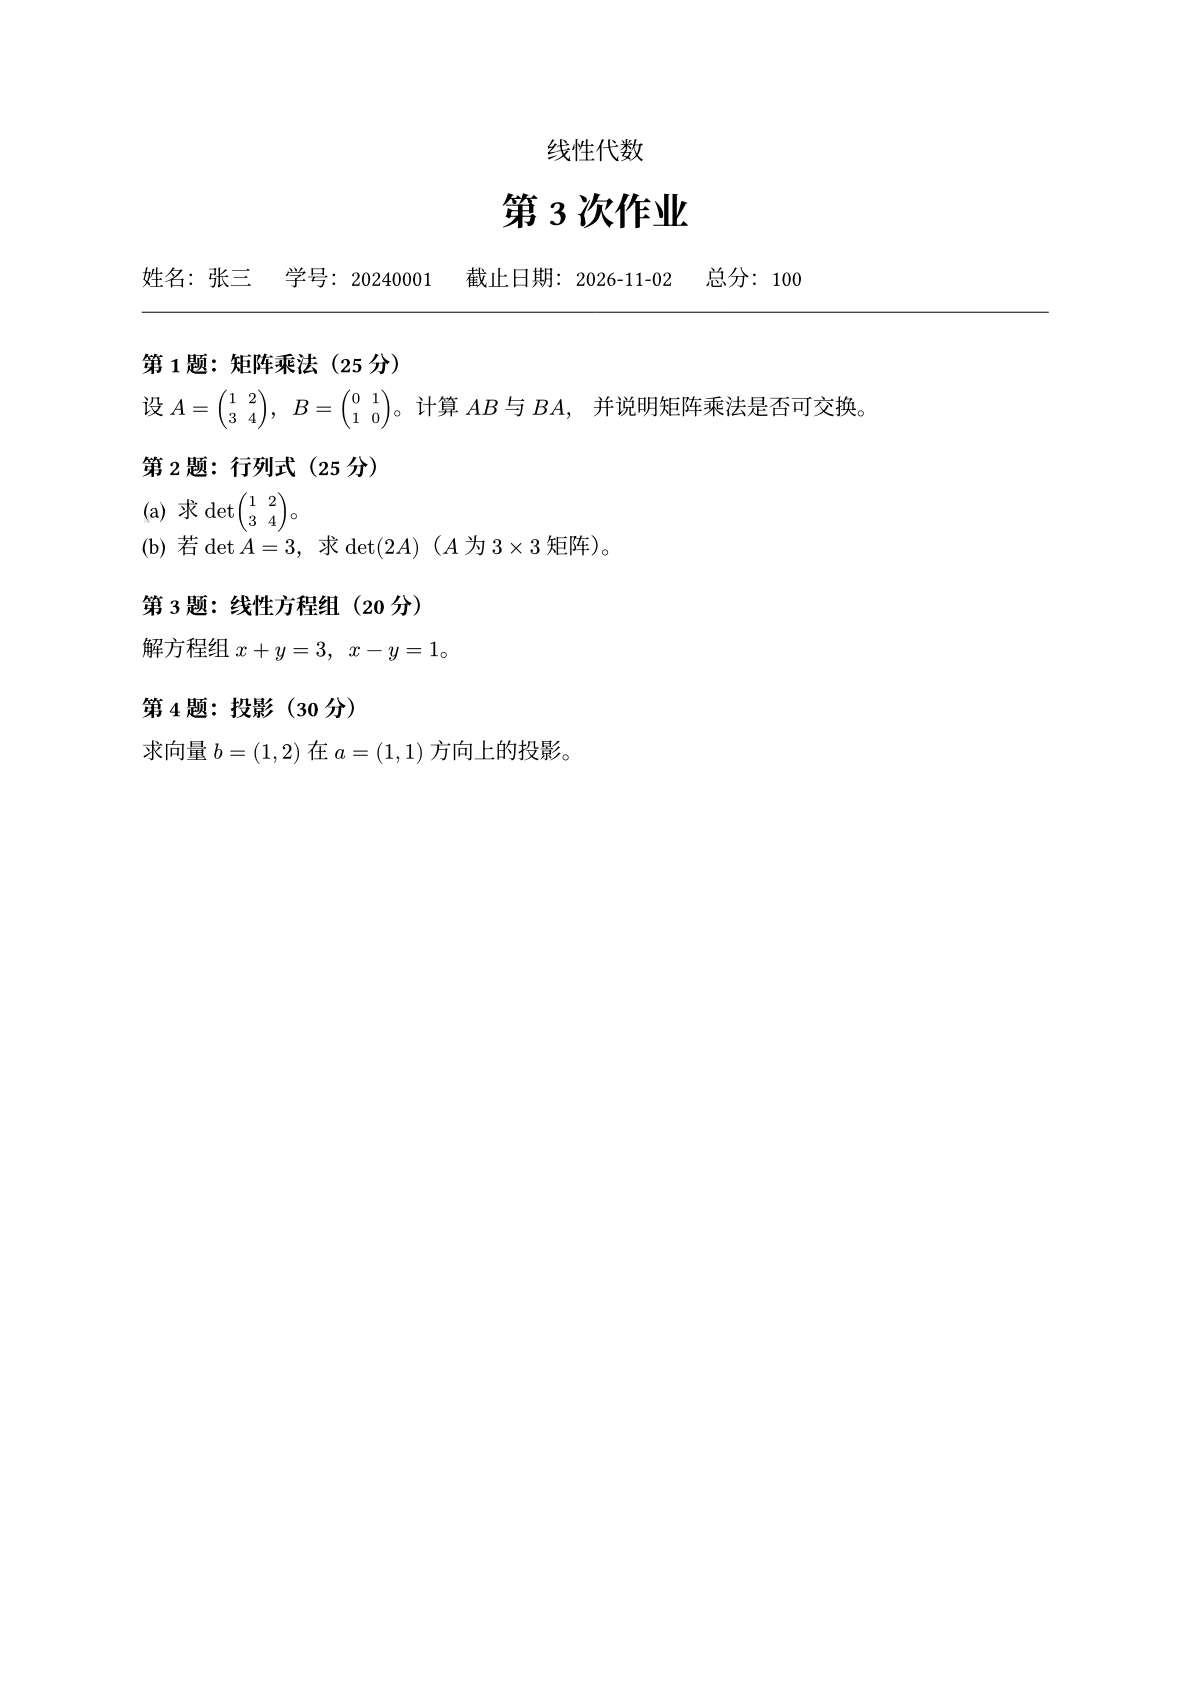
页眉一模一样,差别只有那四块灰色竖线。编译时间我也量了:hyperfine -N --warmup 3 --runs 20 分别跑上面两条 typst compile 命令,带解答 119.1 ms ± 6.4 ms,题目版 120.8 ms ± 6.5 ms,在误差之内没有区别。这不意外:solution 里的 if 只决定“要不要排版这个 block”,并不会让编译少读一个文件。
四个文件,一个文档
入口 examples/homework/main.typ 一共 12 行(源文件):
// Compile with --input solutions=false for the questions-only PDF.#import "@local/xuan:0.1.0": *
#show: homework.with( course: "线性代数", title: "第 3 次作业", student: "张三", student-id: "20240001", due: "2026-11-02",)
#include "problems/p1.typ"#include "problems/p2.typ"#include "problems/p3.typ"#include "problems/p4.typ"结构和第 4 篇的 #show: note.with(...) 一样:第一行 import 把 homework、problem、solution 这些名字拿进来,show: homework.with(...) 把版式规则套在后面的一切内容上,最后四行 include 把题目拉进来。每道题一个文件,p1.typ 是这样:
#import "@local/xuan:0.1.0": *
#problem(points: 25, title: "矩阵乘法")[ 设 $A = mat(1, 2; 3, 4)$,$B = mat(0, 1; 1, 0)$。计算 $A B$ 与 $B A$, 并说明矩阵乘法是否可交换。]#solution[ $ A B = mat(2, 1; 4, 3), quad B A = mat(3, 4; 1, 2). $ 两者不相等,所以一般不可交换。]p2.typ 展示小问怎么写,用的是 enum 函数,编号样式由 homework 统一设成 "(a)":
#import "@local/xuan:0.1.0": *
#problem(points: 25, title: "行列式")[ #enum( [求 $det mat(1, 2; 3, 4)$。], [若 $det A = 3$,求 $det(2 A)$($A$ 为 $3 times 3$ 矩阵)。], )]#solution[ #enum( [$1 dot 4 - 2 dot 3 = -2$。], [$det(2 A) = 2^3 det A = 24$。], )]p3.typ、p4.typ 结构相同(分值 20 和 30),不贴了,在仓库里。
注意每个题目文件自己又写了一遍 #import "@local/xuan:0.1.0": *。这不是啰嗦,是 include 的语义:它求值另一个文件,把得到的 content 贴到当前位置,不带回任何绑定,也不把当前文件的绑定借给对方。我做了个小实验确认(文件在 /tmp/ch12x,不在仓库里)。scope.typ 在自己里面定义了 greet,再 include 一个想用它的文件 inc.typ:
#let greet(who) = [hi #who]#include "inc.typ"inc.typ 只有一行 #greet("x"),编译:
error: unknown variable: greet ┌─ inc.typ:1:1 │1 │ #greet("x") │ ^^^^^
while including `inc.typ` at scope.typ:2:1 include "inc.typ"被包含的文件是一个独立的求值单元,看不到外面的名字。这是个好设计:每个题目文件的依赖都写在自己头上,单独拿出来也能编译。我直接编译了 p1.typ(typst compile --root . --ignore-system-fonts examples/homework/problems/p1.typ /tmp/p1.pdf),退出码 0,但内容变了:pdftotext 的第一行是 Problem 1:矩阵乘法 (25 pts)。单独编译时没有 homework 的 show 规则,text.lang 是默认的英文,标题就走了英文分支。这也反过来印证了前面的说法:中文的 第 1 题 来自 show: homework.with(...) 套在被包含的内容上。
那 homework.with(...) 的版式规则怎么影响到被包含的内容?因为 include 的结果是 content,它被放在 show: homework.with(...) 之后的文档流里,show 规则和 set 规则作用的是文档流,而不是文件边界。证据就在 PDF 里:solution 在被包含的文件里调用,却能读到 text.lang 并排出“解答”,说明 homework 里 xuan-cjk 设的 lang: "zh" 已经落在了这些内容上。
借用一个比方,把这件事一次说清:include 像是把别人写好的几页纸直接订进你的本子,纸上写什么就是什么;import 像是向别人借工具箱,你拿到的是名字(函数、变量、颜色),自己想怎么用怎么用。作业的题目是前者,homework 和 problem 是后者。
src/homework.typ:全文
下面是 88 行的全文(源文件)。它已经是最终版,我一段一段讲。
// Homework with switchable solutions and an auto-computed total.#import "cjk.typ": xuan-cjk#import "fonts.typ": fonts
#let solutions-on = state("xuan-solutions", true)
#let problem-counter = counter("xuan-problem-n")
/// `points` is stored in a metadata element so the header can sum it.#let problem(points: none, title: none, body) = { problem-counter.step() [#metadata(points) <xuan-problem>] context { let n = problem-counter.get().first() let head = if text.lang == "zh" [第 #n 题] else [Problem #n] if title != none { head += [:#title] } if points != none { head += if text.lang == "zh" [(#points 分)] else [ (#points pts)] } v(0.8em) text(weight: "bold", head) parbreak() body }}
/// Shown only when the `xuan-solutions` state is true.#let solution(body) = context { if solutions-on.get() { let label = if text.lang == "zh" { "解答" } else { "Solution" } block( width: 100%, inset: (left: 0.8em, y: 0.4em), stroke: (left: 2pt + luma(150)), above: 0.8em, )[ #text(weight: "bold", fill: luma(80), label) \ #body ] }}
#let homework( course: none, title: none, student: none, student-id: none, due: none, show-solutions: auto, lang: "zh", body,) = { let zh = lang == "zh" let on = if show-solutions == auto { sys.inputs.at("solutions", default: "true") == "true" } else { show-solutions } set document(title: if title != none { title } else { "" }) set page(paper: "a4", margin: 2.5cm) show: xuan-cjk.with(lang: lang) solutions-on.update(on)
align(center)[ #if course != none { text(size: 1.1em, course) } #v(-0.3em) #text(size: 1.7em, weight: "bold", title) ] let info = ( if student != none { (if zh { "姓名" } else { "Name" }, student) }, if student-id != none { (if zh { "学号" } else { "ID" }, student-id) }, if due != none { (if zh { "截止日期" } else { "Due" }, due) }, ).filter(x => x != none) grid( columns: info.len() + 1, column-gutter: 1.5em, ..info.map(((k, v)) => [#k#if zh [:] else [: ]#v]), context { let total = query(<xuan-problem>) .map(m => m.value) .filter(v => v != none) .sum(default: 0) if zh [总分:#total] else [Total: #total] }, ) line(length: 100%, stroke: 0.5pt) set par(first-line-indent: 0pt) set enum(numbering: "(a)") body}两个文档级变量:solutions-on 和 problem-counter。 题目文件之间互不可见,它们之间要通信,只能走文档级的东西:state("xuan-solutions", true) 记录“要不要显示解答”,counter("xuan-problem-n") 记录“现在是第几题”。两者按字符串键全局共享,不管 problem 是在 main.typ 里调用还是在 p3.typ 里调用,用的都是同一份。这正是上一节那个限制的另一面:include 的文件看不到变量,所以跨文件共享的东西要放进 state 和 counter。
problem:编号、标题与分值。 problem-counter.step() 让计数器加一,它本身不需要 context;[#metadata(points) <xuan-problem>] 在这里留下一个带标签的隐形元素,值就是分值,页眉稍后会 query 它。标题那一段包在 context { ... } 里,因为读 problem-counter.get() 和 text.lang 都要知道“我在文档的哪个位置”(第 7 篇的主题);text.lang == "zh" 决定输出 第 1 题(25 分) 还是 Problem 1 (25 pts)。head += [:#title] 利用的是 content 可以用 + 拼接这个事实(第 3 篇)。points: none 是合法的:没有分值的题只是不显示括号,也不计入总分。
solution:整个内容被开关一刀切掉。 context { if solutions-on.get() { ... } }:状态为假时,context 的值是 none,页面上什么都不剩,包括外面那圈 block 的缩进和灰线,所以题目版里不会有空白的竖线。左侧竖线用 stroke: (left: 2pt + luma(150)),只给一边描边。
homework:把参数变成版式。 函数体按顺序做五件事:
- 解出
on。show-solutions默认是auto,此时读sys.inputs.at("solutions", default: "true") == "true";调用者也可以直接传true或false,写死在源文件里,优先于命令行。 - 三条 set:
document(title:)写进 PDF 元数据,page(paper: "a4", margin: 2.5cm),以及show: xuan-cjk.with(lang: lang),复用第 5 篇的中文排版。 solutions-on.update(on):把第 1 步算出的布尔值存进 state,从这一刻起,文档里所有后面的solution都读得到。- 标题块和信息栏。
info是一个数组,每个元素是(标签, 值),没传的字段是none,再.filter(x => x != none)去掉;info.len() + 1就是网格的列数,多出来的那一列留给总分。..info.map(((k, v)) => ...)里的((k, v)) =>是闭包参数的解构(我在/tmp/ch12x/d3.typ里编译确认过:((k, v)) => [#k=#v]接收(1, 2)得到1=2,不在仓库里),..把整个数组展开成网格的单元格。 set par(first-line-indent: 0pt)与set enum(numbering: "(a)"):作业里的段落不需要首行缩进,小问用(a)、(b)。这两条 set 写在页眉之后、body之前,只影响题目内容,不影响上面的标题块。
总分:为什么需要多遍编译
总分那一格是整个模板里最有意思的地方。下面是它的代码,摘自上面 grid 的最后一个参数(我去掉了缩进和结尾的逗号,并给 context 补了一个 #,这样它能独立成立;zh 是 homework 开头定义的变量):
#context { let total = query(<xuan-problem>) .map(m => m.value) .filter(v => v != none) .sum(default: 0) if zh [总分:#total] else [Total: #total]}它在文档最前面,却要知道后面四道题各带多少分。按“从头到尾排一遍版”的直觉,这做不到:排到页眉时,题目还没出现。Typst 的做法在第 7 篇讲过:多编译几遍,第一遍时 query 先拿到一个不完整的(甚至空的)答案,排完版把所有 metadata 收集起来,第二遍用收集到的值重新排,直到答案和上一遍一致。总分正是这样收敛的:第一遍 query(<xuan-problem>) 看不到题目,总分是个占位值;第二遍看到四个值,得到 100;100 的排版没有改变任何 metadata,编译器确认稳定,停止。
default: 0 看起来是为第一遍写的,但我实测发现不是:它只在最后一遍里没有任何 problem 调用时才起作用。空数组调 .sum() 会报错,我单独试了一行 #().sum():
error: cannot calculate sum of empty array with no default ┌─ sum.typ:1:1 │1 │ #().sum() │ ^^^^^^^^我把 default: 0 从 homework.typ 里临时删掉(审阅时做的实验,已还原),examples/homework 照样编出了 总分:100:非最终遍里的错误会被丢弃,只有最终遍的结果算数。我用两个 /tmp/ch12x 里的小文件确认了这一点(不在仓库里):#context { query(<p>).map(m => m.value).sum() } 后面跟两个带 <p> 的 metadata,编译输出 100;去掉那两个 metadata,编译报上面这条 cannot calculate sum of empty array with no default。所以 default: 0 保护的是“一道题都没有”的文档(比如只写了 #show: homework.with(...) 的空作业)。.filter(v => v != none) 的作用我也试了一下(/tmp/ch12x/ns.typ,不在仓库里):
#repr((1, none).sum()) \#repr((none, none).sum()) \#repr((none, none).filter(v => v != none).sum(default: 0))1none0none 对加法是单位元,所以混着没有分值的题时 sum 本来就不会报错;但如果所有题都没有分值,sum 返回的是 none 而不是 0,页眉会排出一个空的总分。先过滤再 sum(default: 0),这种情况下得到的是 0。
query 能看到后面的元素,这一点我单独验证了一遍(/tmp/ch12x/conv.typ,不在仓库里):
#context [前面的 query:#query(<p>).len() 个]
[#metadata(25) <p>][#metadata(75) <p>]前面的 query:2 个第一行在两个 metadata 之前,却数到了 2 个。再数一数编译遍数:用第 7 篇的方法,--timings 加 jq 数 iter 事件的个数:
typst compile --root . --ignore-system-fonts --input solutions=true --timings t.json examples/homework/main.typ out.pdfjq '[.[]|select(.name|startswith("iter"))|select(.ph=="B")]|length' t.json输出 2。--input solutions=false 同样是 2。两遍,和上面的推演一致:第一遍总分是 0,第二遍是 100,第三遍没有必要。
--input:命令行里的条件编译
typst compile --input solutions=false 把键值对放进 sys.inputs,一个字典,在源码里用 sys.inputs.at("solutions", default: "true") 读。default 让不带参数的编译走“显示解答”的分支。
有一个细节容易踩:--input 的值永远是字符串。所以 homework 里比较的是 == "true",而不是当作布尔值直接用。我多试了一种写法,把值写成 maybe:
$ typst compile --root . --ignore-system-fonts --input solutions=maybe examples/homework/main.typ /tmp/o3.pdf$ pdftotext /tmp/o3.pdf - | grep -c 解答0"maybe" == "true" 为假,解答被隐藏。这个规则是我在 homework 里写下的(只有字符串 "true" 才算开),不是 Typst 的内置行为;如果想更严格,可以对 "true" 和 "false" 之外的值直接 panic,这里我没有做。
这就是“条件编译”在 Typst 里的全部:没有 #ifdef,只有普通的 if 加上一个能从外面传进来的字典。同样的做法在第 11 篇的 --input lang=en 里出现过,这里换了个用途。
模块:每一种写法都跑一遍
lab/ch12/modules/ 下有三个文件,演示 import 的所有形式。先是被导入的 a.typ(源文件):
#let name = "a"#let greet(who) = [Hello #who from #name]#let hidden-helper = 1再是 b.typ(源文件),它自己也导入了 a.typ,并且正文里有一个标题:
#import "a.typ"#let name = "b"#let both() = [#a.name and #name]= Section from b.typThis file was included.入口 main.typ(源文件)把所有写法排成一列:
// All import forms. Paths are relative to the importing file.#import "a.typ" // module bound to `a`#import "a.typ" as alpha // renamed#import "a.typ": greet // one item#import "a.typ": greet as hi, name as a-name // items with aliases#import "/lab/ch12/modules/b.typ": both // root-relative (--root .)#import "a.typ": * // everything public: `name`, `greet`, ...
#assert.eq(a.name, "a")#assert.eq(alpha.name, "a")#assert.eq(a-name, "a")#assert.eq(name, "a")#greet("you"); #hi("me") \#both() \// `include` pastes the other file's content, not its bindings.#include "b.typ"逐行读:
#import "a.typ":不带冒号,整个模块绑成一个名字a(取文件名去掉扩展名),之后写a.name、a.greet(...)。#import "a.typ" as alpha:同样绑整个模块,但改名。#import "a.typ": greet:只取一个名字。#import "a.typ": greet as hi, name as a-name:取多个名字,每个都可以单独as改名。name as a-name是为了不和后面*带进来的name打架,这里的用意是演示别名;hi是greet的别名。#import "/lab/ch12/modules/b.typ": both:以/开头的路径是根相对的,根是--root指定的目录(make里是--root .,即仓库根)。#import "a.typ": *:把a.typ里的所有顶层名字都倒进当前作用域。
assert.eq 检查的是绑定,真正的输出来自后面三行。make ch12 编译后用 pdftotext -layout 看内容:
Hello you from a Hello me from aa and b
Section from b.typThis file was included.第一行:greet("you") 和 hi("me") 是同一个函数;两处都是 “from a”,因为函数里的 name 是定义它的 a.typ 里的那个,不是调用处当前作用域里的 name(这是第 3 篇讲过的闭包:函数记住的是定义时的环境)。第二行:both() 来自 b.typ,它用的 a.name 与 name("b")都在 b.typ 里解析,所以是 a and b。第三、四行是 #include "b.typ" 的结果:b.typ 里的正文(那个标题和那句话)原样出现在这里,而 b.typ 里的 let 绑定一个也没有带进来。
Typst 没有“私有”
a.typ 里我故意留了一个 hidden-helper,名字听起来像内部用的。用 * 导入后直接用它(/tmp/ch12x/priv.typ,实验文件,不在仓库里):
#import "a.typ": *#hidden-helper输出:
1没有任何拦截。Typst 的模块里每个顶层 let 都是公开的,没有 pub 或下划线约定能把它藏起来。这就是为什么 xuan 的 lib.typ 只放显式的 #import "src/x.typ": a, b, c 列表(第 4 篇):包的公开接口靠“入口文件里挑名字”来定义,而不是靠语言的可见性。
根相对路径与 --root
第 5 行的 /lab/ch12/modules/b.typ 依赖 --root。不给它的话,Typst 的根默认是入口文件所在目录,/ 指向那里。我在仓库根目录直接去掉 --root . 编译:
$ typst compile --ignore-system-fonts lab/ch12/modules/main.typ /tmp/m.pdferror: file not found (searched at /home/bfmhno3/Projects/typst-lab/lab/ch12/modules/lab/ch12/modules/b.typ) ┌─ lab/ch12/modules/main.typ:6:8 │6 │ #import "/lab/ch12/modules/b.typ": both // root-relative (--root .) │ ^^^^^^^^^^^^^^^^^^^^^^^^^报错里“searched at”后面那串路径,把 / 解析成了 lab/ch12/modules/,再拼上 lab/ch12/modules/b.typ。这就是根相对路径的含义:/ 不是文件系统根,是 --root。仓库里每条 typst compile 都带 --root .,就是为了让这类以 / 开头的路径指向仓库根。
lab/ch12/fig-homework.typ 也靠相对路径:它只有三行:
// The homework example's first page, with solutions.#import "@local/xuan:0.1.0": *
#include "../../examples/homework/main.typ"它是上面带解答 PDF 的出处:make ch12 把它渲染成 out/figures/ch12-homework.png,也就是本文第一张图。路径里的 .. 从当前文件的目录往上走。但根是边界:我在 /tmp/ch12x/sub/m.typ 里写 #import "../up.typ": v,用 --root /tmp/ch12x/sub 编译,得到 error: path `"../up.typ"` would escape the project root。所以 --root 同时是路径的起点和围栏:源码够不到根之外的文件。
0.15 的 path 类型
模块的路径是字符串,字符串有个问题:它相对于谁?import "a.typ" 和 include 很清楚,相对于写这行代码的文件。但当一个函数接收路径、再用 csv(p) 去读文件时,就有了两个候选:调用者的目录,还是函数所在文件的目录?Typst 对字符串的回答是后者:读文件的地方说了算。0.15 新增的 path 类型提供了另一个选择:path("...") 在创建的地方就按那个文件解析,之后不管传到哪里都指向同一个文件。
lab/ch12/path-type/ 把两种行为放在一起(目录)。数据有两份,文件名一样,内容不同:
who,scorecaller,1这是 path-type/data/scores.csv;path-type/lib/data/scores.csv 的第二行是 helper,2。帮手模块 lib/helper.typ 只有一行:
// A path value remembers the file that made it; a string does not.#let first-row(p) = csv(p).at(1)入口 main.typ:
// 0.15: path("...") is resolved against THIS file, wherever it is used.#import "lib/helper.typ": first-row
// Resolves relative to main.typ: data/scores.csv here (caller).#let from-path = first-row(path("data/scores.csv"))// A plain string resolves where it is read: lib/data/scores.csv (helper).#let from-str = first-row("data/scores.csv")
#assert.eq(from-path.first(), "caller")#assert.eq(from-str.first(), "helper")
- `path("data/scores.csv")` loaded the #from-path.first() file- `"data/scores.csv"` loaded the #from-str.first() file两次调用传的是同样的字面量 "data/scores.csv",区别只是有没有套 path(...)。make ch12 编完后:
$ pdftotext out/ch12/path-type.pdf -• path("data/scores.csv") loaded the caller file• "data/scores.csv" loaded the helper filepath(...) 版读到了 caller(main.typ 旁边的 data/),字符串版读到了 helper(helper.typ 旁边的 lib/data/),两条 assert.eq 也通过了。
那 path 值里到底存了什么?我在同一个目录里临时建了一个文件(zz.typ,编完就删了,不在仓库里),内容是一行 #repr(path("data/scores.csv")),用 --root . 编译,输出:
path("/lab/ch12/path-type/data/scores.csv")创建的那一刻,相对路径就被换算成了根相对的绝对形式。这解释了“记住来源”:值里存的是已经解析好的路径,后面谁来读都不会再变。另一个小实验(/tmp/ch12x/pt.typ,根是 /tmp/ch12x,所以结果是根相对的 /a/b.csv)也印证了同一点:
#repr(path("a/b.csv"))path("/a/b.csv")什么时候用哪个?写一个“读用户给的文件”的库函数,用 path 型参数,调用者传 path("data/x.csv") 就不用操心库文件在哪;要是只收字符串,它就相对库文件解析,调用者多半会写错。homework 模板本身没有用到 path(它不读外部文件),这里单独拿出来,是因为“相对谁”这个问题一旦跨文件传参就绕不开。
循环导入
模块之间可以互相依赖,但不能绕成环。lab/ch12/cycle/ 下,x.typ 导入 y.typ,y.typ 又导入 x.typ:
#import "y.typ": y#let x = 1#import "x.typ": x#let y = 2入口 main.fail.typ(文件名里的 .fail 是仓库约定,make ch12 期望它编译失败并保存 stderr):
// x.typ imports y.typ, which imports x.typ again.#import "x.typ": x#xout/ch12/cycle.stderr:
error: cyclic import ┌─ lab/ch12/cycle/y.typ:1:8 │1 │ #import "x.typ": x │ ^^^^^^^
while importing `y.typ` at lab/ch12/cycle/x.typ:1:1 import "y.typ": y while importing `x.typ` at lab/ch12/cycle/main.fail.typ:2:1 import "x.typ": x错误指在“闭合环”的那一行(y.typ 的第 1 行,它要导入的 x.typ 已经在求值栈里了),下面的 while importing 链是完整的调用栈:main.fail.typ 导入了 x.typ,x.typ 导入了 y.typ,y.typ 想再导入 x.typ。原因不难理解:import 要先把对方整个求值完才能拿到名字,两个文件互相等对方求值完,谁也没法先出结果。include 受同样的限制,因为它同样要先求值对方。
解法一般是把两边共同需要的东西抽到第三个文件里,让 x 和 y 都只单向依赖它。xuan 的 src/ 就是这样分层的:util.typ、fonts.typ 和 page.typ 不导入任何兄弟模块,在最底层,cjk.typ 导入 fonts.typ,在上一层,note.typ、homework.typ 在最上层,没有一条回头的边。
跑一遍
cd ~/Projects/typst-labnix developmake ch12make examplesmake ch12 的输出:
./scripts/chapter.sh ch12ok lab/ch12/fig-homework.typok lab/ch12/cycle/main.fail.typ (failed as expected)ok lab/ch12/modules/main.typok lab/ch12/path-type/main.typmake examples 最后两个文件就是前面看到的 out/examples/homework.pdf 与 out/examples/homework-questions.pdf。你可以把 examples/homework/problems/p3.typ 里的 points: 20 改成 points: 5,再编译一次(我在 /tmp/hw 的副本上这样做过),pdftotext 里的总分是 总分:85,改的只是一个文件里的一个数字。
下一篇是幻灯片与绘图:同样是“一份源码,多个页面”,只不过页面不再是 A4 纸,而是一页一页的画面,slide 的 steps 会让一个函数发出多页,那里还会再用到 counter。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!