
 Better Mistakes



音乐
暂未播放
数据驱动:用一份 YAML 生成中英文简历
- 1第一份文档:标记语法、编译与 watch
- 2代码模式:值、类型与控制流
- 3函数与 content:一切都是函数调用
- 4set 与 show:样式是规则,不是命令
- 5字体与中文排版
- 6页面与布局:盒子、网格与浮动
- 7context、计数器与状态:Typst 如何“多遍”编译
- 8数学公式
- 9图、表、代码与交叉引用
- 10参考文献:BibTeX、Hayagriva 与 GB/T 7714
- 11数据驱动:用一份 YAML 生成中英文简历本文
- 12作业模板:模块、多文件与条件编译
- 13幻灯片与绘图
- 14生态:Typst Universe 与第三方包
- 15用 Rust 写一个 WebAssembly 插件:按拼音排序术语表
- 16导出、工具链与 CI
简历是最适合拿来学“数据和版式分开”的文档:内容一年改两三次,版式一次定好就不动,而且常常要两种语言各来一份。前面的文章里,正文就是源码;这一篇换个路子:内容放进 cv.yaml,版式放进 src/cv.typ 里的一个函数,typst compile 加一个 --input lang=en 就换一种语言。顺着这条线,我把 Typst 所有的数据加载函数、命令行传参、eval 和 datetime 一次跑完。
这一篇结束时你会有:src/cv.typ(最终版,113 行,全文都在下面)、examples/cv/cv.yaml 与 examples/cv/main.typ,以及 lab/ch11/ 下的 5 个文件。lib.typ 是中间版本,这一章只往里加了一行 #import "src/cv.typ": cv。make ch11 全部通过;make examples 会产出 out/examples/cv.pdf 和 out/examples/cv-en.pdf。
前置:第 10 篇(参考文献)。这一篇用到第 2 篇的字典和 for、第 3 篇的闭包和 ..args、第 5 篇的 xuan-cjk。
一份数据,两个 PDF
先看产物。examples/cv/main.typ 一共四行(源文件):
// Language comes from the command line: --input lang=en#import "@local/xuan:0.1.0": *
#let lang = sys.inputs.at("lang", default: "zh")#cv(yaml("cv.yaml"), lang: lang)数据在 cv.yaml,共 54 行,人物是虚构的张三 / Zhang San。我只摘开头到第一条教育经历,完整文件在仓库里:
# Every human-readable field is a string or {zh:, en:}.# Strings are evaluated as Typst markup.name: { zh: 张三, en: Zhang San }email: zhangsan@example.comphone: "+86 138 0000 0000"github: github.com/examplesite: example.com/zhangsaneducation: - school: { zh: 示例大学, en: Example University } degree: { zh: 计算机科学与技术 本科, en: "B.Eng. in Computer Science" } start: "2021-09" end: "2025-06" detail: zh: "GPA 3.8/4.0,专业排名前 5%,主修课程:线性代数、算法、操作系统。" en: "GPA 3.8/4.0, top 5% of the program. Courses: linear algebra, algorithms, operating systems."约定只有两条:每个给人看的字段要么是一个字符串,要么是 {zh: ..., en: ...};字符串里可以夹 Typst 标记(比如 *3 倍*、#link(...)[...]、$x_k$)。两条约定对应后面 tr 和 rich 两个小函数。
用两种方式编译,再看页数:
$ typst compile --root . --ignore-system-fonts examples/cv/main.typ out/examples/cv.pdf$ typst compile --root . --ignore-system-fonts --input lang=en examples/cv/main.typ out/examples/cv-en.pdf$ pdfinfo out/examples/cv.pdf | grep PagesPages: 1$ pdfinfo out/examples/cv-en.pdf | grep PagesPages: 1(这两条编译命令就是 make examples 里的两行,我是在仓库的 nix develop 里跑的。)渲染结果:
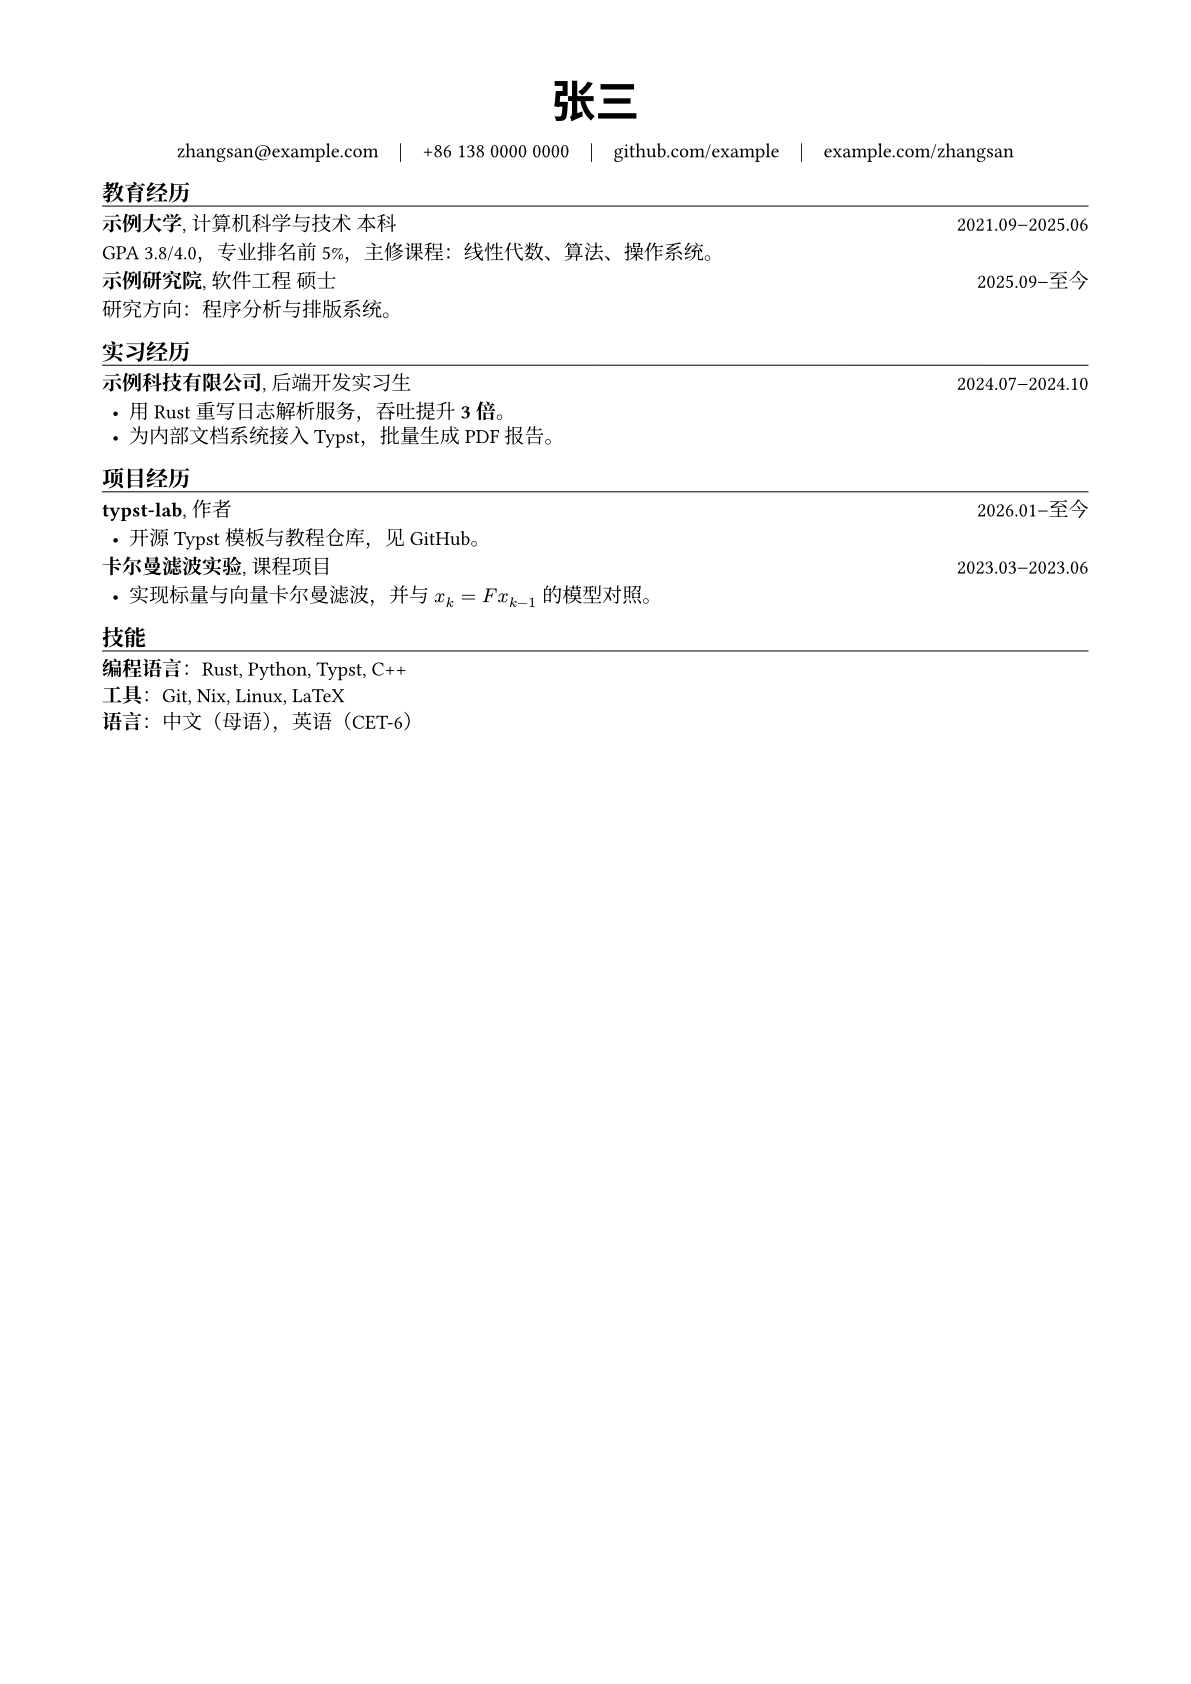
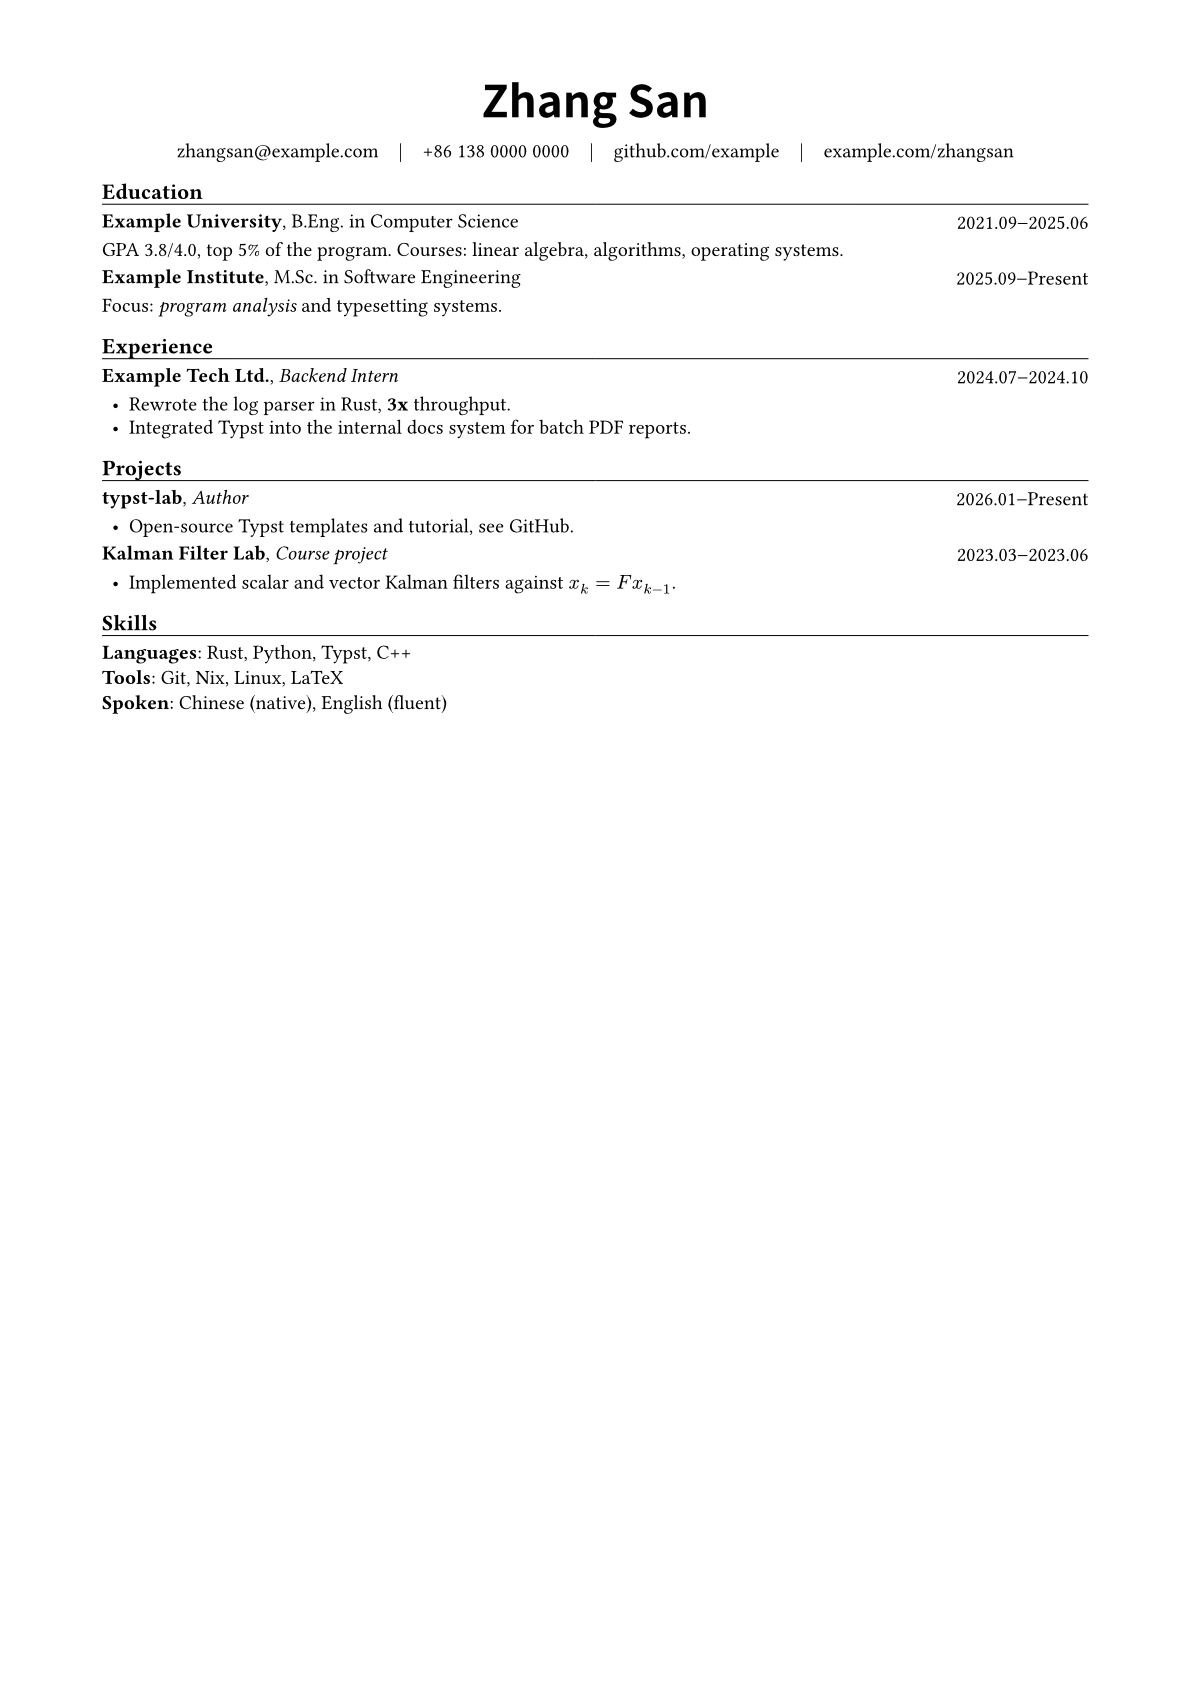
两张图版式完全一致,差别只来自 YAML 里 zh 和 en 两个键、四个节标题、以及 至今 / Present。这像是一份价目表可以印成中文菜单也可以印成英文菜单:价格不用重抄,改一处,两本菜单一起变。
加载器:每一种都返回普通值
Typst 的数据加载函数有一个共同点:它们是编译期读文件,返回的就是第 2 篇里讲过的普通值(字典、数组、字符串、字节),没有什么“数据对象”。lab/ch11/loading.typ 把它们逐个过了一遍(源文件),数据在 lab/ch11/data/ 下。
// Every loader returns plain values; paths are relative to this file.#let y = yaml("data/scores.yaml")#assert.eq(y.students.first().name, "张三")
#let t = toml("data/cfg.toml")#assert.eq(t.page.margin, 2.5)
#let j = json("data/obj.json")#assert.eq(j.tags, ("typst", "json"))
// Default: array of arrays, header row included.#let rows = csv("data/scores.csv")#assert.eq(rows.first(), ("name", "score"))// `row-type: dictionary` keys every row by the header.#let recs = csv("data/scores.csv", row-type: dictionary)#assert.eq(recs.at(1).score, "85")
// xml: an array of nodes; elements are dictionaries.#let x = xml("data/scores.xml").first()#assert.eq(x.tag, "course")#assert.eq(x.attrs.code, "LA101")#assert.eq(x.children.first().children, ("张三",))
#let c = cbor("data/a.cbor")#assert.eq(c, (a: 1))
// read: text by default, bytes with encoding: none.#assert.eq(read("data/hello.bin"), "hello")#let b = read("data/hello.bin", encoding: none)#assert.eq(type(b), bytes)#assert.eq(b.len(), 5)#assert.eq(array(b).first(), 104)#assert.eq(str(b), "hello")
= Loaded data- yaml: #y.course, #y.students.len() students- csv: #recs.map(r => r.name + "=" + r.score).join(", ")- xml code: #x.attrs.code- bytes: #b.len() bytes, first byte #array(b).first()$ nix develop --command make ch11./scripts/chapter.sh ch11ok lab/ch11/datetime.typok lab/ch11/eval-markup.typok lab/ch11/fig-cv.typok lab/ch11/inputs.typok lab/ch11/loading.typok lab/ch11/inputs.typ (default and --input name=Typst)所有 assert.eq 都过了,文件才能编译成功,所以这个文件本身就是一份可执行的说明。几个要点:
yaml、toml、json 是同一种东西。 三者都把文档解析成字典和数组,数字就是 int 或 float,字符串就是 str。选哪个看谁来写文件:简历这种嵌套多、有列表的数据,YAML 最省字符;配置风格的键值用 TOML;要和别的程序共用就是 JSON。
csv 默认丢掉类型。 所有单元格都是字符串,包括数字。我把 scores.csv 的三种读法用 repr 打了出来(/tmp/p11/rp/t.typ,不在仓库里,数据文件是从 lab/ch11/data/ 拷过去的):
( ("name", "score"), ("张三", "92"), ("李四", "85"),)( (name: "张三", score: "92"), (name: "李四", score: "85"),)第一段是默认的数组套数组,表头也是一行数据;第二段是 row-type: dictionary,第一行变成键。要做算术必须自己 int(r.score),这也是为什么 loading.typ 里断言的是 "85" 而不是 85。
xml 返回节点树。 同一个实验里 xml("data/scores.xml") 的 repr:
( ( namespace: none, tag: "course", attrs: (code: "LA101"), children: ( ( namespace: none, tag: "student", attrs: (score: "92"), children: ("张三",), ), ( namespace: none, tag: "student", attrs: (score: "85"), children: ("李四",), ), ), ),)顶层是数组(可以有多个根节点或文本节点),元素是带 tag、attrs、children 的字典,文本直接是字符串。所以 xml(...).first() 才是 <course> 元素。
cbor 是二进制 JSON。 lab/ch11/data/a.cbor 一共 4 个字节:
$ od -An -tx1 lab/ch11/data/a.cbor a1 61 61 01a1 是“含 1 个键值对的 map”,61 61 是长度 1 的字符串 "a",01 是整数 1。cbor("data/a.cbor") 读出来就是 (a: 1)。
read 是所有加载器的底层。 默认把文件当 UTF-8 文本读成 str;加 encoding: none 就返回 bytes。bytes 能 .len(),能 array(b) 变成整数数组(h 是 104),也能 str(b) 解回字符串。第 15 篇的 WebAssembly 插件,输入输出全是 bytes。如果文件不是合法 UTF-8,不加 encoding: none 会直接报错,我拿两个字节 \xff\xfe 试了:
error: failed to convert to string (file is not valid UTF-8 in bin.dat:1:1) ┌─ r.typ:1:6 │1 │ #read("bin.dat") │ ^^^^^^^^^路径相对谁,能走多远
loading.typ 开头那句注释“paths are relative to this file”值得拆开。相对路径是相对调用加载函数的那个 .typ 文件,不是相对你运行 typst 的目录。main.typ 里写 yaml("cv.yaml") 能成功,是因为 cv.yaml 和 main.typ 在同一个目录;lab/ch11/fig-cv.typ 要借同一份数据,就得写 yaml("../../examples/cv/cv.yaml")。
以斜杠开头的路径(/examples/cv/cv.yaml)相对项目根,根由 --root 决定,默认是入口文件所在目录。这就是为什么仓库的所有命令都带 --root .:fig-cv.typ 在 lab/ch11/ 下,要读到 examples/,根必须是仓库顶层。越出根目录的路径是被拒绝的,不是被忽略的,下面 eval 一节我会实测一次。
YAML 解析出来的类型
写 cv.yaml 时我最担心的是 YAML 的隐式类型:2021-09 会不会变成日期,no 会不会变成 false。我试了一下(/tmp/p11/y/,不在仓库里):
a: 2021-09b: 2021-09-01c: nod: 1.0e: "2021-09"f: presentg: 0123h: null#let d = yaml("d.yaml")#for (k, v) in d [ #k: #repr(v) (#type(v)) \]a: "2021-09" (str)b: "2021-09-01" (str)c: "no" (str)d: 1.0 (float)e: "2021-09" (str)f: "present" (str)g: "0123" (str)h: none (type(none))在 Typst 0.15.1 里,不带引号的日期、no、0123 都是字符串,1.0 是 float,null 是 none。所以 cv.yaml 里 start: "2021-09" 的引号对 Typst 来说不是必须的。我还是留着:这份文件如果换成别的 YAML 工具读,规则可能不同(这一点我没有验证,只是不想让数据对解析器敏感)。
sys.inputs:从命令行到文档的唯一通道
--input lang=en 做的事极其朴素:命令行上每个 key=value 进入字典 sys.inputs,键和值都是字符串。lab/ch11/inputs.typ 把它缩到最小(源文件):
// Pass values from the shell: typst compile --input name=Typst inputs.typ#let name = sys.inputs.at("name", default: "world")// Inputs are always strings.#assert.eq(type(name), str)
Hello, #name!
#if name == "Typst" [The flag was set.] else [Using the default.]chapter 脚本的 lab/ch11/extra.sh 把它编译了两次,一次不带参数,一次带 --input name=Typst。我手工跑一遍并读出文字:
$ typst compile --root . --ignore-system-fonts --input name=Typst lab/ch11/inputs.typ /tmp/p11/i.pdf$ pdftotext /tmp/p11/i.pdf -Hello, Typst!The flag was set.不带参数时走 default: "world",输出 Hello, world! 和 Using the default.(make ch11 编译过这一份,我没有单独读它的文字)。
关于 sys.inputs 有三个细节:
- 一定用
.at(key, default: ...)。 直接sys.inputs.lang在没传参时会因为键不存在而报错,文档就编译不出来。带default的写法让“不传参数”成为合法状态,make examples里中文版根本不带--input。 - 值是字符串。 想传数字要自己
int(sys.inputs.n),想传布尔要写成sys.inputs.at("solutions") == "true"。第 12 篇的作业模板--input solutions=false就是这么判断的。 - 格式有要求。
--input lang没有等号,命令行解析器直接拒绝:
error: invalid value 'lang' for '--input <key=value>': input must be a key and a value separated by an equal sign值里再出现等号没问题,--input lang=a=b 会得到键 lang、值 a=b(我跑了,sys.inputs.lang 输出 a=b)。
给 lang 加一道检查
main.typ 把 sys.inputs 里的字符串原样交给 cv(lang:),所以拼错的语言也会原样进来。cv 的第一行就是对它的检查:
assert(lang in ("zh", "en"), message: "xuan: cv lang must be zh or en")(它是 cv 函数体里的第一行,完整上下文在下面的 cv.typ 全文里。)我试了 --input lang=fr:
$ typst compile --root . --ignore-system-fonts --input lang=fr examples/cv/main.typ /tmp/p11/fr.pdferror: assertion failed: xuan: cv lang must be zh or en ┌─ @local/xuan:0.1.0/src/cv.typ:61:2 │61 │ assert(lang in ("zh", "en"), message: "xuan: cv lang must be zh or en") │ ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
while calling `cv` at examples/cv/main.typ:5:1 cv(yaml("cv.yaml"), lang: lang)错误直接说出了原因,并且指向调用 cv 的那一行。(这一行是后来加的:加之前,同一条命令报的是 cannot add dictionary and string,指到 set document 那一行,因为 tr 在字典里找不到键 fr 时把整个 {zh:, en:} 字典原样返回,后面再拿它做字符串加法才炸。)
eval:把字符串变成 content
cv.yaml 里有这样的字符串:
# examples/cv/cv.yaml, line 21 (education) and line 29 (experience) zh: "研究方向:#emph[程序分析]与排版系统。" - zh: "用 Rust 重写日志解析服务,吞吐提升 *3 倍*。"YAML 解析器只会给你字符串,#emph[...] 和 *3 倍* 在 Typst 眼里是普通字符。要让它们生效,需要 eval:把字符串当 Typst 源码再编译一遍。lab/ch11/eval-markup.typ 展示了它的三种模式(源文件):
// eval turns a string into content (markup), a value (code) or math.#let src = "*bold* and _emph_ with $x^2$"#eval(src, mode: "markup")
// mode: "code" returns values, not content.#assert.eq(eval("1 + 2 * 3", mode: "code"), 7)#assert.eq(eval("(1, 2, 3).map(x => x * x)"), (1, 4, 9))
// mode: "math" parses math syntax.#eval("a^2 + b^2 = c^2", mode: "math")
// Extra names go in `scope`.#eval("[#who wrote this.]", mode: "code", scope: (who: "I"))#eval("#who wrote this.", mode: "markup", scope: (who: "You"))mode 默认是 "code",和你在 # 后面写的是同一种语法,返回的是值;"markup" 返回 content,和你在方括号里写的一样;"math" 是公式模式。cv 用的是 markup:简历里的每个字符串本质上是一小段正文,#emph[...] 要带 # 才是调用,*...* 直接就是加粗,这和你在 .typ 文件正文里写的规则一模一样。
它能看到哪些名字
我最想弄清的是作用域:eval 里能引用我模板里的变量吗?能调用 cv 吗?下面是六个最小实验,放在 /tmp/p11/sc/(不在仓库里),每个文件一行 eval,用同一个脚本编译并打印第一行错误或输出:
#let secret = 1#eval("#secret", mode: "markup")#import "@local/xuan:0.1.0": cv#eval("#cv", mode: "markup")#eval("#emph[x] #calc.pow(2, 3) #sys.inputs.len()", mode: "markup")#let secret = 1#eval("#secret", mode: "markup", scope: (secret: secret))#eval("#read(\"s1.typ\")", mode: "markup")#eval("#read(\"../../../../etc/passwd\")", mode: "markup")脚本是这样的:
for f in s1 s2 s3 s4 s5 s6; do echo "== $f" if typst compile --root . --ignore-system-fonts $f.typ $f.pdf 2> $f.err; then echo "ok: $(pdftotext $f.pdf - | head -c 60 | tr '\n' ' ')" else head -1 $f.err fidone== s1error: unknown variable: secret== s2error: unknown variable: cv== s3ok: x80== s4ok: 1== s5ok: #let secret = 1 #eval("#secret", mode: "markup")== s6error: path `"../../../../etc/passwd"` would escape the project root结论:
eval里是一张干净的作用域,只有标准库。 你文件里#let的变量(s1)和#import进来的名字(s2)都不可见;emph、calc.pow、sys.inputs这些标准库的东西可见(s3,输出x、8、0:没传--input,sys.inputs.len()是 0)。- 要让数据看到你的东西,用
scope:显式递过去。 s4 里secret通过scope: (secret: secret)才可见。这也解释了为什么cv.typ里的rich只用eval(v, mode: "markup")就够了:简历字符串里只会出现标准库函数(emph、link、数学式),不需要引用模板里的任何名字。 eval里的文件读取仍然可用。 s5 里read("s1.typ")读到了文件内容。路径相对调用eval的那个文件,这一点我也验证了:把eval放在sub/m.typ里的函数中,主文件调用它去读h.txt,读到的是sub/h.txt(内容in-sub),不是根目录那份h.txt(内容in-root)。- 越出项目根的路径被拒绝。 s6 明确报
would escape the project root,和--root的行为是同一套。
风险:别 eval 不是你写的字符串
由此产生的结论很直接:eval 的字符串等同于你文档里的源码,权限也等同。s5 说明它能读项目根下的任何文件,读出来的内容可以直接排进 PDF;#import、#read、yaml(...) 都是可用的。如果 YAML 来自别人(比如网页表单收集的简历数据,再由服务端调 typst compile),不要对它 eval,要么把字段当纯文本直接 [#field],要么限制成一个小的、自己写的标记子集。我实测的只有上面几条(读根内文件、不能越根);至于它能不能被拿来拖死编译,我没有试。顺带一个实测的小保护:eval("#while true {}", mode: "markup") 会被编译器在静态阶段拒绝(error: condition is always true),但这只拦得住最明显的写法,不要把它当防线。
我在 cv.typ 里仍然用了 eval,是因为 cv.yaml 是我自己写的、放在自己的仓库里,信任边界和 .typ 文件一样。
还有一个很实际的体验:YAML 里的标记写错了,错误指向的是 eval 的那一行而不是 YAML 里的那一行。我把 bullet: "提升 *3 倍。"(星号没闭合)放进 bad.yaml 再 eval(d.bullet, mode: "markup"):
error: unclosed delimiter ┌─ bad.typ:2:6 │2 │ #eval(d.bullet, mode: "markup") │ ^^^^^^^^所以 cv.yaml 变长以后,出错时要靠 unclosed delimiter 这类描述自己去 YAML 里找。不 eval 的话(只是 #d.bullet 原样显示)同一个字符串编译完全没事。
datetime 与 duration
简历里的日期是 "2021-09" 这样的字符串,显示成 2021.09,进行中的显示 至今。这里为什么不直接把字符串拼起来?因为一旦用 datetime 表示,日期的格式、先后比较、差值就都能交给 Typst。lab/ch11/datetime.typ 把相关用法过了一遍(源文件):
// datetime and duration: construction, display, arithmetic.#let d = datetime(year: 2026, month: 11, day: 2)#assert.eq(d.weekday(), 1) // Monday#assert.eq(d.ordinal(), 306)#assert.eq(d.display("[year]-[month]-[day]"), "2026-11-02")
// Dates subtract into durations; durations add back.#let span = datetime(year: 2026, month: 12, day: 25) - d#assert.eq(span.days(), 53)#assert.eq((d + duration(days: 30)).month(), 12)
// Time-only values and offsets in display strings.#let t = datetime(hour: 9, minute: 5, second: 0)#assert.eq(t.display("[hour]:[minute]"), "09:05")
// datetime.today() changes daily: never assert on it.= Dates- due: #d.display("[year] 年 [month padding:none] 月 [day padding:none] 日")- days until Christmas: #span.days()- today has year >= 2026: #(datetime.today().year() >= 2026)这个文件的输出(pdftotext 读出):
Dates• due: 2026 年 11 月 2 日• days until Christmas: 53• today has year >= 2026: true- 构造。
datetime(year:, month:, day:)是日期,datetime(hour:, minute:, second:)是时刻,两组都给就是日期时间。日期的星期(weekday(),周一为 1)、一年中第几天(ordinal())是方法。 - 显示。
display接受方括号格式串。[month]默认补零成两位,这就是2021.09的来源;[month padding:none]去掉补零,9 月显示成9而不是09(我用datetime(year: 2026, month: 9, day: 3)试过)。page.typ里title-block的中文日期用的就是上面due那一行的格式串。 - 算术。 两个
datetime相减得到duration,duration有.days()、.hours()、.weeks()等方法;duration(days: 30)加到日期上得到新日期。上面 2026-11-02 到 2026-12-25 是 53 天。duration能按周、日、时等构造,没有“月”:我试了duration(months: 1),Typst 报unexpected argument: months(我猜是因为月的长度不固定)。cv里的2021.09–2025.06因此是两个日期分别格式化再拼,不是算差值。 datetime.today()。 每天都变,所以只能展示不能断言。顺带一个坑:仓库的flake.nix在nix develop的 shell 钩子里执行了unset SOURCE_DATE_EPOCH,原因是否则 nix shell 里的datetime.today()会是 1980-01-01(这个现象我这次没有重新验证)。
src/cv.typ 全文
113 行,我分四段贴,段与段首尾相接,合起来就是 src/cv.typ(源文件)。
两个字段解析函数
// One-page CV generated from a dictionary (see examples/cv/cv.yaml).#import "cjk.typ": xuan-cjk#import "fonts.typ": fonts
// Resolve a field: plain value, or (zh: ..., en: ...) by language.#let tr(field, lang) = { if type(field) == dictionary and (lang in field) { field.at(lang) } else { field }}
// Strings may carry markup, e.g. "*bold* and #link(...)".#let rich(field, lang) = { let v = tr(field, lang) if type(v) == str { eval(v, mode: "markup") } else { v }}tr 做的是“按语言取值”:如果字段是字典并且含有当前语言这个键,取出来;否则原样返回。lang in field 对字典是测试键。这两个条件合在一起,让纯字符串(如 email)和 {zh:, en:} 都走同一个调用。字典里没有当前语言时它会原样返回整个字典,所以 cv 才需要在入口先 assert 语言合法。
rich 在 tr 之后再判一次类型:只有字符串才 eval,已经是 content 的(比如 link(...))就不动。这条类型判断保证 rich 对任何字段都安全。模块里的 tr 和第 8 篇 math.typ 导出的 tr(矩阵迹)重名,但 lib.typ 只导出 cv,所以不冲突。
日期与版式小函数
// "2023-09" -> datetime; "present" -> none.#let parse-month(s) = { if s == "present" { return none } let (y, m) = s.split("-").map(int) datetime(year: y, month: m, day: 1)}
#let fmt-month(s, lang) = { let d = parse-month(s) if d == none { if lang == "zh" { "至今" } else { "Present" } } else { d.display("[year].[month]") }}
#let date-range(item, lang) = { fmt-month(item.start, lang) + "–" + fmt-month(item.end, lang)}
#let section(title) = { v(0.6em) text(weight: "bold", size: 1.1em, title) v(-0.5em) line(length: 100%, stroke: 0.5pt) v(-0.2em)}
// Left: title and role; right: dates.#let entry(left, right, body: none) = { grid( columns: (1fr, auto), left, right, ) if body != none { body }}parse-month 是这一篇最典型的“把字符串提升成类型”:s.split("-").map(int) 得到 (2021, 9),let (y, m) = ... 解构(第 2 篇),day: 1 是因为 datetime 需要一个完整的日期,简历只关心年月。"present" 直接返回 none,fmt-month 再据此显示 至今 / Present。把 "present" 约定成一个关键字而不是写 至今,让 YAML 里的这个字段也不必分语言。
section 里两个负的 v(...) 是把标题和横线收紧,具体数值是仓库里现成的取值,我没有逐个调整来验证它们各自的效果。entry 是两栏 grid,1fr 给标题,auto 给日期,日期因此总是贴右;body: none 的默认值加上 if body != none { body } 让没有正文的条目不多出空白。
bullets 与 set 的作用域
#let bullets(items, lang) = { set par(first-line-indent: 0pt, justify: false) list(..items.map(b => rich(b, lang)))}bullets 里的 set par(...) 只在这个函数体内有效(第 4 篇:作用域是代码块的边界)。xuan-cjk 给中文段落设了两字缩进和两端对齐,对列表项都不合适,所以在这里局部关掉。list(..items.map(...)) 把数组展开成 list 的位置参数,每个元素就是一条列表项,这是第 3 篇 ..args 的反向用法(调用端展开)。
cv 本体
#let cv(data, lang: "zh") = { assert(lang in ("zh", "en"), message: "xuan: cv lang must be zh or en") let t(field) = tr(field, lang) let zh = lang == "zh" set document(title: t(data.name) + " CV", author: t(data.name)) set page(paper: "a4", margin: (x: 1.8cm, y: 1.5cm)) show: xuan-cjk.with(lang: lang) set text(size: 10pt) set par(first-line-indent: 0pt, leading: 0.6em, spacing: 0.7em) set list(indent: 0.5em, spacing: 0.5em)
align(center)[ #text(size: 22pt, weight: "bold", font: fonts.sans, t(data.name)) #v(-0.2em) #( link("mailto:" + data.email, data.email), data.phone, link("https://" + data.github, data.github), link("https://" + data.site, data.site), ).join(h(1em) + "|" + h(1em)) ]
section(if zh { "教育经历" } else { "Education" }) for e in data.education { entry( [*#t(e.school)*, #t(e.degree)], date-range(e, lang), body: if "detail" in e { rich(e.detail, lang) }, ) }
section(if zh { "实习经历" } else { "Experience" }) for e in data.experience { entry( [*#t(e.org)*, #emph(t(e.role))], date-range(e, lang), body: bullets(e.bullets.map(t), lang), ) }
section(if zh { "项目经历" } else { "Projects" }) for e in data.projects { entry( [*#t(e.name)*, #emph(t(e.role))], date-range(e, lang), body: bullets(e.bullets.map(t), lang), ) }
section(if zh { "技能" } else { "Skills" }) for s in data.skills { [*#t(s.label)*#if zh [:] else [: ]#rich(s.items, lang) \ ] }}几个值得说的设计选择:
cv 是一个普通函数调用,不是 show: 模板。 第 4 篇的 note 接收一个 body 并用 #show: note.with(...) 套在整篇文档上,因为正文是你写的。简历没有正文,输入是一份字典,所以 #cv(yaml("cv.yaml"), lang: lang) 直接生成整页内容。它仍然用 set page、show: xuan-cjk.with(lang: lang),这些规则落在 cv 的函数体作用域里,调用一次页面就配好一次。
let t(field) = tr(field, lang) 是闭包。 t 捕获了外层的 lang,后面一百多处调用不用再传。这是第 3 篇讲过的闭包捕获;e.bullets.map(t) 里直接把 t 当参数传给 map,也是同一个原因。bullets(...) 之前先把每条 {zh:, en:} 变成字符串,rich 之后再 eval,顺序不能反。
联系方式只拼字符串,不 eval。 email、phone、github、site 都是普通字符串,直接放进 link(...)。邮箱、电话这类字段没有需要格式化的内容,不让它们过 eval 就少一处可能被标记语法误读的地方(这一点是设计上的保守,我没有构造出具体的误读例子)。.join(h(1em) + "|" + h(1em)) 把四个内容用竖线隔开,竖线两侧各 1em 的水平空白。
set document 写入 PDF 元数据。 我用 pdfinfo out/examples/cv.pdf 看了:
Title: 张三 CVAuthor: 张三英文版则是 Zhang San CV 和 Zhang San。第 16 篇再展开 document 的更多字段。
可选字段用 "detail" in e 判断。 教育条目有 detail,实习条目没有。字典的 in 测试键,body: if "detail" in e { rich(...) } 在条件不成立时整个 if 得到 none(没有 else 的 if 就是这样),正好是 entry 参数 body 的默认值。
技能一节的 \。 [*#t(s.label)*#if zh [:] else [: ]#rich(s.items, lang) \ ] 是一行内容块:粗体标签,中文用全角冒号、英文用半角冒号加空格,然后是 rich 出来的条目,最后用 \ 强制换行。中英文冒号不同,所以用 if zh 在内容里分叉。
编译时间与页数
页数前面已经给过:中英文各 1 页,A4 尺寸(pdfinfo 显示 595.276 x 841.89 pts)。时间我用 hyperfine -N,让它直接启动命令而不经过 shell,预热 3 次,各跑 30 次:
$ hyperfine -N --warmup 3 --runs 30 "typst compile --root . --ignore-system-fonts examples/cv/main.typ /tmp/p11/cv-zh.pdf" "typst compile --root . --ignore-system-fonts --input lang=en examples/cv/main.typ /tmp/p11/cv-en.pdf"Benchmark 1: typst compile --root . --ignore-system-fonts examples/cv/main.typ /tmp/p11/cv-zh.pdf Time (mean ± σ): 153.8 ms ± 2.7 ms [User: 56.2 ms, System: 99.9 ms] Range (min … max): 149.0 ms … 159.2 ms 30 runs
Benchmark 2: typst compile --root . --ignore-system-fonts --input lang=en examples/cv/main.typ /tmp/p11/cv-en.pdf Time (mean ± σ): 153.5 ms ± 7.2 ms [User: 52.4 ms, System: 103.1 ms] Range (min … max): 145.0 ms … 182.7 ms 30 runs
Warning: Statistical outliers were detected. Consider re-running this benchmark on a quiet system without any interferences from other programs. It might help to use the '--warmup' or '--prepare' options.
Summary typst compile --root . --ignore-system-fonts --input lang=en examples/cv/main.typ /tmp/p11/cv-en.pdf ran 1.00 ± 0.05 times faster than typst compile --root . --ignore-system-fonts examples/cv/main.typ /tmp/p11/cv-zh.pdf中文版 153.8 ms,英文版 153.5 ms,两者在噪声之内分不开。用户态时间只有 56 ms,系统态却有 100 ms 上下:绝大部分时间不在排版,我猜是在读那几个很大的 CJK 可变字体文件,这没有拆开验证。
第 1 篇的基准是另一份 9 页文档,用的是另一个 CJK 字体,数字(226.1 ms)不能直接和这里比。
往下一步走
这一篇的模式,数据在文件里,版式在函数里,参数从命令行进来,是整个 xuan 里最容易复用的一个。你可以现在就试两件事:把 cv.yaml 里的 start、end 改成别的月份,看日期显示怎么变;或者给 cv.yaml 加一个新的 awards 小节,同时在 cv.typ 里加一个 section 和一个 for 循环,这就是自己动手把简历模板变成你的模板。如果要真的把一份简历发给别人,别忘了把 examples/cv/cv.yaml 里的联系方式换成你自己的。
下一篇是同一个套路,只是参数换成了“是否显示解答”:--input solutions=false 经 sys.inputs 读进来,存进一个 state,同一份作业源码就能出带解答和不带解答两个 PDF。多文件的 import 和 include、0.15 的 path 类型也在那里:第 12 篇。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!