
 Better Mistakes



音乐
暂未播放
操作系统中的进程、线程与协程
“What I cannot create, I do not understand.”(Richard Feynman)
我第一次写这篇笔记,只写到进程。当时我觉得教科书那句”进程是程序的一次执行过程”已经够用了,剩下的都是细节。后来越往下写,问题反而越多:为什么 Python 里开两个线程做同一件 CPU 密集的事,墙钟时间几乎翻倍?为什么 Rust 的 async fn 不接一个运行时根本不会跑?为什么一台机器能用线程扛住几百个连接,却扛不住十万个?
这些问题最后收敛到同一组东西上:一个并发实体的状态存在哪里,谁在调度它,切换一次要花多少。进程、线程、协程,本质上是这个问题在三个不同成本档位上的答案。这篇文章就按这三层走,每层都用 C/C++、Python、Rust 各写一遍,并把本机的实测数字贴出来。我不想只复述定义,我想把每层的”账单”算给你看。
先交代测量环境
后面所有数字都来自同一台机器,同一份代码,-O2 编译,取多次运行里最好的一次。
| 项目 | 值 |
|---|---|
| 内核 | Linux 6.18.55(x86_64,PREEMPT_DYNAMIC) |
| 逻辑 CPU | 16 |
| C / C++ | gcc / g++ 15.3.0 |
| Python | CPython 3.14.7(非自由线程构建,带 GIL) |
| Rust | rustc 1.95.0(edition 2024) |
时钟分辨率、调度抖动、CPU 频率都会影响微基准,所以下面的数字请当作量级参考,而不是绝对真理。复现命令和完整代码在文末。
一、进程:把一台机器虚拟成很多台
要讲清楚进程,得先讲清楚它替谁擦屁股。进程这个概念不是被设计出来的,是被两个速度差逼出来的:人的速度 对 CPU 的速度,以及 I/O 的速度 对 CPU 的速度。
0. 史前时代:硬件即程序
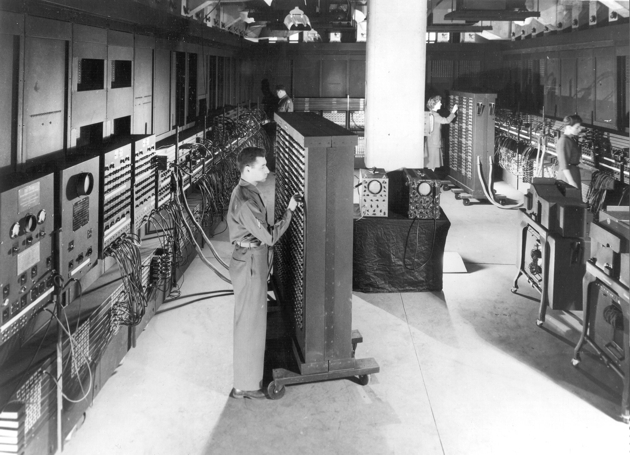
在进程出现之前,计算机里没有”软件”和”硬件”的清楚界限。代表是 ENIAC(Electronic Numerical Integrator and Computer):占地 167 平方米,重 27 吨,同一时间只能解决一个问题。
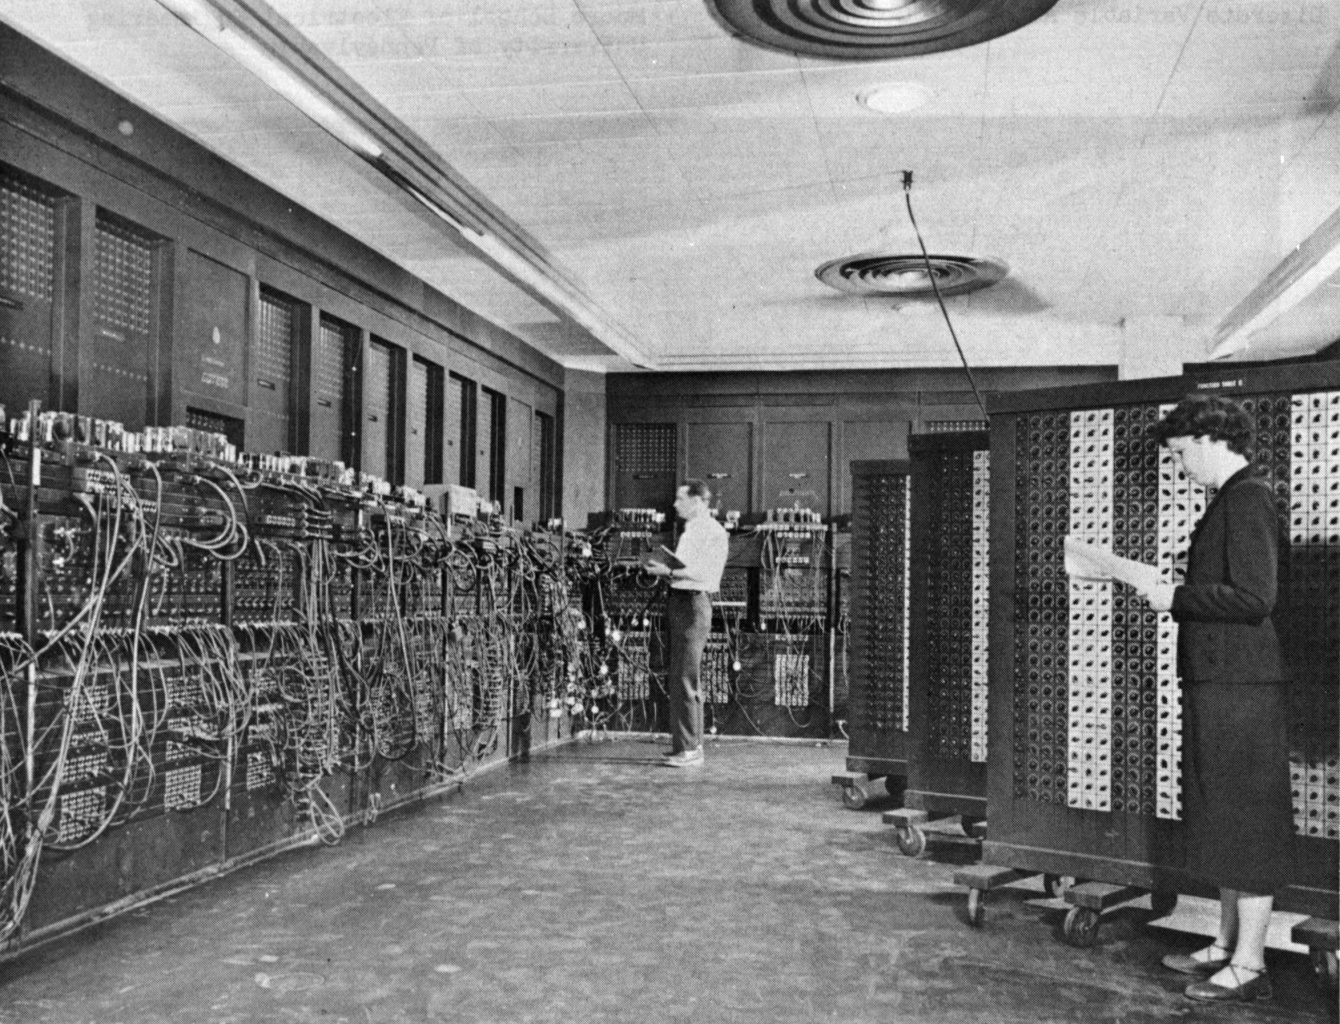
在 ENIAC 上”切换任务”不是双击图标,而是体力活。程序员(当时多为女性数学家)拿着粗大的连接线在配线板上物理接线,每一个插孔、每一排开关都对应一段逻辑。接好线,这台机器就变成解那个特定方程的专用电路。
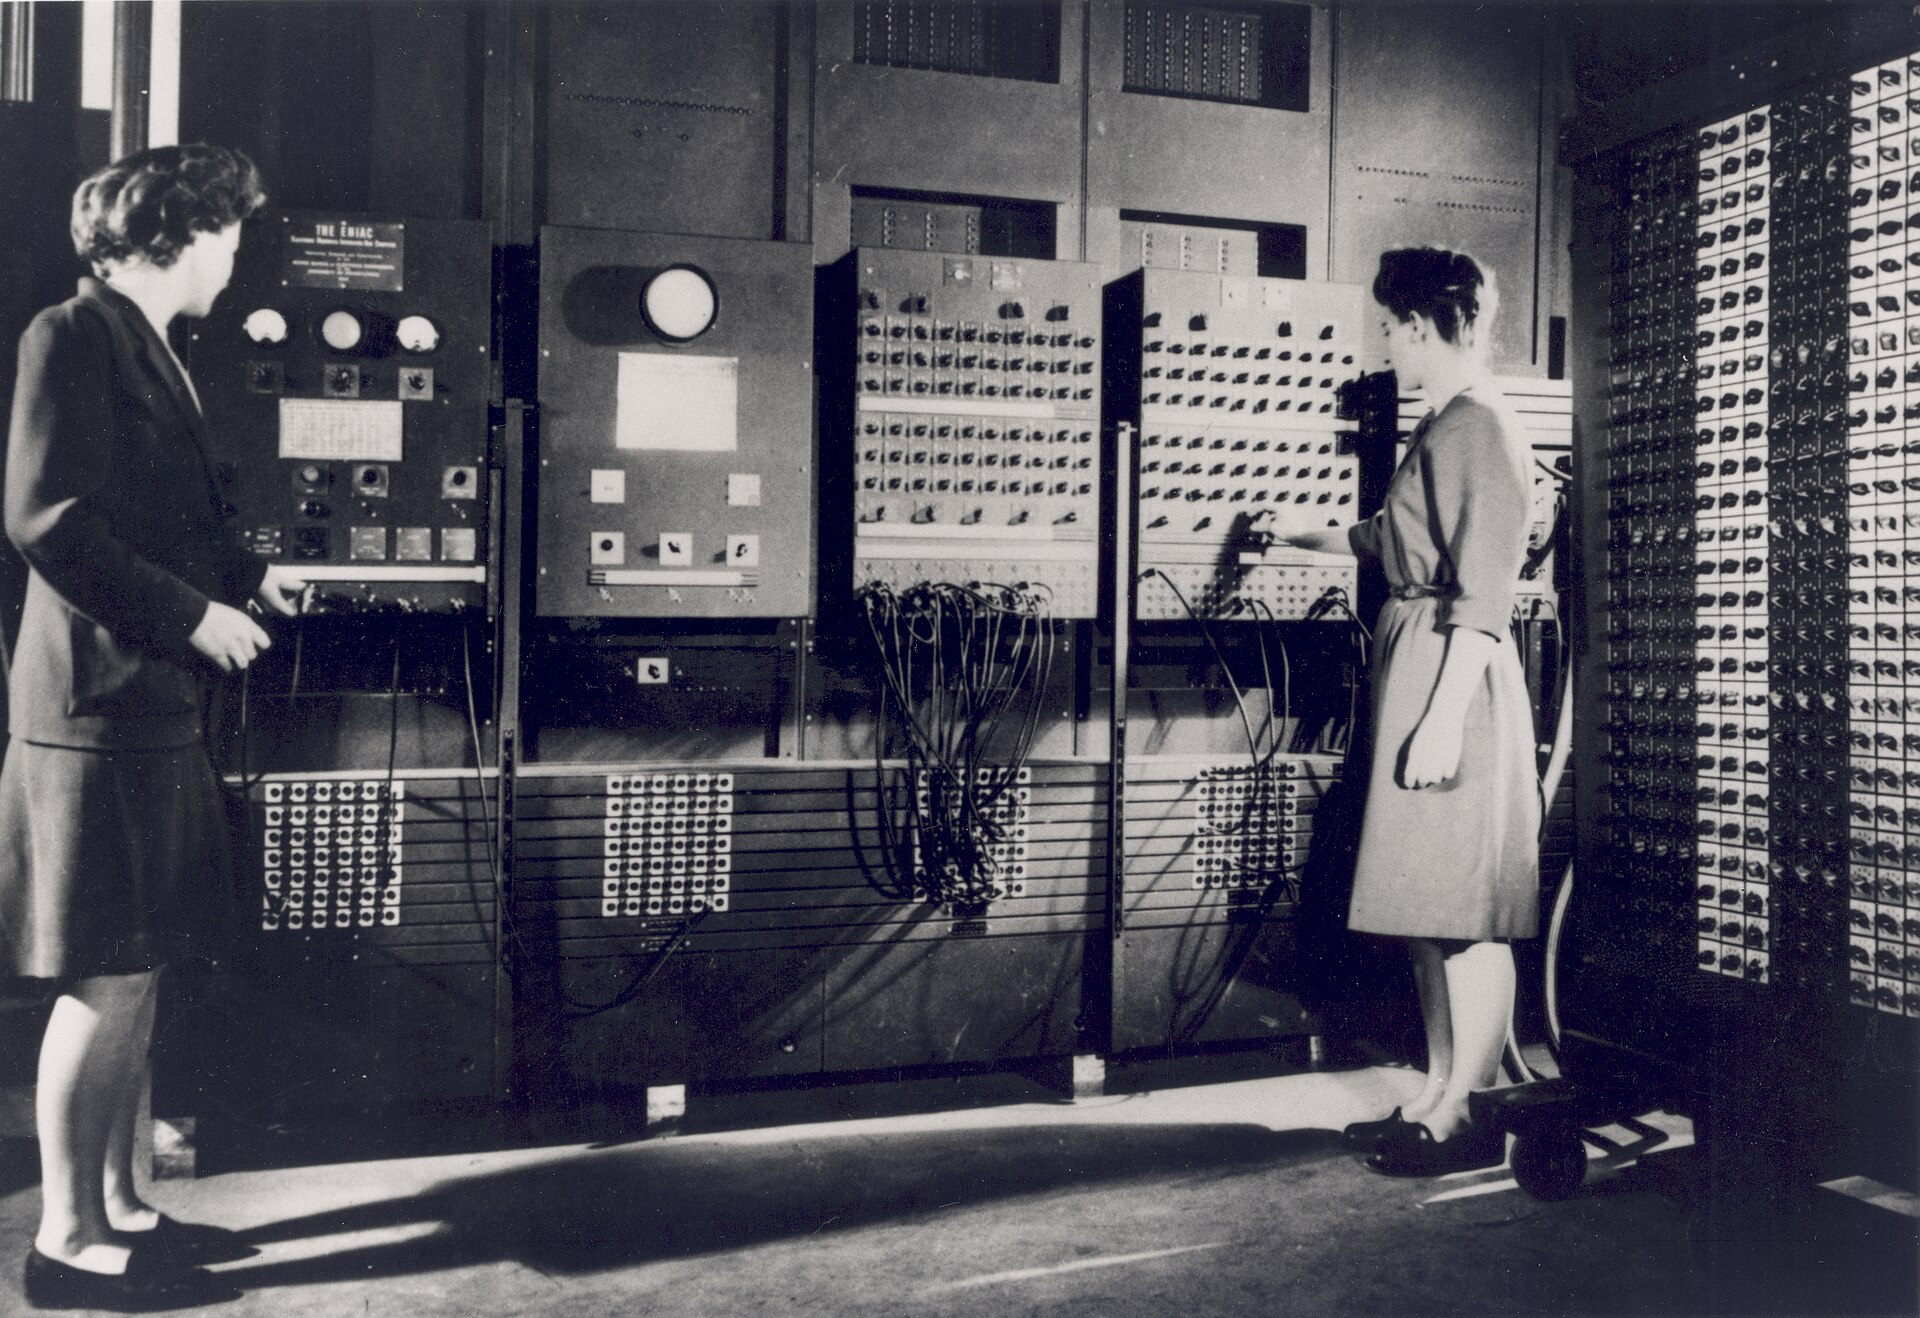
它每秒能做 5000 次加法,而”准备一次计算”要花几分钟到几小时。正是这个极高的计算速度和极低的任务切换效率之间的鸿沟,推着计算机往前走。
这种”接线即编程”的思路今天还在:FPGA 做的事,本质就是给一段逻辑烧出一个专用电路。
1. 批处理:把人的延迟消掉
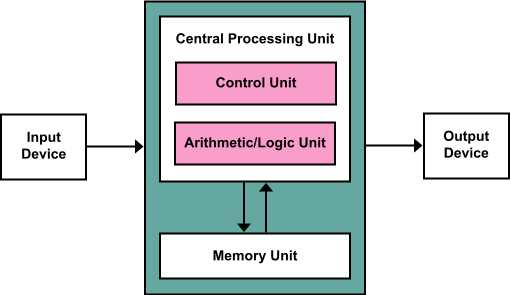
1945 年,von Neumann 在《First Draft of a Report on the EDVAC》里确立了存储程序架构,程序终于变成躺在磁带上的指令,不再需要物理插拔线缆。
但早期的 Open Shop 模式还是人主导:程序员带着磁带进机房,装带、运行、卸带、走人,下一个人再进来。CPU 每秒能跑几万条指令,而人装一次磁带要几分钟。让这么快的 CPU 停下来等人,是极大的浪费。
于是出现了 Resident Monitor 这种常驻内存的小程序,它负责:读下一个作业(Job)、装载、运行、收回控制权、再读下一个。1956 年通用汽车为 IBM 704 写的 GM-NAA I/O 通常被认为是第一个真正意义上的操作系统。
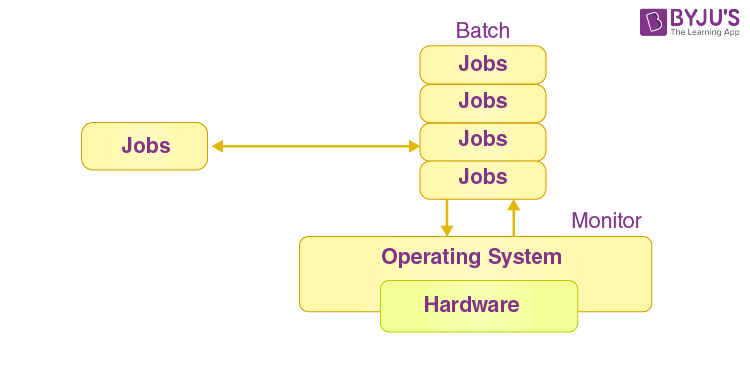
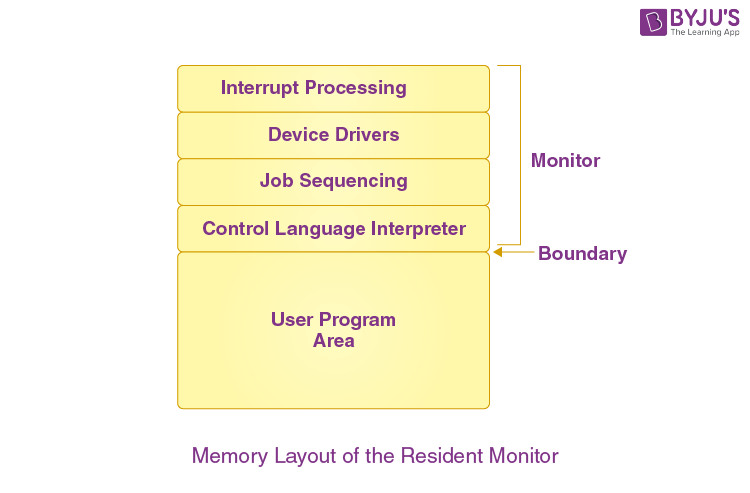
注意,这个阶段还没有进程,只有作业,而且内存里一次仍然只住一个程序。
2. 多道程序设计:把 I/O 的延迟消掉
批处理解决了人的问题,没解决硬件的问题。程序要读磁带或磁盘时,机械设备的延迟比 CPU 慢好几个数量级(毫秒对微秒)。CPU 只能干等。
工程师的答案很直接:既然内存变大了,为什么不同时装好几个作业?
- Job A 在等磁带(阻塞)时,把 CPU 切给 Job B;
- Job B 在等打印机时,再切给 Job C。
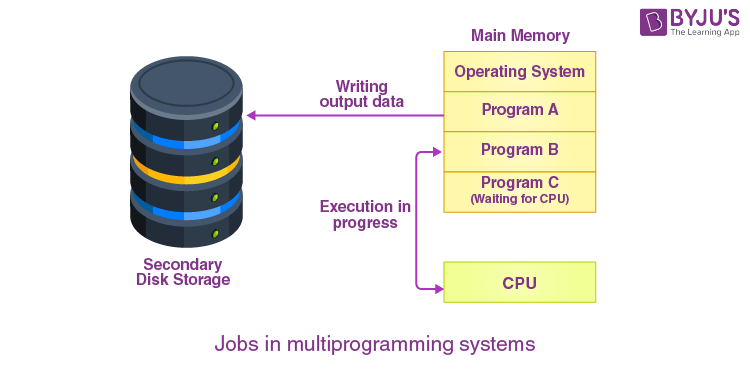
IBM 在 System/360 上大力推行这个概念,也是在这里,计算机科学迎来一个关键转折:为了在多个程序之间来回切,必须保存每个程序的状态。
OS/360 里出现了描述任务状态的数据结构 TCB(Task Control Block),它是后来 PCB(Process Control Block)的前身:
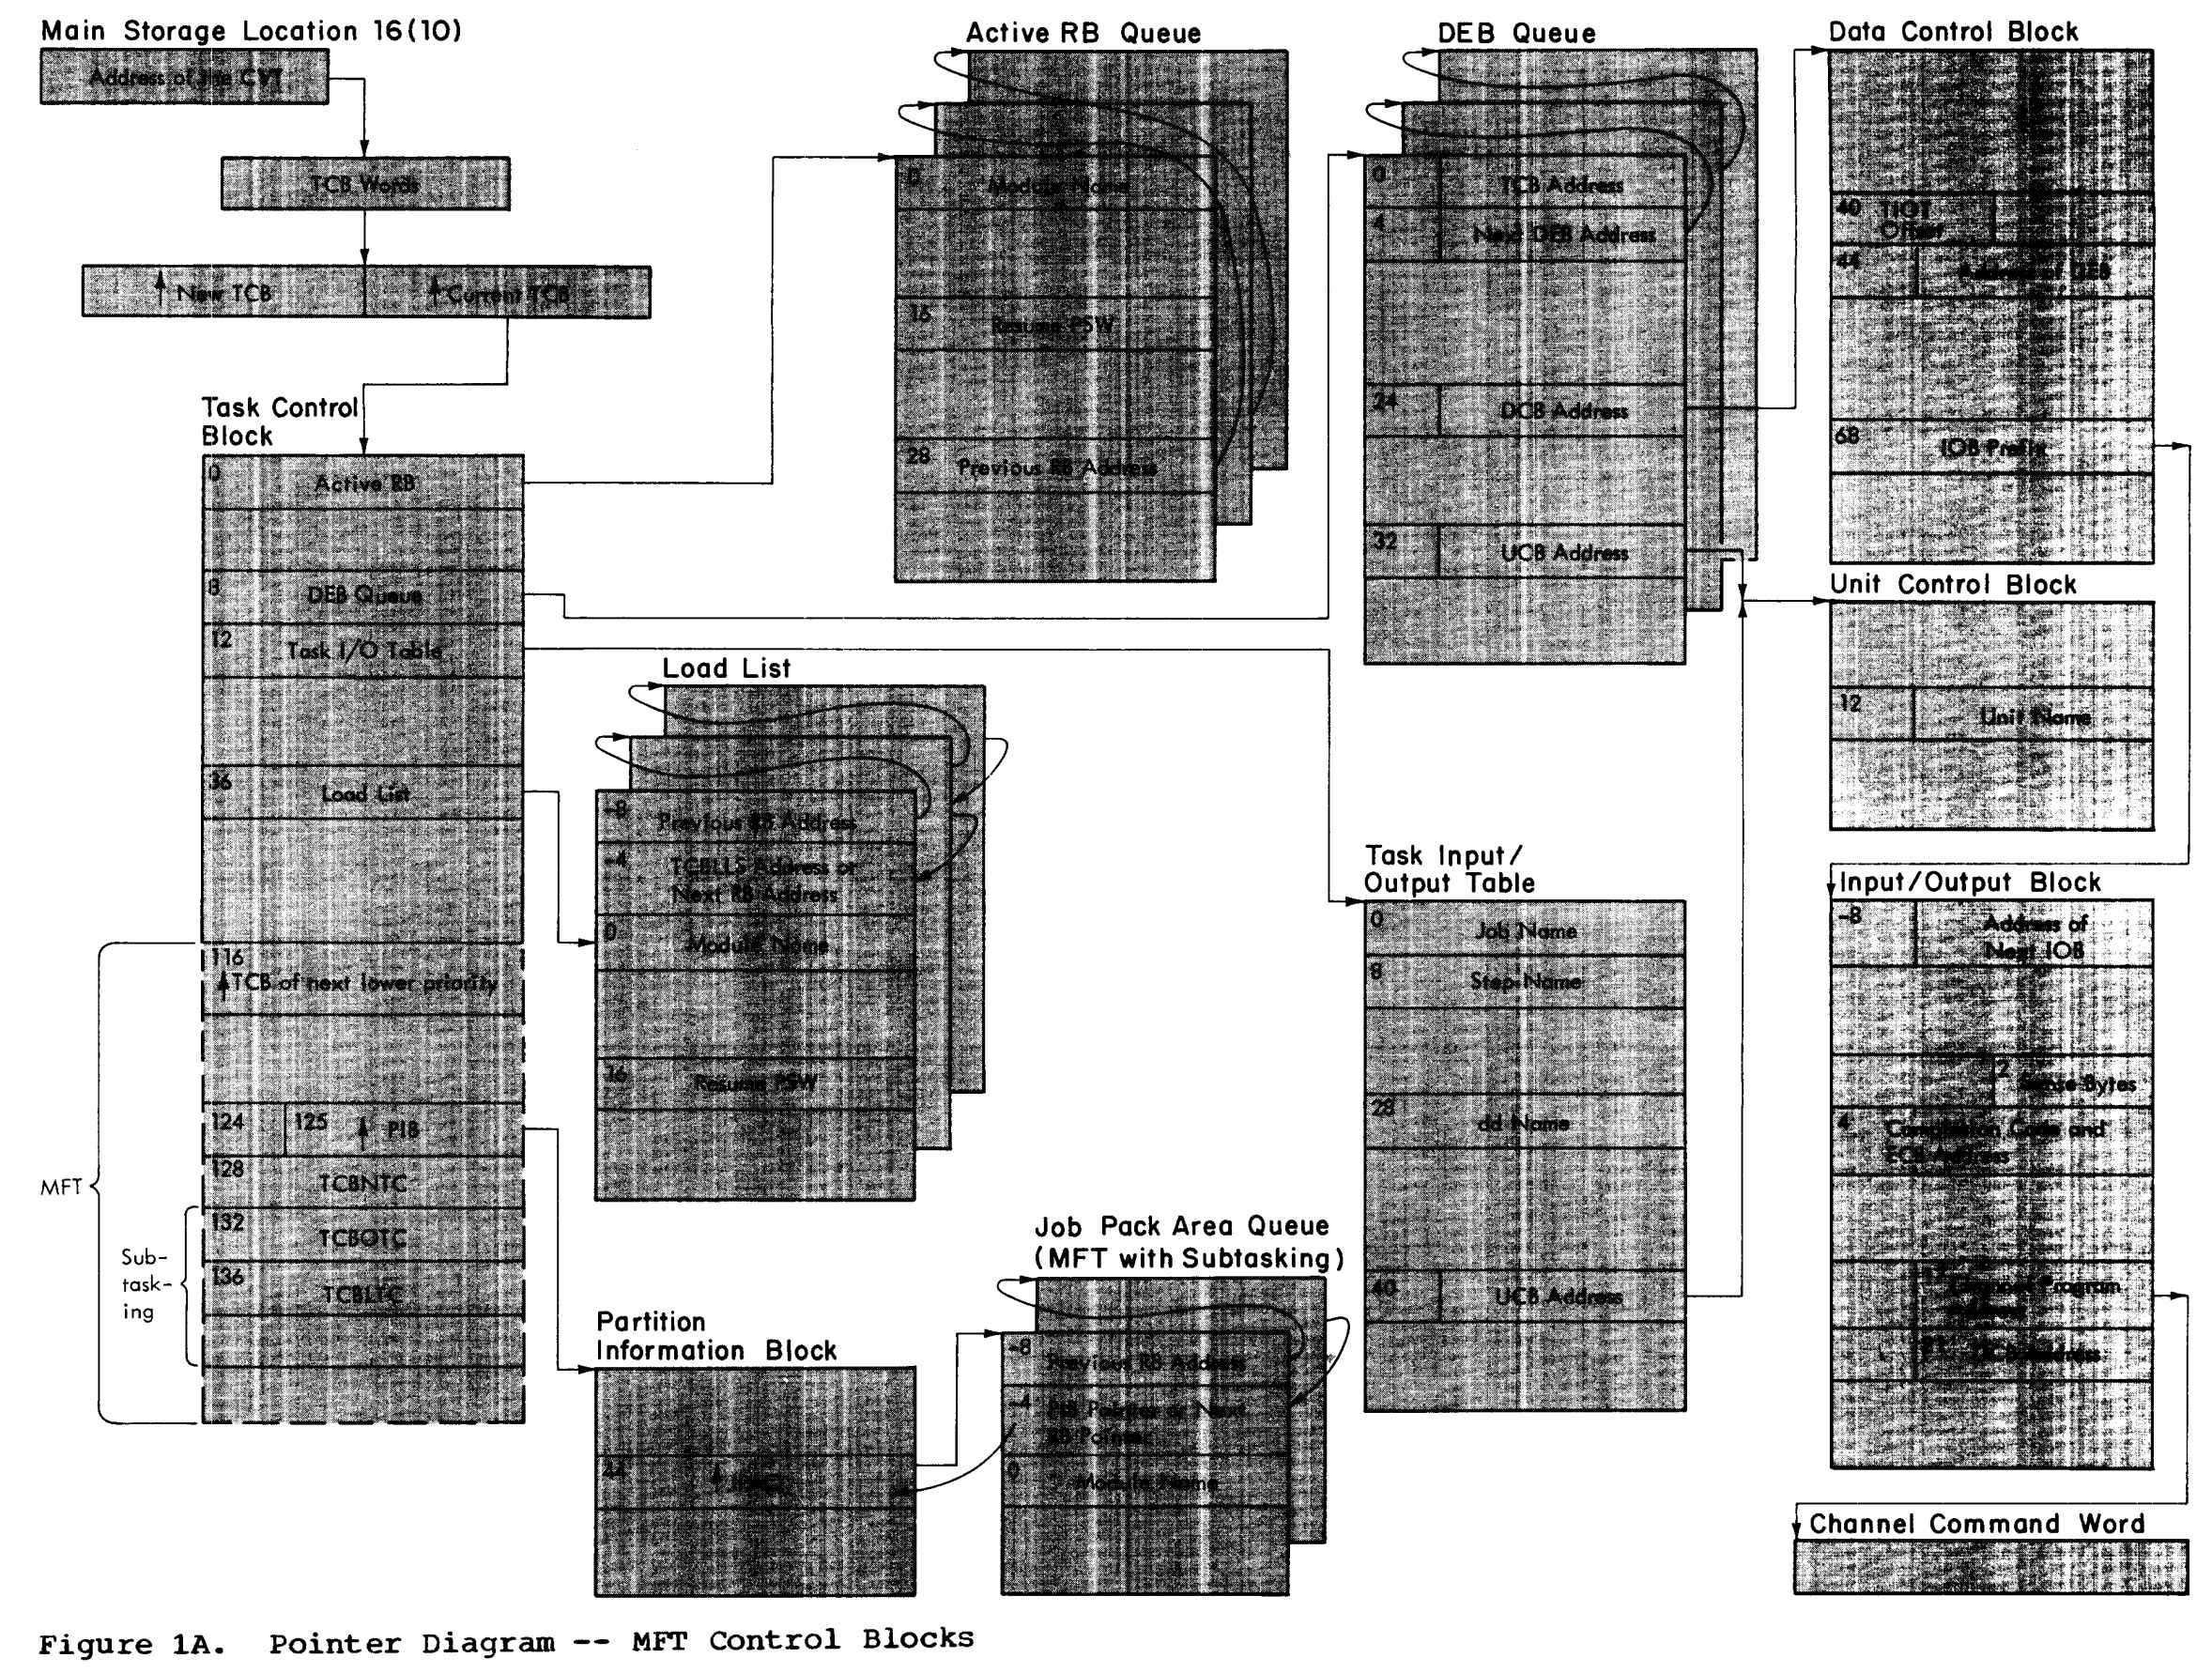
TCB 主要做两件事:
- 现场保护:CPU 从 A 切到 B 时,A 的寄存器(算到一半的结果、程序计数器 PC、栈指针 SP 等)必须存进 TCB。因为物理寄存器只有一套,不存就丢了。
- 状态标记:系统要记录谁在 Running、谁在 Waiting、谁 Ready。
3. 分时:把响应时间消掉,进程正式诞生
到 60 年代末,用户开始通过终端和机器交互。如果沿用多道程序的逻辑(只有 I/O 阻塞才切),一个 while(1) 死循环就能永远霸占 CPU,终端前的其他人敲键盘毫无反应。
MIT、贝尔实验室和通用电气联合做的 Multics 引入了硬件定时器,这一改变是革命性的:
- 抢占式调度:无论程序 A 有没有跑完,每隔几十毫秒(一个时间片)操作系统强制打断它,保存上下文,把 CPU 交给 B;
- 幻觉:快速切换让每个用户都以为自己独占了一台电脑。
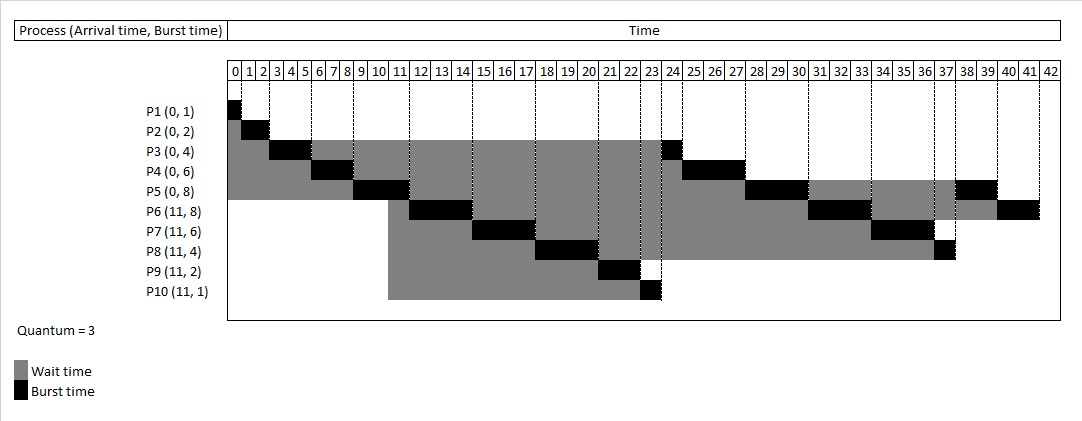
也就是在这个时期,进程被正式确立,并赋予了现代含义。为了维持”独占”的幻觉,操作系统筑起了两道墙:
- 时间的虚拟化:保存 / 恢复寄存器上下文,让每个进程觉得拥有独立的 CPU;
- 空间的虚拟化:用 MMU 和页表,让每个进程觉得拥有独立、连续的内存空间。
至此,进程不再只是用户的代码,它是:
代码 + 动态执行上下文(某一时刻寄存器里的值)+ 虚拟地址空间
这就是为什么”程序的一次执行”这种定义是对的但没用:真正的问题在于”执行上下文存在哪”和”地址空间怎么隔离”。
二、进程里到底有什么
虚拟地址空间:进程看到的世界
每个进程都以为自己独占一整块连续的虚拟内存。它的典型布局是这样的:
几个容易踩的点:
- 栈向下长,堆向上长,中间留一大片空洞按需分配。栈溢出和堆撞栈是两种不同的错误。
- 内核空间也映射在每个进程里(高地址区),但在用户态不可访问;进入内核靠系统调用切换特权级。
- 地址是虚拟的。同一个虚拟地址
0x400000,在两个进程里可能落在完全不同的物理页上。
那隔离是怎么做到的?答案是页表加 MMU:
写坏自己的进程碰不到别人,靠的不是”约定”,而是硬件每次访存都会查页表。
想亲眼看,可以跑 cat /proc/self/maps 和 cat /proc/self/status,前者是虚拟地址空间的条目,后者里的 VmSize / VmRSS 是虚拟和常驻的大小。
内核眼里的进程:PCB 与上下文切换
用户看到的是地址空间,内核看到的是数据结构。Linux 里这个结构叫 task_struct,一个进程对应一个任务。它记录着 pid、状态、打开的文件、信号、以及最重要的:寄存器现场。
关键事实是:CPU 只有一套寄存器。所以”切换进程”这件事,物理上就是”把当前寄存器存进一个结构,再从另一个结构装载寄存器”:
进程切换比”存寄存器”还要多一步:如果换的是进程而不是线程,还得切换 CR3(页表基址),也就是换掉整个地址空间。换地址空间会带来 TLB 失效的连带成本,这是进程切换比线程切换贵的一个主要原因。
进程在这几个状态之间来回走:
进程有多贵(实测)
| 操作 | 实测 |
|---|---|
fork() + 子进程退出 + wait() | 173 µs |
| 内核进程间切换(管道往返折算,含系统调用) | 2.81 µs |
这两个数是这样量出来的:fork 用”创建 + 回收”整个循环除以次数;线程 / 进程间的切换用 lmbench 式管道往返,两个执行流绑在同一个核上,来回传一个字节,一次往返除以 2:
/* 单调时钟,返回秒 */static double now(void){ struct timespec ts; clock_gettime(CLOCK_MONOTONIC, &ts); return (double)ts.tv_sec + (double)ts.tv_nsec * 1e-9;}
/* fork + 子进程退出 + wait,除以次数 */static double bench_fork(int n){ double t0 = now(); for (int i = 0; i < n; i++) { pid_t p = fork(); if (p == 0) _exit(0); int st; waitpid(p, &st, 0); } return (now() - t0) / n;}
/* 两个线程绑到同一个核,用两条管道来回传一个字节 */static double bench_pp_thread(long n){ if (pipe(pp_a) || pipe(pp_b)) { perror("pipe"); exit(1); } pp_n = n; pthread_t t; pthread_create(&t, NULL, pp_peer, NULL); pin0(); /* 把自己也绑到 0 号核 */ char c = 'x'; double t0 = now(); for (long i = 0; i < n; i++) { if (write(pp_a[1], &c, 1) != 1) break; if (read(pp_b[0], &c, 1) != 1) break; } double dt = now() - t0; pthread_join(t, NULL); return dt / n / 2.0; /* 一次往返 = 两次切换 */}进程间的版本只是把 pthread_create 换成 fork,其余一样(pin0 / pp_peer 等辅助函数见附录 A 的完整程序)。量出来的是”切换 + 系统调用”的总和,所以它是内核切换成本的一个上界。
fork 贵有它的道理:内核要新建一个 task_struct、复制页表(页本身靠写时复制 COW 共享)、分配内核栈、复制一堆文件描述符。所以”创建一个进程”这个动作,本身就是一笔不小的开销。
这里要澄清一个常见误解:同一台机器上,进程间切换(2.81 µs)和线程间切换(2.69 µs)差得并不多。真正贵的不是”切”,而是”建”和”销毁”,以及切换时换地址空间带来的间接代价。
C:fork 的地址空间隔离
亲手摸一下隔离到底是什么意思:
#include <stdio.h>#include <sys/wait.h>#include <unistd.h>
int main(void){ int x = 1; printf("fork 之前: x=%d, pid=%d\n", x, getpid()); fflush(stdout); pid_t p = fork(); if (p == 0) { x = 42; printf("子进程里: x=%d, pid=%d\n", x, getpid()); fflush(stdout); _exit(0); } wait(NULL); printf("父进程里: x=%d, pid=%d\n", x, getpid()); return 0;}输出:
fork 之前: x=1, pid=258617子进程里: x=42, pid=258618父进程里: x=1, pid=258617子进程改的 x 对父进程毫无影响,因为它俩各有一份独立地址空间。这就是为什么进程间通信必须走管道、共享内存、socket 这些显式的 IPC 机制。
示例里我加了 fflush,否则子进程 _exit 会丢掉标准输出缓冲区里的内容。这个坑本身就很”进程”:缓冲区是进程私有状态的一部分。
Python:要真并行,得开进程
CPython 有 GIL(后面细讲),所以想要 CPU 并行只能开进程。用一个纯 Python 的 CPU 密集函数量一下:
def burn(n: int) -> int: s = 0 for i in range(n): s += i * i return s
N: int = 20_000_000| 方式 | 墙钟时间 | 相对单线程加速 |
|---|---|---|
| 1 个线程 | 1.060 s | 1.00x |
| 2 个线程 | 2.018 s | 1.05x |
| 2 个进程 | 1.087 s | 1.95x |
两个线程做双倍工作,用了几乎双倍时间(完全没有加速);两个进程接近 1.95x,因为进程有各自独立的解释器和 GIL。
Rust:std::process
Rust 没有魔法,std::process::Command 就是对 fork + exec 的封装。进程的隔离和成本,与 C 完全一样,语言层帮不上忙。Rust 真正有意思的地方在线程和协程,后面再说。
进程的两张账单
总结一下进程:
- 买到的:强隔离(一个进程崩溃不影响另一个)、独立地址空间、独立资源配额。
- 付出的:创建贵(173 µs,比协程 resume 贵约 80000 倍)、切换要换地址空间、通信必须显式 IPC。
如果一个程序内部需要并发,但又不想付这些成本,答案就是线程。
三、线程:共享地址空间的执行流
动机:把”隔离”这份保险退掉
线程的核心思想很朴素:如果一个进程内部的多条执行流本来就要共享数据,那就让它们共享整个地址空间,省掉切换页表和 IPC 拷贝。
线程共享代码、全局变量、堆和打开的文件;每个线程私有栈、寄存器、线程本地存储(TLS)。这带来两个直接结果:
- 好:线程间传数据就像传指针,零拷贝;线程切换不用换
CR3。 - 坏:一个线程写坏地址空间,整个进程一起完蛋;共享数据的读写顺序要靠锁、原子操作或语言规则来管。
Linux 没有单独的”线程”:clone 的两副面孔
这个概念很值得记住:Linux 内核里没有独立的线程概念。进程和线程都是 task_struct,区别只在 clone 系统调用传了哪些标志位。所谓”线程”,只是共享了一大堆东西的 task:
这解释了为什么线程这么”轻”:它不需要复制页表,只需要新建一个 task_struct、分配一个内核栈和用户栈,然后共享父任务的 mm_struct、文件表指针等。
也解释了为什么线程在系统里看起来还是一个个”任务”:
$ ls /proc/258721/task258721 258722 258723 258724一个主线程加三个工作线程,在内核里就是四个 task,各有各的 TID。
线程有多贵(实测)
| 项目 | 实测 |
|---|---|
pthread_create + join(C) | 23.6 µs |
std::thread 创建 + join(C++) | 21.3 µs |
std::thread 创建 + join(Rust) | 36.0 µs |
threading.Thread start + join(Python) | 55.3 µs |
| 内核线程间切换(含系统调用折算) | 2.69 µs |
| 默认线程栈 | 8192 KB |
| 2000 线程时每个线程预留的虚拟内存(C) | 8192 KB |
| 2000 线程时每个线程的常驻内存(C) | 8.0 KB |
| 2000 线程时每个线程预留的虚拟内存(Rust) | 6192 KB |
| 2000 线程时每个线程的常驻内存(Rust) | 9.8 KB |
线程创建用”pthread_create + join 循环除以次数”;线程内存这样量:先读 /proc/self/status,创建 2000 个阻塞在条件变量上的线程,再读一次,差值除以 2000:
/* 从 /proc/self/status 里读一个 KB 单位的字段 */static long vm(const char *field){ FILE *f = fopen("/proc/self/status", "r"); if (!f) return -1; char line[256]; long v = -1; size_t fl = strlen(field); while (fgets(line, sizeof line, f)) { if (!strncmp(line, field, fl)) { sscanf(line + fl, "%ld", &v); break; } } fclose(f); return v;}
int main(void){ int NT = 2000; pthread_t *ts = malloc(sizeof(pthread_t) * NT); long v0 = vm("VmSize:"), r0 = vm("VmRSS:"); /* waiter 阻塞在条件变量上 */ for (int i = 0; i < NT; i++) pthread_create(&ts[i], NULL, waiter, NULL); long v1 = vm("VmSize:"), r1 = vm("VmRSS:"); printf("vm_per_thread_kb,%.1f\n", (double)(v1 - v0) / NT); printf("rss_per_thread_kb,%.1f\n", (double)(r1 - r0) / NT); /* 唤醒 g_go 并 join 所有线程,略 */ return 0;}ps 看不到进程里有多少线程时,直接数 /proc/<pid>/task 目录:一个主线程加三个工作线程,就是四个 task 目录。
注意最后四行:每个 pthread 默认预留 8 MiB 的虚拟地址空间,但真正摸到的常驻内存只有 8 KB 左右。这看起来像是”线程很省”,其实是个陷阱:真正卡住线程数量的是虚拟地址预留 + 内核里每个 task 的结构,不是 RSS。你开不出 100 万个线程,不是因为内存被用光了,而是地址空间和内核结构先撑爆了。
数据竞争:C 里的实测
线程共享内存的直接代价,就是同一份数据可能被两个线程同时读改写。下面这段程序用 4 个线程各把两个全局计数器加 100 万次:
#include <pthread.h>#include <stdatomic.h>#include <stdio.h>
/* volatile 强制每次都读内存、写内存,让读-改-写的窗口暴露出来 */static volatile long plain = 0;static atomic_long atom = 0;
static void *bump_plain(void *a){ (void)a; for (long i = 0; i < 1000000; i++) { long v = plain; plain = v + 1; } return NULL;}
static void *bump_atom(void *a){ (void)a; for (long i = 0; i < 1000000; i++) atomic_fetch_add(&atom, 1); return NULL;}输出(三次运行):
普通全局变量 = 1299722(期望 4000000)普通全局变量 = 1443475(期望 4000000)普通全局变量 = 1365161(期望 4000000)原子变量 = 4000000(期望 4000000)普通变量丢了大约三分之二的更新,因为 plain = v + 1 不是原子的:读和写之间,别的线程可能已经改过了。原子操作把读-改-写变成一个不可分割的动作,才得到正确结果。
这是未定义行为在实践里的样子。更麻烦的是,它往往在开发机上”看起来是对的”,到了生产环境才丢数据。
C++:std::thread 与 std::atomic
C++ 的 std::thread 就是对 pthread 的薄封装,实测 21.3 µs 与 C 的 23.6 µs 基本一致。C++ 真正加的是类型系统和 RAII:
std::jthread(C++20)在析构时自动join,并支持stop_token协作取消,避免忘记 join 导致的terminate;std::atomic<T>把原子操作变成类型,比裸的atomic_long更安全;- 数据竞争在 C++ 里仍然是未定义行为,编译器不会替你检查。
C++ 的并发能力很全,但也意味着它把”要不要加锁”这个判断完全交给你。
Python:GIL 的实测
Python 的线程是货真价实的 OS 线程,但 CPython 的解释器里有一把全局解释器锁(GIL):同一时刻只有一个线程能执行 Python 字节码。它每 5 ms 左右释放一次(实测 sys.getswitchinterval() 返回 0.0050),让别的线程有机会跑。
结果就是前面那张表:两个 CPU 密集型线程毫无加速(1.05x),两个进程才有(1.95x)。
那 Python 线程还有什么用?I/O 密集。当线程卡在 socket.recv()、文件读写这类操作上时,它会释放 GIL,别的线程就能继续跑。所以”下载 100 个文件”用线程池是有效的,而”算 100 万个质数”应该用进程池。
这是 CPython 的实现细节,不是 Python 语言的语义。CPython 3.13 起提供了官方的自由线程(free-threaded)构建,正在逐步弱化 GIL。但本文用的 3.14.7 仍是带 GIL 的常规构建。
Rust:把数据竞争挡在编译期
Rust 的线程创建要 36.0 µs,比 pthread 略贵一点(包装更多)。它真正独特的是 Send / Sync 这两个自动 trait:编译器会检查跨线程传递的类型是否安全,不安全就拒绝编译。
试着把一个 Rc 移进新线程:
use std::rc::Rc;
fn main() { let shared = Rc::new(1); std::thread::spawn(move || { println!("{}", shared); });}编译器直接拦下:
error[E0277]: `Rc<i32>` cannot be sent between threads safely --> demo_rs_send.rs:5:24 |5 | std::thread::spawn(move || { | ------------------ ^------ | | | | | required by a bound introduced by this call6 | | println!("{}", shared);7 | | }); | |_____^ `Rc<i32>` cannot be sent between threads safely | = help: within `{closure@demo_rs_send.rs:5:24: 5:31}`, the trait `Send` is not implemented for `Rc<i32>`note: required because it's used within this closurenote: required by a bound in `spawn`Rc 的引用计数不是原子的,跨线程共享会撕裂计数,所以它没有实现 Send。要用就得换成 Arc(原子引用计数)。这类错误在 C/C++ 里是运行时的数据竞争,在 Rust 里是编译错误。
线程的上限
线程是一个很好的”真并行”工具,但它有三个天花板:
- 一 MiB 级的栈预留,把线程总数卡在几万级;
- 创建和切换都要进内核,切换约 2.7 µs;
- 调度交给内核,你无法决定”先跑哪个就绪线程”。
面对”十万个并发连接”,这三条里的每一条都是致命的。于是有了协程。
四、协程:把”暂停”这件事挪到用户态
先算一笔账
假设要做 10 万个并发连接。用”一个连接一个线程”,光栈的虚拟地址预留就是:
这还没算内核结构。所以线程模型在这种场景下直接出局。这不是”优化一下”能解决的,是模型选错了。
协程的本质:一个可以暂停、之后接着跑的函数
协程(coroutine)的出发点是:大多数连接在绝大多数时间里都在等 I/O,凭什么给它分配一个完整的栈、还让内核来管它?
普通函数只有”调用、返回”两种结局。协程多了一种状态:暂停(suspend),把当前位置和局部状态记住,把控制权交还给调度器;之后恢复(resume),从暂停处继续。因为暂停和恢复都发生在用户态,不需要陷入内核,切换一次只要几十纳秒到几微秒。
两种实现方式:
- 有栈协程(stackful):每个协程自带一段栈,切换就是换栈指针。它可以在任意嵌套调用深处挂起,代价是每个协程要预留栈空间(KB 到 MB 级)。C 的
ucontext、早期的一些库走这条路。 - 无栈协程(stackless):协程是编译器生成的一个状态机,没有自己的栈,局部变量和恢复点打包成一个”帧”放在堆上。它只能在显式的
await/yield处挂起,换来的是帧大小在编译期就确定、可以开到几十万上百万个。C++20 协程、Python 的async、Rust 的async都是这一类。
两层成本对照(实测)
一次切换 / 恢复 / 创建的耗时,横跨六个数量级:
同样的量级差异,也体现在内存上:
这两张图是整篇文章的核心。协程 resume 比内核线程切换便宜约一千倍;而同样开 100 万个,Rust 的 Future 只要 15 MB,OS 线程的栈预留要 8 TiB(直接不可行)。
C:语言里没有协程,就自己造一个
C 语言本身没有协程关键字。要用,就得靠 ucontext(或 setjmp / longjmp、或第三方库)手工实现有栈协程:
#define _XOPEN_SOURCE 700#include <stdio.h>#include <ucontext.h>
static ucontext_t main_ctx, a_ctx, b_ctx;static char stk_a[65536], stk_b[65536];
static void co_a(void){ for (;;) { printf("A"); fflush(stdout); swapcontext(&a_ctx, &main_ctx); /* 暂停 A,回到 main */ }}
static void co_b(void){ for (;;) { printf("B"); fflush(stdout); swapcontext(&b_ctx, &main_ctx); }}
int main(void){ getcontext(&a_ctx); a_ctx.uc_stack.ss_sp = stk_a; a_ctx.uc_stack.ss_size = sizeof stk_a; a_ctx.uc_link = NULL; makecontext(&a_ctx, co_a, 0);
getcontext(&b_ctx); b_ctx.uc_stack.ss_sp = stk_b; b_ctx.uc_stack.ss_size = sizeof stk_b; b_ctx.uc_link = NULL; makecontext(&b_ctx, co_b, 0);
for (int i = 0; i < 4; i++) { swapcontext(&main_ctx, &a_ctx); swapcontext(&main_ctx, &b_ctx); } printf("\n"); return 0;}输出:
ABABABABswapcontext 做的事情,本质上就是”保存当前寄存器到 main_ctx,从 a_ctx 恢复寄存器”,和进程切换的原理一样,只不过全程在用户态,而且切换的是我们自己造的上下文。ucontext 在新版 POSIX 里已经被标记为废弃,但它把”协程”这件事拆得最干净,值得亲手写一遍。
这也是绿色线程(green thread)的基础:在用户态维护一个协程池,再把它们多路复用到少量内核线程上。
C++20:编译器把函数改写成状态机
C++20 引入了语言级协程。它最反直觉的一点是:协程的语义几乎全靠编译器把函数改写成状态机,标准库只提供”搭子”(std::coroutine_handle、std::suspend_always 等)。写一个最小的生成器只需要实现 promise_type:
#include <coroutine>
struct Gen { struct promise_type { int value; std::suspend_always yield_value(int v) { value = v; return {}; } Gen get_return_object() { return Gen{std::coroutine_handle<promise_type>::from_promise(*this)}; } std::suspend_always initial_suspend() noexcept { return {}; } std::suspend_always final_suspend() noexcept { return {}; } void return_void() {} void unhandled_exception() {} }; std::coroutine_handle<promise_type> h; bool next() { h.resume(); return !h.done(); }};
Gen gen(long n) { for (long i = 0; i < n; i++) co_yield static_cast<int>(i);}co_yield 每次都会暂停,h.resume() 是从暂停处继续。把 1 亿次 resume 和一个普通循环对比:
const long N = 100000000L;Gen g = gen(N);double t0 = now();for (long i = 0; i < N; i++) g.next(); /* 每次 next() 就是一次 resume */double t1 = now();/* (t1 - t0) / N 就是单次 resume 的秒数 */| 操作 | 每次耗时 |
|---|---|
| 协程 resume | 2.08 ns |
| 普通循环迭代 | 0.23 ns |
一次 resume 大约是一个循环迭代的 9 倍,但仍然是纳秒级。而且协程帧在堆上,一个 1 亿次循环的生成器只占一个帧。实测 100 万个挂起的协程帧,总共 68.8 MB,平均每个 72.2 字节。
co_await、co_yield、co_return 是 C++ 里仅有的三个”协程关键字”。任何函数只要出现其中任意一个,编译器就会把它当成协程改写。这也是 C++ 协程看起来”难”的原因:你看到的是普通函数,编译器看到的是一台状态机。
Python:从 yield 到 async/await 的十年
Python 的协程不是一蹴而就的,它是一步步长出来的:
yield(Python 2.2):生成器,函数可以在yield处暂停并保留局部状态;send()(PEP 342,2.5):可以把值送进暂停中的生成器,协程有了”双向通信”;yield from(PEP 380,3.3):可以把一个生成器的暂停委托给另一个,解决嵌套;async/await(PEP 492,3.5):给协程一套独立的语法,和生成器分开。
最后一步的底层,仍然是生成器那套机制。用 dis 反汇编一个 async 函数,能看到暂停是通过 YIELD_VALUE 实现的:
6 RETURN_GENERATOR POP_TOP L1: RESUME 0
7 LOAD_GLOBAL 0 (asyncio) LOAD_ATTR 2 (sleep) PUSH_NULL LOAD_SMALL_INT 0 CALL 1 GET_AWAITABLE 0 LOAD_CONST 1 (None) L2: SEND 3 (to L5) L3: YIELD_VALUE 1 L4: RESUME 3 JUMP_BACKWARD_NO_INTERRUPT 5 (to L2) L5: END_SEND POP_TOPGET_AWAITABLE 拿出被等待对象,SEND 驱动它,YIELD_VALUE 把控制权交还给事件循环,RESUME 是被唤醒后的入口。协程的”暂停”在字节码层面就是一次 yield。
代价对比很清楚:
| 操作 | 每次耗时 |
|---|---|
| 生成器 resume(纯协程切换) | 40 ns |
| asyncio 切换(经由事件循环) | 2.13 µs |
| asyncio 任务创建 + 运行 | 6.07 µs |
| 100 万挂起 Task 的内存 | 678.6 MB(每个 711.6 B) |
生成器 resume 只要 40 ns,而经过 asyncio 的 await 要 2.13 µs,差了 50 倍。差在哪?差在 Task、Future、事件循环的簿记:每次 await 都要经过事件循环的调度、回调入队、状态检查。真正”暂停一个函数”很便宜,让整个调度器转一圈不便宜。
单个 Task 要 712 字节,也比 C++ / Rust 的帧大得多,因为它同时挂了协程对象、Task 对象、回调列表等。100 万个 Task 要 679 MB,比 Rust 多两个数量级,但仍然远好于”100 万个线程”。
单线程上交错运行两个任务:
A 0B 0A 1B 1A 2B 2两个 worker 交替推进,因为它们都在 await asyncio.sleep(0) 处主动让出。这就是协作式调度:切换点由代码显式写出来,不像线程那样随时可能被抢占。
因为 asyncio 只用一个线程,GIL 对它不再是问题。协程的并行来自 I/O 的并发等待,而不是 CPU 的并行计算。CPU 密集的部分该用进程池还得用。
Rust:Future 就是状态机,运行时可以自己写
Rust 的 async fn 编译成一个实现了 Future 的状态机。Future 的定义只有一句:
pub trait Future { type Output; fn poll(self: Pin<&mut Self>, cx: &mut Context<'_>) -> Poll<Self::Output>;}每次 poll 返回 Ready(完成)或 Pending(未完成,稍后再问)。std 里没有任何执行器,所以一个不接运行时的 async fn 就是一块不会自己跑的代码。这反而给了我们一个机会:手写一个最小的执行器,看清协程到底是怎么被驱动的。
use std::task::{Context, Poll, RawWaker, RawWakerVTable, Waker};
const RAW: RawWaker = RawWaker::new(std::ptr::null(), &VTABLE);const VTABLE: RawWakerVTable = RawWakerVTable::new(|_| RAW, |_| {}, |_| {}, |_| {});
fn noop_waker() -> Waker { unsafe { Waker::from_raw(RAW) }}
/// 最小执行器:不接任何运行时,轮询到完成fn block_on<F: Future>(f: F) -> F::Output { let w = noop_waker(); let mut cx = Context::from_waker(&w); let mut f = Box::pin(f); loop { match f.as_mut().poll(&mut cx) { Poll::Ready(v) => return v, Poll::Pending => std::hint::spin_loop(), } }}配一个”每次 poll 都返回 Pending、直到第 N 次才 Ready”的 future,用上面这个 block_on 驱动,就能量出单次 poll 的成本:
struct Spin { n: u64, target: u64,}
impl Future for Spin { type Output = u64; fn poll(mut self: Pin<&mut Self>, cx: &mut Context<'_>) -> Poll<u64> { self.n += 1; if self.n >= self.target { Poll::Ready(self.n) } else { cx.waker().wake_by_ref(); Poll::Pending } }}
let t0 = Instant::now();block_on(Spin { n: 0, target: 100_000_000,});let per_poll = t0.elapsed().as_secs_f64() / 100_000_000.0;| 操作 | 每次耗时 |
|---|---|
Future::poll(空转执行器) | 14.8 ns |
一个 async fn 产生的 Future 大小 | 16 B |
| 100 万个挂起 Future 的内存 | 15.3 MB(每个 16 B) |
14.8 ns 比 C++ 的 2.08 ns 高一些,因为这里多了 waker 调用和 spin_loop,但仍然是纳秒级。
Future 的大小是编译期已知的,而且会随它跨 await 持有的状态增长:
async fn big() -> u8 { let buf = [0u8; 4096]; // 4 KiB 的局部数组 std::future::pending::<()>().await; // 永远挂起 buf[0]}
fn main() { let f = big(); println!("big future size = {} bytes", std::mem::size_of_val(&f));}输出:
big future size = 4097 bytes4096 字节的数组被原样放进了状态机帧。这说明一个反直觉但重要的事实:无栈协程的”栈”并没有消失,它变成了堆上这个编译期确定大小、按需分配的状态机帧。小帧 16 字节,大帧几 KB,取决于你跨 await 持有什么。
三个关键类型:Pin 保证帧在内存里不会移动(自引用安全),Waker 是”我先睡了,完事叫我”的回调,Context 把 waker 传给 poll。tokio 这类运行时做的事,就是提供一个高效的调度器,把这些 Future 多路复用到少量线程上。运行时不在 std 里,是 Rust 刻意的选择:标准库不替你做”用什么调度策略”的决定。
五、三层抽象放在一起
包含关系是这样的:协程跑在线程里,线程跑在进程里。调度层次也是嵌套的:内核调度进程和线程,运行时调度协程。
横向对比:
| 维度 | 进程 | 线程 | 协程(无栈) |
|---|---|---|---|
| 地址空间 | 独立 | 共享 | 共享 |
| 私有状态 | 全套 | 栈 + 寄存器 + TLS | 堆上一个状态机帧 |
| 谁调度 | 内核 | 内核 | 运行时(用户态) |
| 切换成本(实测) | 2.81 µs | 2.69 µs | 2 ns - 2 µs |
| 创建成本(实测) | 173 µs | 21-55 µs | 16-712 B / 个 |
| 数量级 | 几十到几百 | 几千到几万 | 几十万到几百万 |
| 通信 | IPC(要拷贝或映射) | 共享内存 + 同步原语 | 共享内存 + 运行时 |
| 隔离性 | 强 | 弱 | 弱 |
| 抢占 | 有 | 有 | 无(协作式) |
怎么选
- 要强隔离、要容错:进程。一个进程崩了,其他进程还在。浏览器标签页、数据库的多进程模型都是这个逻辑。
- 要真并行、共享数据:线程。CPU 密集、数据高度共享,用线程池。注意 Python 的这个选项要让位给多进程。
- 要海量并发、以 I/O 等待为主:协程。十万连接的服务器、爬虫、网关,协程几乎是唯一划算的模型。
- 不要在协程里跑 CPU 密集任务:它会霸占整个事件循环,把其他协程一起饿死。该扔给线程池或进程池。
一个常见反模式:在 asyncio 里调用同步的阻塞函数(比如 requests.get)。它会卡住整个事件循环,让所有协程停摆。要么换成异步库,要么显式扔进 run_in_executor。
六、怎么自己复现
# C / C++gcc -O2 -pthread bench_c.c -o bench_c && ./bench_cg++ -O2 -std=c++20 bench_cpp.cpp -o bench_cpp && ./bench_cpp
# Pythonpython3 bench_py.py
# Rust(无外部依赖)rustc --edition 2024 -O bench_rs.rs -o bench_rs && ./bench_rs进程间/线程间的管道往返测量,本质是 lmbench 里 lat_ctx 的思路:两个执行流绑在同一个核上,用一个字节来回交接,一次往返除以 2 就是单次切换。这个数字包含了系统调用开销,所以它是内核切换成本的一个上界;perf sched 能看到更纯粹的数字。
其他值得自己动手的工具:
taskset -c 0 ./program:把进程绑到某个核上,减少迁移带来的噪声;cat /proc/<pid>/status:看VmSize/VmRSS/Threads;ls /proc/<pid>/task:看这个进程里到底有几个”任务”;perf sched latency/perf sched record:看真实的调度延迟和切换。
七、往前看
我写完这三层,最大的感受是:并发模型的演进史,本质上是”把成本更高的抽象,换成成本更低的抽象”。先有进程(为了隔离,付全套虚拟化的代价),再有线程(为了共享,退掉地址空间隔离),最后有协程(为了数量,连内核调度和栈都退掉)。每一层都在用隔离性或调度能力,去换规模。
再往下走,我猜方向还是同一个。有几个正在发生的趋势:
- 结构化并发:让并发生命周期和词法作用域绑定,父任务负责回收子任务,解决”协程泄漏”和取消传播。Rust 的
tokio::task生态、Python 的TaskGroup、C++ 的std::execution都在往这个方向收。 - 内核态的异步 I/O:
io_uring把”提交一批 I/O、之后统一收割”做成了一次系统调用,进一步压低 I/O 密集场景下每个事件的成本。 - 把有栈协程的便利和无栈协程的可扩展性合起来:这是有栈 M
调度一直在尝试、但还没统一的问题。
如果只记一句:进程买隔离,线程买并行,协程买规模。搞清楚你现在缺的是哪一样,选型就不会错。
参考资料
本文参考了以下资料,排名无先后顺序:
- Timeline of operating systems - Wikipedia
- History of operating systems - Wikipedia
- ENIAC - Wikipedia
- First Draft of a Report on the EDVAC - Wikipedia
- GM-NAA I/O - Wikipedia
- Resident monitor - Wikipedia
- Multics - Wikipedia
- Unix - Wikipedia
- Task Control Block - Wikipedia
- Round-robin scheduling - Wikipedia
- clone(2) - Linux man page
- pthreads(7) - Linux man page
- PEP 492 - Coroutines with async and await syntax
- PEP 380 - Syntax for delegating to a subgenerator
- PEP 342 - Coroutines via Enhanced Generators
- C++ Coroutines: Understanding operator co_await
- std::future - Rust Standard Library
- The Rustonomicon: Send and Sync
- IBM OS/360 System Control Blocks (PDF)
附录:完整基准代码
下面是产出正文所有数字的完整程序。除标准库外无任何依赖,可以直接复制、编译、跑出你自己的数字。C / C++ 用 -O2,Rust 用 --edition 2024 -O,Python 直接用解释器。
A.1 C:进程 / 线程的创建、切换与内存(bench_c.c)
#define _GNU_SOURCE#include <pthread.h>#include <sched.h>#include <stdio.h>#include <stdlib.h>#include <string.h>#include <sys/wait.h>#include <time.h>#include <unistd.h>
static double now(void){ struct timespec ts; clock_gettime(CLOCK_MONOTONIC, &ts); return (double)ts.tv_sec + (double)ts.tv_nsec * 1e-9;}
/* 把自己绑到 0 号核,减少迁移噪声 */static void pin0(void){ cpu_set_t s; CPU_ZERO(&s); CPU_SET(0, &s); sched_setaffinity(0, sizeof s, &s);}
static void *nop(void *a){ (void)a; return NULL;}
static double bench_fork(int n){ double t0 = now(); for (int i = 0; i < n; i++) { pid_t p = fork(); if (p == 0) _exit(0); int st; waitpid(p, &st, 0); } return (now() - t0) / n;}
static double bench_thread(int n){ double t0 = now(); for (int i = 0; i < n; i++) { pthread_t t; pthread_create(&t, NULL, nop, NULL); pthread_join(t, NULL); } return (now() - t0) / n;}
/* two threads, same core, handing off one byte each way */static int pp_a[2], pp_b[2];static long pp_n;
static void *pp_peer(void *a){ (void)a; pin0(); char c; for (long i = 0; i < pp_n; i++) { if (read(pp_a[0], &c, 1) != 1) break; if (write(pp_b[1], &c, 1) != 1) break; } return NULL;}
static double bench_pp_thread(long n){ if (pipe(pp_a) || pipe(pp_b)) { perror("pipe"); exit(1); } pp_n = n; pthread_t t; pthread_create(&t, NULL, pp_peer, NULL); pin0(); char c = 'x'; double t0 = now(); for (long i = 0; i < n; i++) { if (write(pp_a[1], &c, 1) != 1) break; if (read(pp_b[0], &c, 1) != 1) break; } double dt = now() - t0; pthread_join(t, NULL); close(pp_a[0]); close(pp_a[1]); close(pp_b[0]); close(pp_b[1]); return dt / n / 2.0; /* two switches per round trip */}
static double bench_pp_proc(long n){ if (pipe(pp_a) || pipe(pp_b)) { perror("pipe"); exit(1); } pid_t pid = fork(); if (pid == 0) { pin0(); char c; for (long i = 0; i < n; i++) { if (read(pp_a[0], &c, 1) != 1) break; if (write(pp_b[1], &c, 1) != 1) break; } _exit(0); } pin0(); char c = 'x'; double t0 = now(); for (long i = 0; i < n; i++) { if (write(pp_a[1], &c, 1) != 1) break; if (read(pp_b[0], &c, 1) != 1) break; } double dt = now() - t0; int st; waitpid(pid, &st, 0); close(pp_a[0]); close(pp_a[1]); close(pp_b[0]); close(pp_b[1]); return dt / n / 2.0;}
/* 从 /proc/self/status 里读一个 KB 单位的字段 */static long vm(const char *field){ FILE *f = fopen("/proc/self/status", "r"); if (!f) return -1; char line[256]; long v = -1; size_t fl = strlen(field); while (fgets(line, sizeof line, f)) { if (!strncmp(line, field, fl)) { sscanf(line + fl, "%ld", &v); break; } } fclose(f); return v;}
static pthread_mutex_t g_mtx = PTHREAD_MUTEX_INITIALIZER;static pthread_cond_t g_cv = PTHREAD_COND_INITIALIZER;static int g_go = 0;
static void *waiter(void *a){ (void)a; pthread_mutex_lock(&g_mtx); while (!g_go) pthread_cond_wait(&g_cv, &g_mtx); pthread_mutex_unlock(&g_mtx); return NULL;}
static double best3(double (*fn)(int), int n){ double b = 1e18; for (int r = 0; r < 3; r++) { double v = fn(n); if (v < b) b = v; } return b;}
int main(void){ bench_fork(50); bench_thread(200);
printf("nproc,%ld\n", sysconf(_SC_NPROCESSORS_ONLN)); printf("fork_us,%.2f\n", best3(bench_fork, 2000) * 1e6); printf("pthread_create_join_us,%.2f\n", best3(bench_thread, 20000) * 1e6); printf("ctx_switch_thread_us,%.3f\n", bench_pp_thread(200000) * 1e6); printf("ctx_switch_process_us,%.3f\n", bench_pp_proc(50000) * 1e6);
pthread_attr_t attr; pthread_attr_init(&attr); size_t ss = 0; pthread_attr_getstacksize(&attr, &ss); printf("pthread_default_stack_kb,%zu\n", ss / 1024);
int NT = 2000; long v0 = vm("VmSize:"), r0 = vm("VmRSS:"); pthread_t *ts = malloc(sizeof(pthread_t) * NT); for (int i = 0; i < NT; i++) pthread_create(&ts[i], NULL, waiter, NULL); long v1 = vm("VmSize:"), r1 = vm("VmRSS:"); printf("threads,%d\n", NT); printf("vm_delta_per_thread_kb,%.1f\n", (double)(v1 - v0) / NT); printf("rss_delta_per_thread_kb,%.1f\n", (double)(r1 - r0) / NT); pthread_mutex_lock(&g_mtx); g_go = 1; pthread_cond_broadcast(&g_cv); pthread_mutex_unlock(&g_mtx); for (int i = 0; i < NT; i++) pthread_join(ts[i], NULL); free(ts); return 0;}编译运行:gcc -O2 -pthread bench_c.c -o bench_c && ./bench_c
A.2 C++:std::thread 与 C++20 协程(bench_cpp.cpp)
#include <chrono>#include <coroutine>#include <cstdint>#include <cstdio>#include <cstdlib>#include <cstring>#include <thread>#include <vector>
static double now(void) { using namespace std::chrono; return duration<double>(steady_clock::now().time_since_epoch()).count();}
static long vm(const char* field) { FILE* f = fopen("/proc/self/status", "r"); if (!f) return -1; char line[256]; long v = -1; size_t fl = strlen(field); while (fgets(line, sizeof line, f)) { if (!strncmp(line, field, fl)) { sscanf(line + fl, "%ld", &v); break; } } fclose(f); return v;}
static double bench_std_thread(int n) { double t0 = now(); for (int i = 0; i < n; i++) { std::thread t([]() {}); t.join(); } return (now() - t0) / n;}
/* 最小的无栈生成器;每次 next() 恢复一次协程帧 */struct Gen { struct promise_type { int value; std::suspend_always yield_value(int v) { value = v; return {}; } Gen get_return_object() { return Gen{std::coroutine_handle<promise_type>::from_promise(*this)}; } std::suspend_always initial_suspend() noexcept { return {}; } std::suspend_always final_suspend() noexcept { return {}; } void return_void() {} void unhandled_exception() {} }; std::coroutine_handle<promise_type> h; bool next() { h.resume(); return !h.done(); }};
static Gen gen(long n) { for (long i = 0; i < n; i++) co_yield static_cast<int>(i);}
int main(void) { bench_std_thread(200); printf("cpp_std_thread_create_join_us,%.2f\n", bench_std_thread(20000) * 1e6);
const long N = 100000000L; double t0 = now(); long c = 0; Gen g = gen(N); while (g.next()) c++; double t1 = now(); printf("cpp_coro_resumes,%ld\n", c); printf("cpp_coro_resume_ns,%.2f\n", (t1 - t0) / N * 1e9);
volatile long s = 0; double t2 = now(); for (long i = 0; i < N; i++) s += i; double t3 = now(); printf("cpp_plain_loop_ns,%.2f\n", (t3 - t2) / N * 1e9);
/* 大量挂起的协程帧:在堆上,不占线程栈 */ long r0 = vm("VmRSS:"); std::vector<std::coroutine_handle<Gen::promise_type>> v; v.reserve(100000); for (int i = 0; i < 100000; i++) v.push_back(gen(10).h); long r1 = vm("VmRSS:"); printf("cpp_suspended_coroutines,100000\n"); printf("cpp_frame_bytes_est,%.1f\n", (r1 - r0) * 1024.0 / 100000); for (auto h : v) h.destroy(); return 0;}编译运行:g++ -O2 -std=c++20 bench_cpp.cpp -o bench_cpp && ./bench_cpp
A.3 Python:线程 / GIL / asyncio / 生成器(bench_py.py)
import asyncioimport multiprocessingimport osimport sysimport threadingimport timefrom collections.abc import Callable, Iterator
N: int = 20_000_000
def now() -> float: return time.perf_counter()
def best3(fn: Callable[..., float], *args: int) -> float: best = float("inf") for _ in range(3): best = min(best, fn(*args)) return best
def thread_create_join(n: int) -> float: def nop() -> None: pass
t0 = now() for _ in range(n): t = threading.Thread(target=nop) t.start() t.join() return (now() - t0) / n
def burn(n: int) -> int: s = 0 for i in range(n): s += i * i return s
def gil_one() -> float: t0 = now() burn(N) return now() - t0
def gil_two_threads() -> float: t0 = now() ts = [threading.Thread(target=burn, args=(N,)) for _ in range(2)] for t in ts: t.start() for t in ts: t.join() return now() - t0
def gil_two_procs() -> float: t0 = now() ps = [multiprocessing.Process(target=burn, args=(N,)) for _ in range(2)] for p in ps: p.start() for p in ps: p.join() return now() - t0
async def _step() -> int: return 1
async def _tight(n: int) -> None: for _ in range(n): await asyncio.sleep(0)
async def _gather(n: int) -> None: await asyncio.gather(*(_step() for _ in range(n)))
def asyncio_tasks(n: int) -> float: t0 = now() asyncio.run(_gather(n)) return now() - t0
def gen_resume(n: int) -> float: def gen(k: int) -> Iterator[int]: for i in range(k): yield i
g = gen(n) t0 = now() c = 0 for _ in g: c += 1 return (now() - t0) / c
def main() -> None: thread_create_join(200) print("python,cpu_count,%d" % (os.cpu_count() or 1)) print("python,switch_interval_s,%.4f" % sys.getswitchinterval()) print( "python,thread_create_join_us,%.2f" % (best3(thread_create_join, 20000) * 1e6) )
one = best3(gil_one) two = best3(gil_two_threads) mp = best3(gil_two_procs) print("python,burn_1thread_s,%.3f" % one) print("python,burn_2threads_s,%.3f" % two) print("python,burn_2procs_s,%.3f" % mp) print("python,gil_speedup_2threads,%.2fx" % (one * 2 / two)) print("python,mp_speedup_2procs,%.2fx" % (one * 2 / mp))
asyncio.run(_tight(1000)) ns = 2_000_000 t0 = now() asyncio.run(_tight(ns)) dt = now() - t0 print("python,asyncio_await_switch_ns,%.1f" % (dt / ns * 1e9))
nt = 200_000 dt = asyncio_tasks(nt) print("python,asyncio_task_create_run_us,%.3f" % (dt / nt * 1e6))
print( "python,generator_resume_ns,%.1f" % (best3(gen_resume, 50_000_000) * 1e9) )
if __name__ == "__main__": main()运行:python3 bench_py.py
A.4 Rust:std::thread 与零依赖执行器(bench_rs.rs)
use std::pin::Pin;use std::sync::{Arc, Barrier};use std::task::{Context, Poll, RawWaker, RawWakerVTable, Waker};use std::time::Instant;use std::{mem, thread};
const RAW: RawWaker = RawWaker::new(std::ptr::null(), &VTABLE);const VTABLE: RawWakerVTable = RawWakerVTable::new(|_| RAW, |_| {}, |_| {}, |_| {});
fn noop_waker() -> Waker { // SAFETY: vtable 里的函数不会解引用那个空数据指针 unsafe { Waker::from_raw(RAW) }}
/// 最小执行器:不接任何运行时,轮询到完成fn block_on<F: Future>(f: F) -> F::Output { let w = noop_waker(); let mut cx = Context::from_waker(&w); let mut f = Box::pin(f); loop { match f.as_mut().poll(&mut cx) { Poll::Ready(v) => return v, Poll::Pending => std::hint::spin_loop(), } }}
/// 返回 target 次 Pending,然后 Readystruct Spin { n: u64, target: u64,}
impl Future for Spin { type Output = u64; fn poll(mut self: Pin<&mut Self>, cx: &mut Context<'_>) -> Poll<u64> { self.n += 1; if self.n >= self.target { Poll::Ready(self.n) } else { cx.waker().wake_by_ref(); Poll::Pending } }}
async fn leaf(x: u64) -> u64 { x.wrapping_add(1)}
fn bench_thread(n: usize) -> f64 { let t0 = Instant::now(); for _ in 0..n { thread::spawn(|| {}).join().unwrap(); } t0.elapsed().as_secs_f64() / n as f64}
fn vm(field: &str) -> i64 { let s = std::fs::read_to_string("/proc/self/status").unwrap_or_default(); for l in s.lines() { if let Some(r) = l.strip_prefix(field) { if let Some(tok) = r.split_whitespace().next() { if let Ok(v) = tok.parse() { return v; } } } } -1}
fn main() { bench_thread(200); let mut best = f64::MAX; for _ in 0..3 { let v = bench_thread(20000); if v < best { best = v; } } println!("rs_thread_create_join_us,{:.2}", best * 1e6);
// 手动 block_on,没有运行时 let val = block_on(leaf(41)); println!("rs_block_on_value,{}", val);
const N: u64 = 100_000_000; let t0 = Instant::now(); let r = block_on(Spin { n: 0, target: N }); let dt = t0.elapsed().as_secs_f64(); println!("rs_polls,{}", r); println!("rs_poll_ns,{:.2}", dt / N as f64 * 1e9);
let f = leaf(1); println!("rs_future_size_bytes,{}", mem::size_of_val(&f)); println!("rs_spin_size_bytes,{}", mem::size_of::<Spin>());
// 10 万个从未 poll 过的 Future,只算它们的内部状态 let vs: Vec<_> = (0..100_000u64).map(leaf).collect(); let total: usize = vs.iter().map(|f| mem::size_of_val(f)).sum(); println!("rs_100k_futures_bytes,{}", total);
// 线程:每个默认预留 2 MiB 栈 const NT: usize = 2000; let barrier = Arc::new(Barrier::new(NT + 1)); let v0 = vm("VmSize:"); let r0 = vm("VmRSS:"); let handles: Vec<_> = (0..NT) .map(|_| { let b = barrier.clone(); thread::spawn(move || { b.wait(); }) }) .collect(); let v1 = vm("VmSize:"); let r1 = vm("VmRSS:"); println!("rs_vm_per_thread_kb,{:.1}", (v1 - v0) as f64 / NT as f64); println!("rs_rss_per_thread_kb,{:.1}", (r1 - r0) as f64 / NT as f64); barrier.wait(); for h in handles { h.join().unwrap(); }}编译运行(edition 2024 的 prelude 已含 Future):rustc --edition 2024 -O bench_rs.rs -o bench_rs && ./bench_rs
A.5 百万级内存测试
C++:100 万个挂起的协程帧,读 VmHWM(峰值常驻)算差值。
#include <coroutine>#include <cstdio>#include <cstring>#include <vector>
static long vm(const char* field) { FILE* f = fopen("/proc/self/status", "r"); if (!f) return -1; char line[256]; long v = -1; size_t fl = strlen(field); while (fgets(line, sizeof line, f)) { if (!strncmp(line, field, fl)) { sscanf(line + fl, "%ld", &v); break; } } fclose(f); return v;}
struct Gen { struct promise_type { int value; std::suspend_always yield_value(int v) { value = v; return {}; } Gen get_return_object() { return Gen{std::coroutine_handle<promise_type>::from_promise(*this)}; } std::suspend_always initial_suspend() noexcept { return {}; } std::suspend_always final_suspend() noexcept { return {}; } void return_void() {} void unhandled_exception() {} }; std::coroutine_handle<promise_type> h;};
static Gen gen(long n) { for (long i = 0; i < n; i++) co_yield static_cast<int>(i);}
int main() { const int N = 1000000; long h0 = vm("VmHWM:"); std::vector<std::coroutine_handle<Gen::promise_type>> v; v.reserve(N); for (int i = 0; i < N; i++) v.push_back(gen(10).h); long h1 = vm("VmHWM:"); printf("cpp_peak_delta_mb,%.1f\n", (h1 - h0) / 1024.0); printf("cpp_bytes_each,%.1f\n", (h1 - h0) * 1024.0 / N); for (auto h : v) h.destroy(); return 0;}Rust:100 万个 Future,同时看 sizeof 的精确总量。
async fn leaf(x: u64) -> u64 { x.wrapping_add(1)}
fn vm(field: &str) -> i64 { let s = std::fs::read_to_string("/proc/self/status").unwrap_or_default(); for l in s.lines() { if let Some(r) = l.strip_prefix(field) { if let Some(tok) = r.split_whitespace().next() { if let Ok(v) = tok.parse() { return v; } } } } -1}
fn main() { const N: u64 = 1_000_000; let h0 = vm("VmHWM:"); let vs: Vec<_> = (0..N).map(leaf).collect(); let h1 = vm("VmHWM:"); let total = std::mem::size_of_val(vs.as_slice()); println!("rs_peak_delta_mb,{:.1}", (h1 - h0) as f64 / 1024.0); println!("rs_bytes_each,{:.1}", (h1 - h0) as f64 * 1024.0 / N as f64); println!("rs_sizeof_total_mb,{:.1}", total as f64 / 1024.0 / 1024.0); println!("rs_sizeof_each,{}", total / N as usize);}Python:100 万个真正挂起(等待同一个 Event)的 asyncio Task,量峰值内存。
import asyncio
def vm(field: str) -> int: with open("/proc/self/status") as f: for line in f: if line.startswith(field): return int(line.split()[1]) return -1
async def wait_forever(ev: asyncio.Event) -> None: await ev.wait()
async def main(n: int) -> None: base = vm("VmHWM:") ev = asyncio.Event() tasks = [asyncio.create_task(wait_forever(ev)) for _ in range(n)] peak = vm("VmHWM:") print("py_tasks,%d" % n) print("py_peak_delta_mb,%.1f" % ((peak - base) / 1024.0)) print("py_bytes_each,%.1f" % ((peak - base) * 1024.0 / n)) for t in tasks: t.cancel() await asyncio.gather(*tasks, return_exceptions=True)
asyncio.run(main(1_000_000))支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!